
Ajatusjohtajat
AI-kirjoitetun koodin on muuttanut SAST:n tarpeita

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa
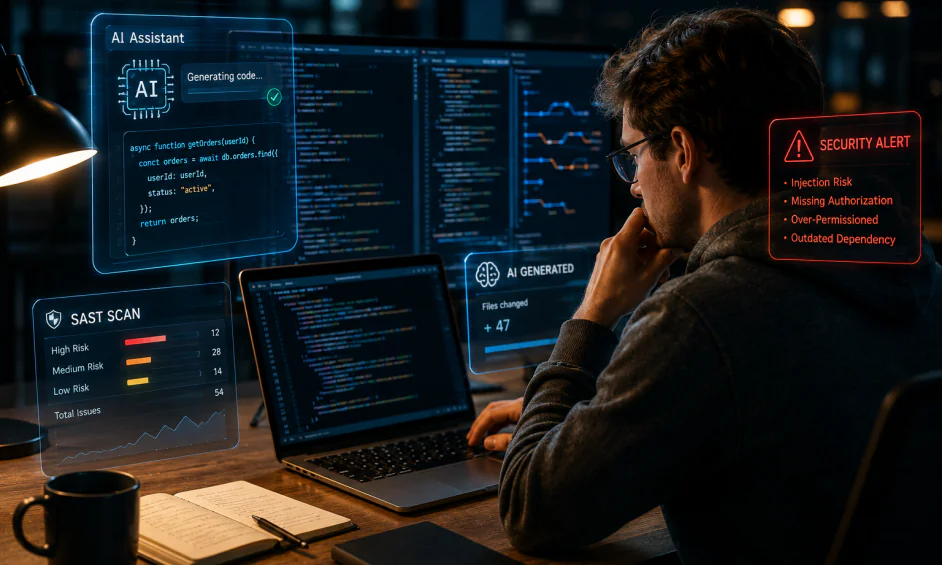
Katsoa, kun AI-koodausavustaja luo toimivan ominaisuuden sekunneissa, voi tuntua läpimurrolta. Koodi kääntyy. Testit menevät läpi. Pull-pyynnön näyttää puhdas. Kehitystiimille, jotka ovat painostettuina toimittamaan nopeammin, se tuntuu edistymisenä.
mutta toimiva koodi ja turvallinen koodi eivät ole sama asia.
AI-koodi on muuttanut ohjelmistoriskin muodon. Ongelma ei ole vain se, että suuret kielen mallit kirjoittavat “huonoa” koodia. Monissa tapauksissa ne kirjoittavat koodia, joka näyttää kiillotetulta, seuraa tuttua kehysmallia ja ratkaisee pyydetyssä tehtävässä. Ongelma on hienovaraisempi: koodi voi olla toiminnallisesti oikein, mutta silti turvaton, vanhentunut, yli-osoitettu tai kontekstuaalisesti väärä.
Tämä ero on tärkeä, koska staattinen sovellusturvallisuustestaus (SAST) on rakennettu maailmaan, jossa kehittäjät kirjoittavat koodia ihmisen nopeudella ja turvallisuustiimit tarkastavat ennustettavia riskin malleja. AI on muuttanut molemmat puolet tätä yhtälöä. Koodin määrä kasvaa, commitit ovat pienempiä, ja turvattomat mallit voidaan nyt luoda laajassa mittakaavassa.
Tuloksena on uusi kysymys ohjelmistotiimeille: mitä SAST:n pitäisi havaita, kun koodin kirjoittaja ei välttämättä ole ihminen?
Toimiva koodi ei ole enää vahva signaali
Vuosiin, ohjelmistotiimit ovat käyttäneet karkeaa luottamuksen hierarkiaa. Jos koodi kääntyi, meni läpi testit ja selvisi vertaisarvioinnista, se siirtyi lähemmäs tuotantoon. Turvallisuustarkastus lisäsi toisen kerroksen, mutta toimivuus säilyi ensisijaisena porttina.
AI-koodausavustajat rikkovat tämän hierarkian, koska ne ovat erityisen hyviä tuottamaan koodia, joka näyttää valmiilta. Ne voivat johtaa kattavat osat, liittää API:ja, luoda virheenkäsittelyä ja vastata tyyliin olemassa olevasta varastosta. Tämä tekee niistä hyödyllisiä, mutta se myös tekee virheistä vaikeammin havaittavissa.
Ihmisen arvioija voi vilkaista AI-kirjoitetun funktion ja ajatella: “Tämä näyttää normaalilta.” Se on juuri riski. Monet AI-kirjoitetut haavoittuvuudet eivät ole eksoottisia. Ne ovat tuttuja ongelmia, kuten injektiovirheitä, heikkoja validoita, turvattomia oletusarvoja, epäturvallisia deserialisointeja, lokausongelmia ja vanhentuneita riippuvuusvalintoja.
Viimeaikaiset tutkimukset ovat tehneet tästä jännityksestä vaikeammin väistettävissä. Veracoden Spring 2026 GenAI Code Security Update esimerkiksi totesi, että AI-koodausmallit olivat tulleet paljon vahvemmiksi tuottamaan syntaktisesti oikein koodia kuin turvallista koodia. Toisin sanoen, AI on tulossa hyvin hyväksi kirjoittamaan ohjelmistoja, jotka toimivat, mutta se ei tarkoita, että se on tulossa yhtä hyväksi kirjoittamaan ohjelmistoja, joita voidaan luottaa.
Tulos voi näyttää tuotantovalmiilta, mutta perustavanlaatuinen riski voi olla täysin erilainen.
Vanha SAST-malli on rakennettu ihmiskorkojen ympärille
Perinteinen SAST on aina ollut vaikea tehtävä. Se skannaa lähdekoodia, kartoittaa malleja tunnettujiin heikkouksiin ja hälyttää tiimejä ennen kuin haavoittuvaa koodia toimitetaan. Perinteisessä kehityssyklissä se luo jo kitkaa: liian monta hälytystä, liian monta väärää positiivista ja ei riittävästi aikaa korjata kaikkea.
AI tekee tämän vaikeammaksi poistamalla yhden piilevän rajoituksen ohjelmistokehityksestä: ihmisen kirjoittamisen nopeuden.
Kun AI-avustaja voi luoda palvelun, testitiedoston, API-integraation ja konfiguraatiolohkon yhdessä istunnossa, turvallisuuden tarkastus ei voi luottaa samaan oletukseen. Riski ei ole yksittäinen laiskasti kirjoitettu koodirivi. Se on todennäköisen koodin moninkertaistuminen kymmenissä tiedostoissa, joissa jokaisessa malli tekee pieniä päätöksiä tiimin puolesta.
Tässä modernit SAST-työkalut tarvitsevat kehittyä. Ne eivät voi vain skannata tunnettuja haavoittuvuuksien malleja, kun pull-pyynnön on melkein valmis. Ne tarvitsevat toimia lähempänä kehittäjien työvirran ympärillä, ymmärtää AI-tukea muutospatterneja ja auttaa tiimejä erottamaan vaarattoman automaation vaarallisesta automaatiosta.
AI tuo turvallisuuden velan koneen nopeudella
Tekninen velka ei ole uusi. Turvallisuuden velka on vaarallisempi sukulainen: se kertyy, kun haavoittuvuudet, heikot oletukset ja riskilliset lyhenteet säilytetään koodipohjassa, koska ne eivät ole tarpeeksi kiireellisiä korjata tänään.
AI voi kiihdyttää tätä prosessia.
Kehittäjä voi pyytää avustajaa “lisäämään todennuksen”, “puhdistamaan tämän syötteen” tai “liittämään tämän päätepisteen tietokantaan.” Malli tuottaa yleensä vastauksen. Mutta jos ohjeistus ei sisällä oikeita turvallisuusrajoituksia, vastaus voi nojata vanhanaikaisiin käytäntöihin, epätäydelliseen validointiin tai turvattomiin oletusarvoihin. Pahimmassa tapauksessa se voi olla tarpeeksi hyvä meneeksi läpi hölmön tarkastuksen.
On useita AI-spesifejä malleja, joita SAST:n on nyt havaittava:
- Turvalta näyttävä kattava osa: AI usein tuottaa koodia, joka muistuttaa parasta käytäntöä, mutta puuttuu yksi tärkeä valvonta, kuten valtuutus- tai tulostuskoodeja.
- Vanhentuneet riippuvuus-oletukset: Malli voi ehdottaa kirjastoja, versioita tai API:ja, jotka perustuvat malleihin, jotka olivat yleisiä sen koulutusaineistossa, mutta eivät enää suositella.
- Kontekstivapaa korjaus: AI voi korjata paikallisen oireen ilman ymmärrystä laajemmasta sovellusvirrasta, mikä luo turvallisuusaukkoja muualla.
- Toistuva haavoittuvainen malli: Jos sama ohjeistus tuottaa saman virheellisen mallin useissa varastoissa, yksi heikkous voi hiljalleen leviä koko organisaatiossa.
Tämä ei ole vain huonon koodin etsintää. Se on koodin tunnistamista, jota ei ole tuotettu riittävän kontekstin kanssa.
SAST:n on ymmärrettävä aikomus, ei vain syntaksi
Seuraavan sukupolven SAST:n on siirryttävä yksinkertaisen mallin tunnistamisen ulkopuolelle. Tunnetut haavoittuvuusmallit ovat edelleen tärkeitä, ja monet perusvirheet pitäisi havaita automaattisesti. Mutta AI-kirjoitetun koodin nostaa baarin, koska syntaksi yksin harvoin kertoo koko tarinan.
Otetaan esimerkksi päätepiste, joka noutaa asiakastietoja. Koodi voi käyttää parametroituja kyselyjä, käsitellä virheitä oikein ja menee läpi standardien injektio-testit. Mutta pakottaa se vuokraajan eristystä? Pakottaa se, onko nykyinen käyttäjä sallittu päästä pyydetyyn tietueeseen? Pakottaa se, onko herkkä data lokattu?
Tämä muutos herättää myös yksityisyyden kysymyksen: jos AI-kirjoitettu logiikka muuttaa sovelluksen tallentamaa, lokittamaa tai paljastamaa tietoa, tiimien on ymmärrettävä sen sovelluksen tietojen keräämisen käyttäytymistä osana turvallisuuden tarkastusta.
Nämä eivät välttämättä ole syntaksiongelmia. Ne ovat aikomuksen ongelmat.
SAST:n on oltava tietoinen liiketoimintalogiikasta, datavirrasta, kehysmallien konventioista ja suhteesta muutoksen ja sovelluksen loppuosan välillä. Tavoitteena ei ole tehdä SAST:sta “AI-virtaista” markkinointitarkoituksiin. Tavoitteena on tehdä siitä kontekstiaavistavaa tarpeeksi, jotta se voi havaita virheitä, joita AI on todennäköisesti tekemässä.
Kehittäjien on edelleen opittava turvallisuutta, mutta toisin
Paremmat työkalut auttavat, mutta ne eivät poista ihmisen vastuuta. AI-koodausavustajat tekevät kehittäjistä tuottavampia, mutta ne myös tekevät siitä helpommaksi tiimille hyväksyä koodia, jota he eivät täysin ymmärrä.
Se luo koulutushaasteen. Perinteinen vuotuinen turvallisuuskoulutus on liian hidas ja liian irtiin päivittäisestä työstä. Kehittäjien on opittava lyhyet, käytännölliset oppitunnit lähellä hetkeä, jolloin he tekevät päätöksiä. Tässä mikrooppiminen tulee asiaan: pienet, kohdennetut oppimishetket voivat vahvistaa turvallisen koodauksen tapoja ilman, että insinöörit joutuvat poistumaan työvirrastaan useiksi tunteja.
Paras turvallisuuskoulutus AI-koodausaikakaudella näyttää vähemmän luokkahuoneelta ja enemmän ajoittaiselta selitykseltä pull-pyynnön sisällä, IDE-varoitukselta, joka opettaa sen sijaan, että se häiritsisi, tai lyhyeltä korjausmuistiinpanolta, joka selittää, miksi AI-kirjoitettu malli on riskiallinen.
Arviointiprosessi on muutettava
Koodin arviointi on vastannut tuttuja kysymyksiä: Onko koodi luettavaa? Ratkaiseeko se ongelman? Rikkoiko se mitään?
AI-kirjoitettu koodi lisää uusia kysymyksiä. Oliko ohjeistus turvallisuuden tietoinen? Esittikö malli riippuvuuden? Kopioi malli patterin muualta varastosta ilman ymmärrystä, miksi se patteri oli olemassa? Varmisti kehittäjä logiikan vai vain tulosteen?
Tämä ei tarkoita, että jokaisen AI-tukeen perustuvan commitin tarvitsee olla forensinen tutkinta. Mutta tiimien on oltava olemassa kevyt tapa tunnistaa korkea-riskiset AI-kirjoitetut muutokset. Todennus, valtuutus, salaus, maksuvirrat, tiedostoliittäminen, tietokantayhteys, lokitus ja infrastruktuurin konfiguraatio ansaitsevat enemmän tarkastelua kuin UI-kopio tai testikehys.
Lopputulos
AI ei tee SAST:sta merkityksettömäksi. Se tekee SAST:sta tärkeämmän.
Kun koodin generointi tulee nopeammaksi ja syvemmin kehitysympäristöihin upotettuna, vanha oletus, että turvaton koodi tulee hitaasti ihmisten kautta, ei enää pidä. AI voi tuottaa hyödyllistä ohjelmistoa, mutta se voi myös skaalata heikkoja malleja, vanhentuneita oletuksia ja kontekstivapaita korjauksia nopeammin kuin perinteiset tarkastusprosessit voivat absorboida.
Voittajat eivät ole tiimit, jotka kieltävät AI-koodausvälineet. Voittajat ovat tiimit, jotka suunnittelevat uudelleen turvallisuustyövirran uuden todellisuuden ympärille: koodi voidaan generoida välittömästi, mutta luottamus on edelleen ansaittava.
SAST:n on nyt havaittava enemmän kuin vain syntaksitason virheet. Se on havaittava puuttuvaa aikomusta, turvattomia konteksteja, toistuvia AI-malleja ja turvallisuuden velkaa ennen kuin se kertyy.


