
Andersonin kulma
Esineiden poistaminen videosta tehokkaammin koneoppimisen avulla

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa
Keskeiset kohdatE2FGVI yhdistää kolme videon täyttövaihetta yhdeksi päästä päähän -järjestelmäksi, mikä…
Näytä lisää
- E2FGVI yhdistää kolme videon täyttövaihetta yhdeksi päästä päähän -järjestelmäksi, mikä tuo merkittäviä tehokkuusparannuksia.
- Järjestelmä toimii viisitoista kertaa nopeammin kuin aiemmat optisen virtauksen menetelmät ja saavuttaa samalla huippuluokan tulokset.
- Uusi ajallinen fokaalimuunnin laajentaa huomion 2D:stä 3D:hen mahdollistaen koherentin sisällön hallusinoinnin kuvakehysten välillä.
Uusi kiinalainen tutkimus raportoi alan parhaita tuloksia sekä huomattavan parannuksen tehokkuudessa uudelle videontäydennysjärjestelmälle, joka poistaa kohteita videomateriaalista taitavasti.
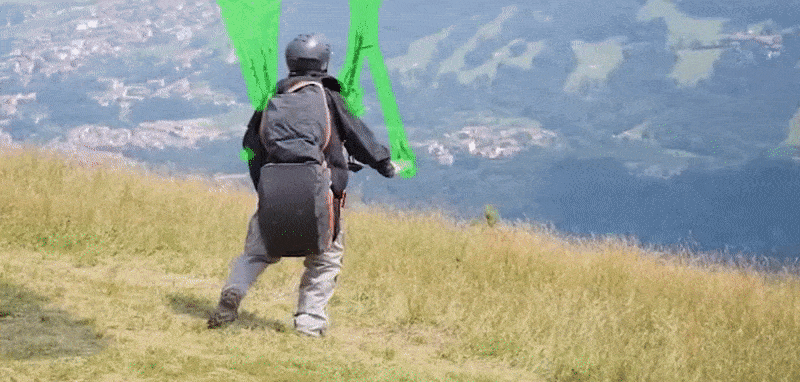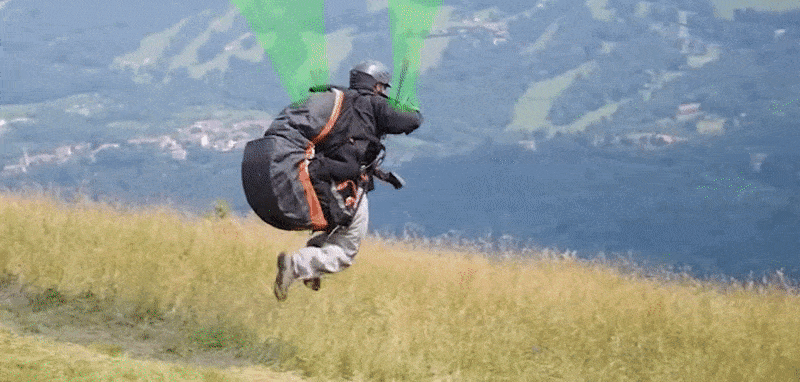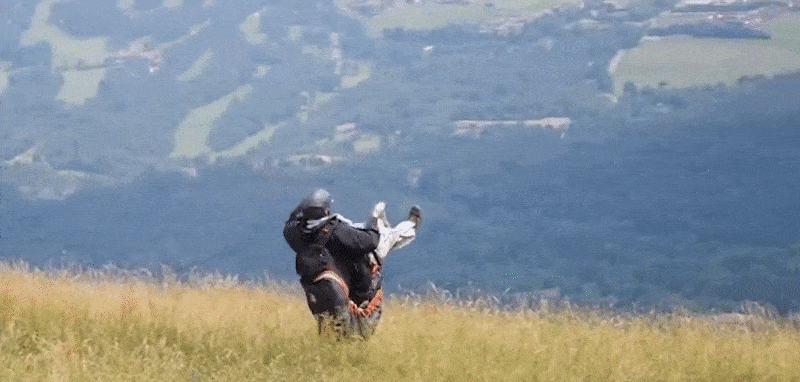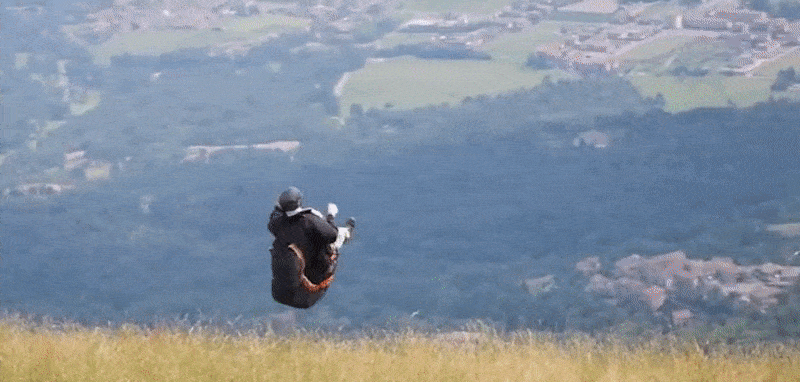
Riippuliitäjän valjaiden poistaminen uudella menetelmällä. Katso lähdevideo paremman resoluution ja enemmän esimerkkejä varten. Lähde: https://www.youtube.com/watch?v=N–qC3T2wc4
Menetelmä, jota kutsutaan End-to-End-kehykseksi Flow-Guided-videon korjaamiseen (E2FGVI), pystyy myös poistamaan vesileimat ja muita tyyppisiä peittäviä kappaleita videomateriaalista.
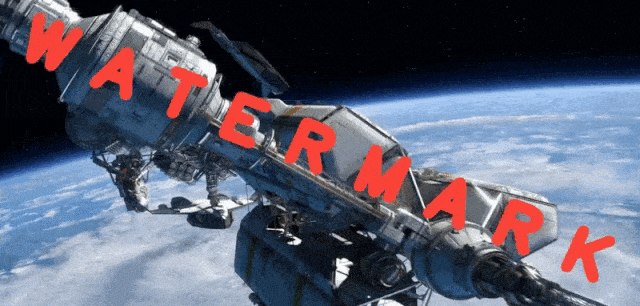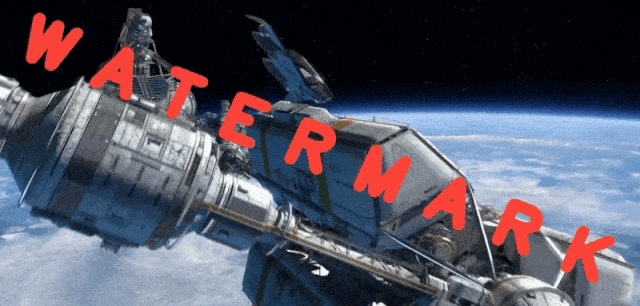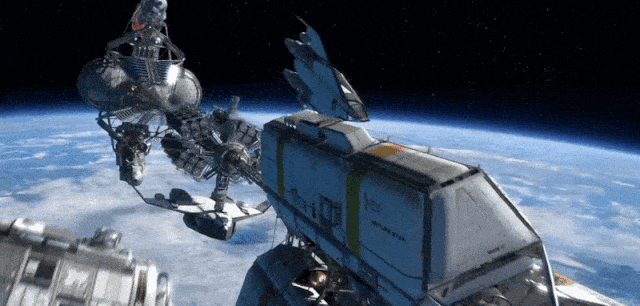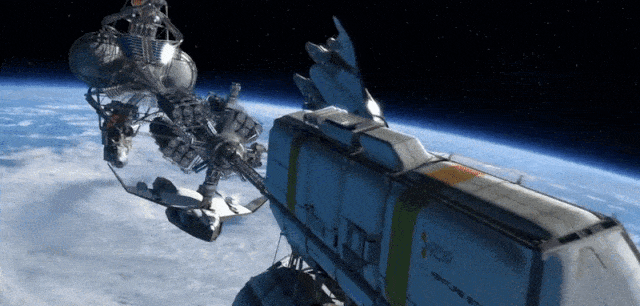
E2FGVI laskee ennusteita peittävien kohteiden takana olevalle sisällölle, mahdollistaen jopa huomattavien ja vaikeiden vesileimojen poistamisen. Lähde: https://github.com/MCG-NKU/E2FGVI
(Katso lisää esimerkkejä paremmassa resoluutiossa tästä videosta)
Vaikka malli, josta julkaistu tutkimus kertoo, oli koulutettu 432px x 240px videomateriaalilla (yleensä matalat syötekoot, rajoitettu saatavilla olevan GPU-tilan vuoksi verrattuna optimaalisiin batch-kokoihin ja muihin tekijöihin), tutkijat ovat julkaisseet E2FGVI-HQ:n, joka pystyy käsittelemään videoita mielivaltaisessa resoluutiossa.
Koodi nykyisestä versiosta on saatavilla GitHubissa, kun taas HQ-versio, joka julkaistiin viime sunnuntaina, voidaan ladata Google Drivesta ja Baidu Diskistä.

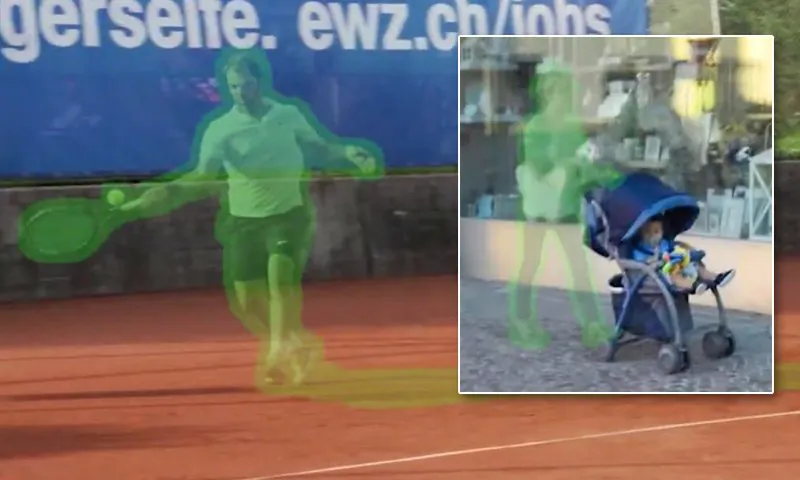
Lapsi pysyy kuvassa.
E2FGVI pystyy käsittelemään 432×240-videota 0,12 sekunnissa per ruutu Titan XP GPU:lla (12GB VRAM), ja tutkijat raportoivat, että järjestelmä toimii viisitoista kertaa nopeammin kuin aiemmat alan parhaat menetelmät, jotka perustuvat optiseen virtaukseen.
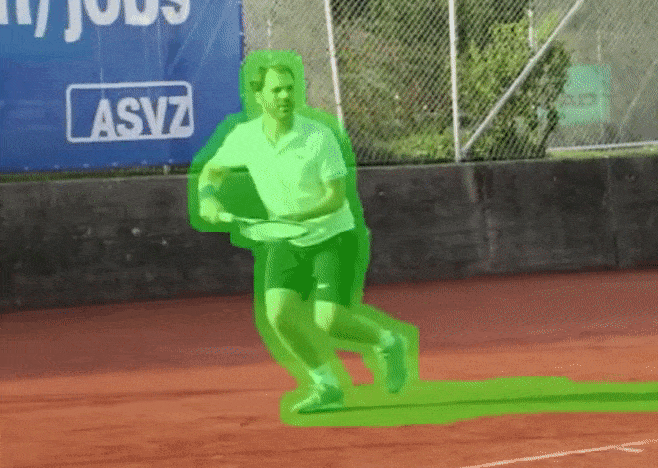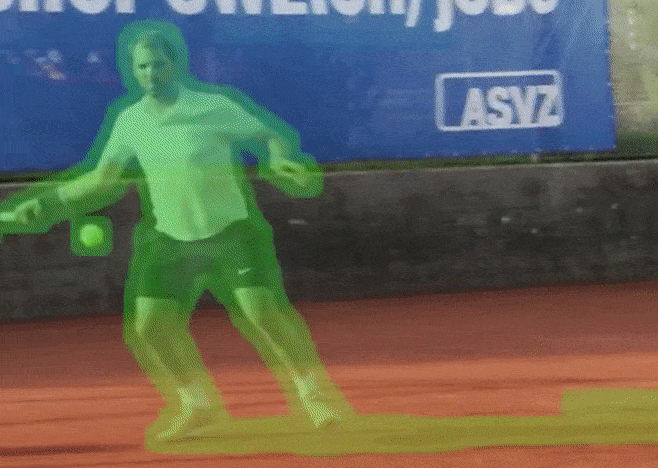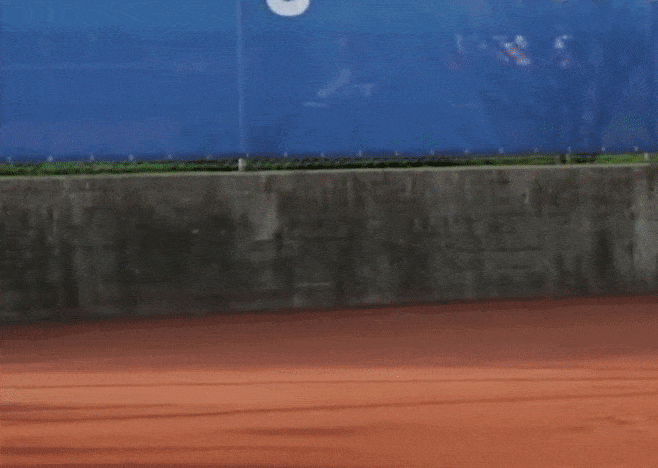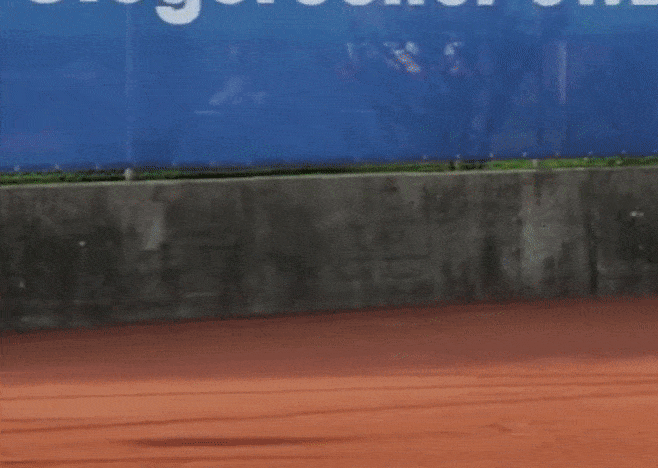
Tennispelaaja tekee odottamattoman poistumisen.
Kun uutta menetelmää testattiin tämän kuvansynteesin tutkimusalueen tavanomaisilla tietoaineistoilla, se päihitti kilpailijansa sekä laadullisissa että määrällisissä arviointikierroksissa.

Testit aiempiin lähestymistapoihin. Lähde: https://arxiv.org/pdf/2204.02663.pdf
Tutkimusraportin otsikko on Towards An End-to-End Framework for Flow-Guided Video Inpainting, ja se on yhteistyö neljän Nankai-yliopiston tutkijan ja yhden Hisilicon Technologiesin tutkijan välillä.
Mitä puuttuu tästä kuvasta
Ilmeisten visuaalisiin tehosteisiin liittyvien sovellustensa lisäksi korkealaatuisesta videon täydentämisestä on tulossa uusien tekoälypohjaisten kuvansynteesi- ja kuvanmuokkausteknologioiden keskeinen ominaisuus.
Tämä koskee erityisesti kehon muotoa muuttavia muotisovelluksia ja muiden kehyksien kohdalla, jotka pyrkivät ”hoikentamaan” tai muuten muokkaamaan kohtauksia kuvissa ja videoissa. Näissä tapauksissa on välttämätöntä “täyttää” taustaa, joka paljastuu synteesin seurauksena.

Tuoreessa tutkimuksessa kehon muotoa muuttavan algoritmin tehtävänä on täydentää näkyviin tuleva tausta, kun kohteen kokoa muutetaan. Tässä puuttuva alue näkyy punaisena ääriviivana kohdassa, jossa todellinen, täyteläisempi henkilö aiemmin oli (katso vasemmanpuoleinen kuva). Perustuu lähdeaineistoon https://arxiv.org/pdf/2203.10496.pdf
Koherentti optinen virtaus
Optisesta virtauksesta (OF) on tullut keskeinen teknologia kohteiden poistamisessa videoista. Kuten atlas, OF tuottaa ajallisesta kuvasarjasta kartan yhdellä kertaa. Usein käytetty mittaamaan nopeutta konenäkösovelluksissa, OF voi myös mahdollistaa ajallisesti johdonmukaisen täydentämisen, jossa koko tehtävä voidaan käsitellä yhdellä läpikäynnillä, sen sijaan, että se tehtäisiin Disney-tyylisesti “ruutu kerrallaan”, mikä johtaa väistämättä ajalliseen epäjatkuvuuteen.
Videon korjausmenetelmät ovat toistaiseksi keskittyneet kolmeen vaiheeseen: virtauskorjaus, jossa video kartoitetaan erilliseksi, tutkittavaksi kokonaisuudeksi; pikselien eteneminen, jossa “vahingoittuneiden” videoiden aukot täytetään levittämällä pikseleitä kahteen suuntaan; ja sisällön hallusinointi (pikselien “keksiminen”, joka on tuttu useimmille meistä deepfake- ja teksti-kuvaksi-kehyksistä, kuten DALL-E-sarja), jossa arvioitu “puuttuva” sisältö keksitään ja lisätään videoon.
E2FGVI:n keskeinen innovaatio on yhdistää nämä kolme vaihetta päästä päähän toimivaksi järjestelmäksi, poistamalla tarpeen manuaalisille toimille sisällön tai prosessin kanssa.

Tutkimusraportti toteaa, että tarve manuaaliseen väliintuloon edellyttää, että vanhemmat prosessit eivät hyödy GPU:sta, mikä tekee niistä hyvin aikaa vieviä. Tutkimusraportista*:
‘Otetaan esimerkiksi DFVI, yhden videon korjaaminen, joka on 432 × 240 kokoinen DAVIS:sta, joka sisältää noin 70 ruutua, vaatii noin 4 minuuttia, mikä on mahdotonta hyväksyä useimmissa todellisissa sovelluksissa. Lisäksi edellä mainittujen huonojen puolien lisäksi, pelkän esikoulutetun kuvantäydennysverkon käyttö sisällön hallusinointivaiheessa jättää huomiotta ajallisesti vierekkäisten kuvien sisältöjen suhteet ja johtaa videoissa epäjohdonmukaiseen tuotettuun sisältöön.’
E2FGVI:n yhdistäessä videon korjaamisen kolme vaihetta, se pystyy korvaamaan toisen vaiheen, pikselien levittämisen, piirteiden levittämisellä. Aiemmissa tutkimuksissa, joissa prosessi on jaettu erillisiin osiin, piirteet eivät ole yhtä laajasti käytettävissä: kukin vaihe on suhteellisen suljettu ja työnkulku on vain puoliautomaattinen.
Lisäksi tutkijat ovat keksineet ajallisesti fokusoivan transformer-mallin sisällön keksimisvaiheessa, joka ottaa huomioon ei vain nykyisen ruudun pikselien välittömiä ajallisia naapureita (ts. mitä tapahtuu kyseisessä osassa ruutua edellisessä tai seuraavassa kuvassa), vaan myös kaukaiset naapurit, jotka ovat useita ruutuja etäällä, ja jotka kuitenkin vaikuttavat videon kokonaisvaikutukseen.

E2FGVI:n arkkitehtuuri.
Uusi piirrepohjainen keskivaihe työnkulussa pystyy hyödyntämään enemmän piirretason prosesseja ja opittavia näytteenoton siirtymiä, kun taas hankkeen uusi fokusoiva transformer, tutkijoiden mukaan, laajentaa fokusoivien ikkunoiden kokoa “2D:stä 3D:hen”.
Testit ja data
E2FGVI:n testaamiseksi tutkijat arvioivat järjestelmää kahdella suositulla videokohteiden segmentoinnin tietoaineistolla: YouTube-VOS ja DAVIS. YouTube-VOS sisältää 3741 opetusvideota, 474 validointivideota ja 508 testivideota, kun taas DAVIS sisältää 60 opetusvideota ja 90 testivideota.
E2FGVI koulutettiin YouTube-VOS:lla ja arvioitiin molemmilla tietoaineistoilla. Koulutuksen aikana esineen maskit (vihreät alueet yllä olevissa kuvissa ja liittyvä YouTube-video) luotiin simuloimaan videon korjausta.
Mittareina tutkijat käyttivät huippu-signaali-kohina-suhdetta (PSNR), rakenteellista samankaltaisuutta (SSIM), videopohjaista Fréchet Inception -etäisyyttä (VFID) ja virtauksen mukaisen muunnoksen virhettä – jälkimmäinen mittaamaan ajallista vakautta käsitellyssä videossa.
Aiemmat arkkitehtuurit, joita järjestelmää vastaan testattiin, olivat VINet, DFVI, LGTSM, CAP, FGVC, STTN ja FuseFormer.

Tutkimusraportin määrällisten tulosten osio. Ylös- ja alaspäin osoittavat nuolet osoittavat, että korkeammat tai matalammat luvut ovat parempia. E2FGVI saavuttaa parhaat tulokset yleisesti. Menetelmät arvioidaan FuseFormerin mukaan, vaikka DFVI, VINet ja FGVC eivät ole päästä päähän toimivia järjestelmiä, mikä tekee heidän FLOPsensa arvioinnin mahdottomaksi.
Lisäksi parhaiden tulosten saavuttamiseen kaikkia kilpailevia järjestelmiä vastaan, tutkijat suorittivat laadullisen käyttäjätutkimuksen, jossa viidellä edustavalla menetelmällä käsiteltyjä videoita esitettiin yksittäin kahdellekymmenelle vapaaehtoiselle, jotka pyydettiin arvioimaan niitä visuaalisen laadun perusteella.

Pystyakseli edustaa prosenttia osallistujista, jotka suosivat E2FGVI:n tulosta visuaalisen laadun perusteella.
Tutkijat huomauttavat, että vaikka heidän menetelmäänsä suosittiin yksimielisesti, yksi tulos, FGVC, ei vastaa määrällisiä tuloksia. He esittävät tämän mahdollisesti tarkoittavan, että E2FGVI tuottaa harhaanjohtavasti ”visuaalisesti miellyttävämpiä tuloksia”.
Tehokkuuden suhteen tutkijat toteavat, että heidän järjestelmänsä vähentää merkittävästi liukulukulaskutoimituksia sekunnissa (FLOPs) ja päättelyaikaa yhdellä Titan-GPU:lla DAVIS-tietoaineistolla, ja havaitsevat, että tulokset osoittavat E2FGVI:n suorittavan 15 kertaa nopeammin kuin virtauspohjaiset menetelmät.
He kommentoivat:
‘[E2FGVI] saavuttaa alhaisimman FLOPs-arvon verrattuna kaikkiin muihin menetelmiin. Tämä osoittaa, että ehdotettu menetelmä on erittäin tehokas videon korjaamiseen.’
*Olen muuttanut kirjoittajien tekstinsisäiset lähdeviitteet hyperlinkeiksi.
Julkaistu ensimmäisen kerran 19. toukokuuta 2022.
Muutettu tiistaina 28. lokakuuta 2025 viallisen videoupotuksen poistamiseksi ja upotettuun videoon kohdistuvien viittausten muuttamiseksi artikkelin tekstissä.


