Ajatusjohtajat
Miten selitettävä tekoäly parantaa toimintavarmuutta ja luotettavuutta

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa
Keskeiset kohdatSelitettävyys on olennaista käyttäjien luottamukselle korkean panoksen tekoälyssä…
Näytä lisää
- Selitettävyys on olennaista käyttäjien luottamukselle korkean panoksen tekoälyssä, kuten lääketieteellisissä ja lainapäätöksissä.
- Säädökset, kuten GDPR, edellyttävät oikeutta selitykseen automaattisen päätöksenteon vastuullisuuden varmistamiseksi.
- Tekniikat, kuten LIME ja SHAP, luovat yksinkertaisempia malleja monimutkaisten tekoälyennusteiden tulkitsemiseksi.
Tekoäly (AI) on yleistymässä yrityksissä, ja se on hitaasti sulautumassa elämäämme. Tämän demokratisoinnin tärkeä osa on, että loppukäyttäjien on voitava täysin ymmärtää prosessit ja mekanismit, joita tekoäly käyttää johtopäätösten tekemiseen tai haluttujen tulosten saavuttamiseen. Ihmisluonnolle on syvään juurtunut tarve paljastaa “miksi” ja “miten” jokaisen ilmiön taustalla, mikä on kiihdyttänyt teknologista kehitystämme. Tekoälyssä tämä ymmärrys kutsutaan “selitettävyydeksi”.
Miksi selitettävyys on tärkeää?
Usein lähestymme tekoälyä “mustana laatikkona”, jossa meillä on tietoisuus vain syötteistä ja tuloksista, mutta prosessit, joita käytetään, ovat meille tuntemattomia. Tätä ongelmaa lisää se, että useimpien tekoälymenetelmien, kuten monimutkaisten syväoppimismallien ja luonnollisen kielen prosessoinnin, algoritmit ovat hyvin abstrakteja jopa niiden kokeneimmille asiantuntijoille.
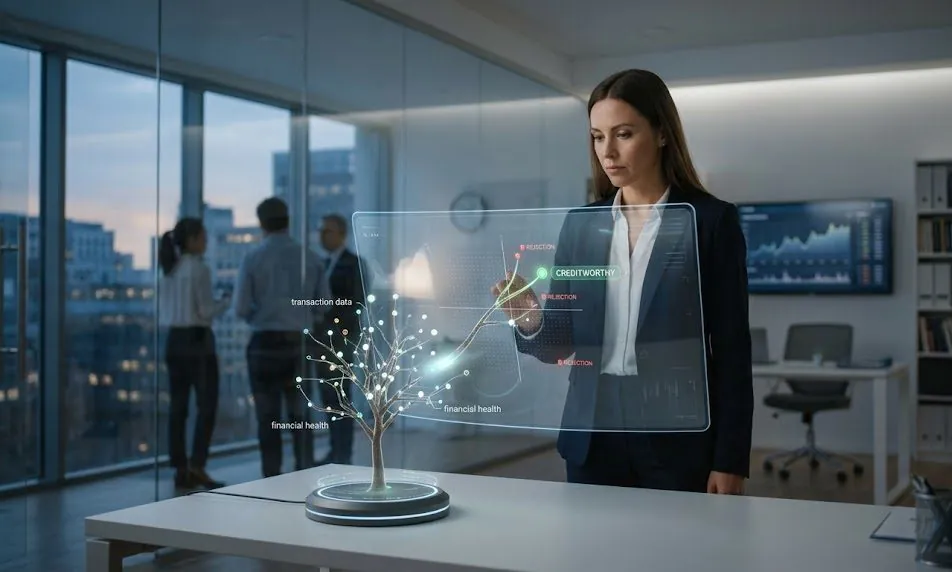
Luottamus ja avoimuus: Jotta käyttäjät voivat luottaa tekoälyn ennusteisiin, niissä on oltava jonkinlainen selitettävyys. Esimerkiksi jos lääkärin on suositeltava hoitoa tekoälyn ennusteiden perusteella, hänen on voitava luottaa ennusteisiin. Pankin on oltava täysin varma lainan hyväksymisestä tai hylkäämisestä ja pystyttävä perustelemaan päätös kaikille sidosryhmille. Rekrytoinnissa ja valinnassa käytettävän tekoälyn on osoitettava, että sen taustalla olevat mekanismit ovat reiluja ja tasapuolisia kaikille hakijoille.
Ihmisläheisempi tekoäly ja laajempi käyttöönotto: McKinseyn The state of AI in 2020 -raportissa kerrotaan, että valmistaja käyttää erittäin avoimia malleja saadakseen hyväksynnän tehtaansa työntekijöiltä, jotka tarvitsevat luottamusta tekoälyn heidän turvallisuudestaan tekemiin arvioihin. Sidosryhmien hyväksynnän saaminen on keskeinen este siirryttäessä yksittäisistä ratkaisuista koko yrityksen kattavaan tekoälyn käyttöön ja tavoiteltaessa investoinnista täyttä hyötyä. Tämä helpottuu, jos suorituskyky on selitettävissä laajemmalle yleisölle. Liiketoiminnan kannalta selitettävyys parantaa kokonaisuutena asiakaskokemusta ja lisää asiakastyytyväisyyttä. IBM Institute for Business Value -tutkimuksen mukaan 68 prosenttia johtajista uskoo, että asiakkaat vaativat enemmän selitettävyyttä tekoälystä seuraavien kolmen vuoden aikana.
Paljastaa harhat ja parantaa mallin suorituskykyä: Kehittäjän on tiedettävä, miten mallin suorituskykyä voidaan parantaa ja miten sen virheitä voidaan korjata ja sitä hienosäätää. Selkeä selitettävyyskehys on yksi tärkeimmistä työkaluista perusteellisen analyysin suorittamiseen.
Tarkemmat ja monipuolisemmat oivallukset: Kokonaisvaltainen 360-asteen näkymä tarvitaan täydelliseen ymmärtämiseen tekoälyn antamista suosituksista. Esimerkiksi, jos tekoälyä käytetään sijoituspäätöksiin, on myös tiedettävä syyt ja perusteet niiden takana, jotta voidaan siirtää tämä tietämys muihin alueisiin ja ymmärtää mahdollisia sijoituspäätösten vaaroja. Vankka ymmärrys tekoälyn toiminnasta mahdollistaa myös uusien soveltamisten löytämisen.
Säännökset ja vastuu: Useat säännökset, kuten GDPR, vaativat selitysoikeutta automaattisen päätöksenteon prosessien selventämiseksi. Esimerkiksi itseohjautuvissa ajoneuvoissa, jos jotain menee pieleen ja aiheuttaa henkilö- ja materiaalivahinkoja, on tarpeen tietää juurisyyt, mikä on vaikeaa määrittää mustassa laatikossa.
Miten tekoäly voidaan tehdä selitettävämmäksi?
Selitettävät tekoälyjärjestelmät (XAI) kehitetään eri tekniikoilla, jotka keskittyvät joko koko mallin selittämiseen tai yksittäisten ennusteiden perustelujen selittämiseen jonkin algoritmin avulla.
Useimmat selitettävyystekniikat perustuvat:
- Mallin jakamiseen yksittäisiin osiin
- Visualisointiin mallin ennusteista (esim. jos malli luokittelee auton tietyn merkin, se korostaa osaa, joka aiheutti sen luokittelun)
- Selityskaivaukseen (käyttäen koneoppimismenetelmiä relevantin datan löytämiseen, joka selittää tekoälyalgoritmin ennustetta)
Yhdessä tekniikassa, jota kutsutaan proxy-mallinnukseksi, yksinkertaisempi ja ymmärrettävämpi malli, kuten päätöspuu, käytetään edustamaan monimutkaisempaa tekoälymallia. Nämä yksinkertaiset selitykset antavat hyvän käsityksen mallista korkealla tasolla, mutta ne voivat joskus peittää tiettyjä nuansseja.
Toinen lähestymistapa on “selitettävyys suunnittelun kautta”. Tämä lähestymistapa asettaa rajoituksia tekoälyverkon suunnitteluun ja koulutukseen uudella tavalla, joka pyrkii rakentamaan koko verkon pienemmistä ja ymmärrettävistä osista. Tämä edellyttää tasapainoa tarkkuuden ja selitettävyyden välillä ja rajoittaa tiettyjä lähestymistapoja datatieteilijän työkalupakista. Se voi myös vaatia paljon laskentatehoa.
Tekoälyn koulutus ja testaus voivat myös käyttää agnostisia datan verifioimistekniikoita, kuten Local Interpretable Model (LIME) ja Shapley Additive exPlanations (SHAP), ja nämä tulisi räätälöidä saavuttamaan korkean tarkkuuden F-scoren, precision ja muiden mittareiden avulla. Kaikki tulokset on seurattava ja vahvistettava laajan datan avulla. LIME: n avulla esimerkiksi organisaatiot voivat luoda tilapäisiä malleja, jotka jäljittelevät epäselvien algoritmien, kuten koneoppimisen, ennusteita. Nämä LIME-mallit voivat luoda laajan joukon muunnelmia annetun datan ja sen vastaavan tulosteen perusteella, mikä voidaan käyttää yksinkertaisempien ja tulkittavampien mallien kouluttamiseen yhdessä kattavien selitysten kanssa jokaiselle päätökselle ja/tai ennusteelle. SHAP-kehys perustuu peliteoriaan ja erityisesti yhteistyöpelien teoriaan. Se yhdistää vaikutusten optimaalisen kohdentamisen paikallisiin selityksiin käyttäen peliteorian alkuperäisiä Shapley-arvoja ja niistä johdettuja menetelmiä.
Periaatteisiin pohjautuva toiminta
Strategisemmalla tasolla tekoälyn luotettavuuskehykset tulisi kuitenkin sisältää laajan joukon periaatteita, joiden tavoitteena on varmistaa oikeat tulokset sekä käyttöönoton alussa että ajan myötä, kun malleja kehitetään muuttuvissa olosuhteissa. Vähintään nämä kehykset tulisi sisältää asioita kuten:
- Harhan havaitseminen – kaikki datasarjat on puhdistettava harhaisuudesta ja syrjivyydestä ja annettava oikea paino ja harkinta, kun sovelletaan koulutusmalliin;
- Ihmisen osallistuminen – operaattorien on voitava tutkia ja tulkita algoritmien tuloksia aina, erityisesti, kun malleja käytetään lainvalvontaan ja kansalaisoikeuksien säilyttämiseen;
- Perustelu – kaikkien ennusteiden on kestettävä tarkastelu, mikä edellyttää korkeaa avoimuutta, jotta ulkopuoliset tarkkailijat voivat arvioida prosesseja ja kriteerejä, joita käytetään tuloksien tuottamiseen;
- Toistettavuus – luotettavat tekoälymallit on oltava johdonmukaisia ennusteissaan ja ne on oltava hyvin vakaat uuden datan kohtaamisessa.
XAI:ta ei kuitenkaan pidä nähdä vain keinona parantaa kannattavuutta, vaan myös tapana vahvistaa vastuuvelvollisuutta varmistamaan, että instituutiot voivat selittää ja perustella luomustensa vaikutusta yhteiskuntaan kokonaisuutena.