
Valvonta
‘Heikentyneet’ Synteettiset Kasvot Voivat Parantaa Kasvojen Tunnistamista

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa
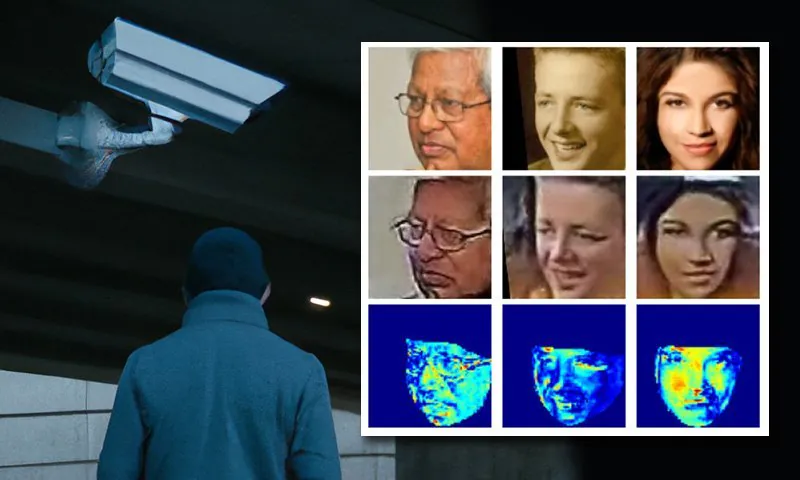
Keskeiset kohdatSynteettiset kasvot, jotka on tyylitelty todellisen valvontakuvan kaltaisiksi, voivat…
Näytä lisää
- Synteettiset kasvot, jotka on tyylitelty todellisen valvontakuvan kaltaisiksi, voivat kaventaa toimialueiden välistä kuilua, joka heikentää tunnistustarkkuutta.
- Vanhat CCTV-järjestelmät kärsivät teknisestä velasta, joka tekee niistä huonoja tietolähteitä nykyaikaisen kasvojentunnistuksen koulutukseen.
- Vastustava manipulointi voi palvella tunnistusta hyökkäämisen sijaan tuomalla kohdejärjestelmän tyylejä.
Tutkijat Michiganin osavaltion yliopistosta ovat kehittäneet menetelmän, jolla synteettiset kasvot voivat ottaa tauon deepfake-maailmasta ja tehdä hyvää maailmassa – auttamalla kuvantunnistusjärjestelmiä tulkitsemaan kuvia tarkemmin.
Heidän kehittämänsä uusi ohjattava kasvonsynteesimoduuli (CFSM) on kykeneväinen uudelleenluomaan kasvoja oikean maailman videonvalvontakuvauksen tyylissä, sen sijaan, että se riippuisi yhdenmukaisesti korkealaatuisemmista kuvista, joita käytetään suosituissa avoimissa julkkiskasvojen aineistoissa julkkiksista, jotka eivät heijasta aitojen valvontakamerajärjestelmien kaikkia puutteita, kuten kasvojen epäterävyyttä, matalaa resoluutiota ja kennokohinaa – tekijöitä, jotka voivat vaikuttaa tunnistusvirheisiin.

Käsitteellinen arkkitehtuuri ohjattava kasvonsynteesimoduuli (CFSM). Lähde: http://cvlab.cse.msu.edu/pdfs/Liu_Kim_Jain_Liu_ECCV2022.pdf
CFSM ei ole tarkoitettu erityisesti jäljittelemään pään asentoja, ilmeitä tai muita yleisiä piirteitä, jotka ovat deepfake-järjestelmien tavoitteita, vaan sen sijaan se tuottaa joukon vaihtoehtoisia näkymiä kohdetunnistusjärjestelmän tyylissä, käyttäen tyylin siirtämistä.
Järjestelmä jäljittelee kohdejärjestelmän visuaalista tyyliä ja mukauttaa tuotoksensa sen resoluutioon ja erilaisiin poikkeamiin. Käyttökohteita ovat vanhat järjestelmät, joita tuskin päivitetään kustannussyistä. Niiden kuvanlaatu on voinut aikanaan olla huipputasoa, mutta nykyään se rajoittaa niiden käyttöä uuden sukupolven kasvojentunnistuksessa.
Järjestelmän testaaminen osoitti, että se teki merkittäviä parannuksia kuvantunnistusjärjestelmissä, jotka joutuvat käsittelemään tällaista meluisaa ja matalalaatuista dataa.

Kouluttamassa kasvojen tunnistusmalleja sopeutumaan kohdejärjestelmien rajoituksiin. Lähde: http://cvlab.cse.msu.edu/pdfs/Liu_Kim_Jain_Liu_ECCV2022_supp.pdf
Prosessista saatiin myös hyödyllinen sivutuote: kohdeaineistoja voidaan nyt luonnehtia ja vertailla keskenään. Se helpottaa tulevaisuudessa vertailutestausta ja eri valvontajärjestelmille räätälöityjen aineistojen tuottamista.
Lisäksi menetelmä voidaan soveltaa olemassa oleviin tietokantoihin, suorittamalla de facto kohdealueeseen mukauttamista ja tekemällä niistä sovellettavampia kasvojen tunnistusjärjestelmille.
Uusi artikkeli on nimeltään Ohjattava ja opastettu kasvonsynteesi kasvojentunnistukseen rajoittamattomissa olosuhteissa, ja se on tuettu osittain Yhdysvaltain kansallisen tiedustelun johtajan toimistosta (ODNI, IARPA), ja se tulee neljältä tutkijalta MSU:n tietojenkäsittely- ja insinööritieteiden osastolta.
Esitelty Sisältö
Matalan laadun kasvojen tunnistaminen (LQFR) on tullut huomattavaksi tutkimusalueeksi viime vuosina. Koska kunnalliset viranomaiset rakensivat videonvalvontajärjestelmiä kestäviksi ja pitkäaikaisiksi (ei halunnut uudelleenmäärittää resursseja ongelmaan jaksollisesti), monet “perintö” -valvontaverkot ovat joutuneet teknisen velan uhreiksi, sovellettavuutensa suhteen koneoppimisen tietolähteiksi.

Eri kasvojen resoluutioita eri historiallisissa ja uudemmissa videonvalvontajärjestelmissä. Lähde: https://arxiv.org/pdf/1805.11519.pdf
Onneksi tämä on tehtävä, johon diffuusiomallit ja muut meluun perustuvat mallit ovat poikkeuksellisen hyvin soveltuvia ratkaisemaan. Monet viime vuosien suosituimmista ja tehokkaimmista kuvansynteesijärjestelmistä suorittavat resoluution suurentamista matalaresoluutioisista kuvista osana prosessiaan, kun taas tämä on myös ehdottoman välttämätöntä neuraalisille pakkaustekniikoille (menetelmille, joissa kuvat ja videot tallennetaan neuroverkkodatana bittikarttadatan sijaan).
Kasvojen tunnistamisen osana on saada mahdollisimman suuri tarkkuus vähimmäisestä määrästä piirteitä, jotka voidaan erottaa pienimmistä ja vähäisimmistä matalaresoluutioisista kuvista. Tämä rajoitus on olemassa, koska on hyödyllistä pystyä tunnistamaan (tai luomaan) kasvoja matalassa resoluutiossa, mutta myös teknisten rajoitusten vuoksi kuvien koosta, jotka voivat kulkea koulutusmallin latenttiavaruuden kautta, jonka koulutusta rajoittaa paikallisen näytönohjaimen käytettävissä oleva VRAM-muisti.
Tässä mielessä termi “piirteet” on hämäävä, koska tällaiset piirteet voidaan myös saada tietokannasta puistonpenkeistä. Konenäössä “piirteet” viittaavat erottaviin ominaisuuksiin saatavista kuvista – mihin tahansa kuvista, olivatpa ne kirkon piirteitä, vuoren asentoa tai kasvojen piirteitä kasvotietokannassa.
Koska konenäköalgoritmit ovat nyt taitavia kuvien ylös skaalauksessa ja videomateriaalissa, on ehdotettu useita menetelmiä “parantamaan” matalaresoluutioisia tai muuten heikentyneitä perintövalvontamateriaaleja, jotta ne voisivat olla käytettävissä oikeudellisissa tarkoituksissa, kuten asettaa tietty henkilö rikospaikalle.
Lisäksi mahdollisuus väärään tunnistamiseen, joka on joskus kerännyt otsikkoja, ei pitäisi teoriassa olla välttämätöntä hyper-resoluutioon tai muuhun muodonmuutokseen, jotta voidaan tehdä positiivinen tunnistaminen yksilöstä, koska kasvojen tunnistusjärjestelmä, joka keskittyy matalatasoiseen piirteisiin, ei tarvitse sitä resoluutiota ja selkeyttä. Lisäksi tällaiset muodonmuutokset ovat kalliita käytännössä ja herättävät lisäksi toistuvia kysymyksiä niiden mahdollisen validiteetin ja laillisuuden suhteen.
Tarvitaan lisää heikkolaatuisia julkkiskuvia
Olisi hyödyllisempää, jos kasvojen tunnistusjärjestelmä voisi johtaa piirteitä (ts. koneoppimisen piirteitä ihmisten piirteistä) perintöjärjestelmien tulosteista sellaisenaan, ymmärtämällä paremmin suhdetta “korkean resoluution” identiteetin ja heikentyneiden kuvien välillä, jotka ovat saatavilla muuttumattomissa (usein korvaamattomissa) olemassa olevissa videonvalvontakehyksissä.
Ongelmana on standardit: yleiset web-kerätyt tietokannat, kuten MS-Celeb-1M ja WebFace260M (muiden joukossa), ovat kiinnittyneet tutkimusyhteisöön, koska ne tarjoavat yhdenmukaiset vertailukohteet, joihin tutkijat voivat verrata edistymistään nykyisen tilan kanssa.

Esimerkkejä Microsoftin suositusta MS-Celeb1m-tietokannasta. Lähde: https://www.microsoft.com/en-us/research/project/ms-celeb-1m-challenge-recognizing-one-million-celebrities-real-world/
Kuitenkin kirjoittajat väittävät, että kasvojen tunnistus (FR) -algoritmit, jotka on koulutettu näillä tietokannoilla, eivät sovellu visuaalisiin “alueisiin” monien vanhempien valvontajärjestelmien tulosteista.
Artikkeli toteaa*:
”Huipputason (SoTA) kasvojentunnistusmallit eivät toimi hyvin todellisessa, rajoittamattomissa olosuhteissa kerätyssä valvontakuvastossa kohdealueen vaihtumisen vuoksi. Verkosta kerättyjen julkkiskasvojen laajat, osittain rajoitetut koulutusaineistot eivät sisällä tosielämän vaihtelua, kuten kennokohinaa, matalaa resoluutiota, liike-epäterävyyttä tai turbulenssin vaikutuksia.
”Esimerkiksi yhden huipputason mallin ilmoittama 1:1-varmennustarkkuus rajoittamattomassa IJB-S-aineistossa on noin 30 % pienempi kuin osittain rajoitetussa LFW-aineistossa.
”Mahdollinen ratkaisu suorituskykyeroon olisi koota laaja kasvokuva-aineisto rajoittamattomista olosuhteista. Kymmeniätuhansia henkilöitä sisältävän koulutusaineiston rakentaminen on kuitenkin erittäin vaikeaa manuaalisen merkitsemisen korkeiden kustannusten vuoksi.”
Artikkeli kertoo useista aiemmista menetelmistä, jotka ovat yrittäneet “sovittaa” erilaisia historiallisten tai matalalaatuisten valvontajärjestelmien tulosteita, mutta ne ovat käsitelleet “sokeita” parannuksia. Sen sijaan CFSM saa suoran palautteen kohdejärjestelmän todellisesta tulosteesta koulutuksen aikana ja sopeuttaa itsensä tyylin siirtämisen kautta jäljittelemään kyseistä aluetta.

Näyttelijä Natalie Portman, joka ei ole vieras joukossa tietokantoja, jotka hallitsevat konenäköyhteisöä, on mukana esimerkissä CFSM:stä, joka suorittaa tyylin mukaisen sopeutumisen kohdejärjestelmän palautteen perusteella.
Arkkitehtuuri, jonka kirjoittajat ovat suunnitelleet, käyttää nopeaa gradientin etumerkkimenetelmää (FGSM) erottamaan ja “tuomaan” saadut tyylit ja ominaisuudet kohdejärjestelmän todellisesta tulosteesta. Kuvia tuottava prosessin osa paranee koulutuksen aikana ja jäljittelee kohdejärjestelmää yhä uskollisemmin. Kohdejärjestelmän matalaulotteisesta tyyliavaruudesta tuleva palaute koskee matalan tason ominaisuuksia ja vastaa yleisimpiä johdettuja visuaalisia kuvailijoita.
Kirjoittajat toteavat:
‘Kohdejärjestelmän palautteen ansiosta syntetisoidut kuvat ovat hyödyllisempiä kasvojen tunnistukselle, mikä johtaa merkittäviin parannuksiin kasvojen tunnistusmallien yleistymiskyvyssä, jotka on koulutettu niiden avulla.’
Testit
Tutkijat käyttivät MSU:n aiempaa tutkimusta mallina testaamiseen. Perustuen samoihin kokeellisiin protokolleihin, he käyttivät MS-Celeb-1m:tä, joka koostuu pelkästään verkkohakuun perustuvista julkkiskuvista, merkityksi koulutusdataksi. Reiluuden vuoksi he sisällyttivät myös MS1M-V2:n, joka sisältää 3,9 miljoonaa kuvaa, joissa on 85 700 luokkaa.
Kohdeaineisto oli WiderFace -tietokanta Hongkongin kiinalaisesta yliopistosta. Tämä on erittäin monipuolinen joukko kuvia, jotka on suunniteltu haastavien tilanteiden kasvojen havaitsemistehtäviin. 70 000 kuvaa tästä joukosta käytettiin.
Arviointia varten järjestelmä testattiin neljää kasvojen tunnistusvertailukohdetta vastaan: IJB-B, IJB-C, IJB-S ja TinyFace.
CFSM koulutettiin noin 10%:lla koulutusdatasta MS-Celeb-1m:stä, noin 0,4 miljoonalla kuvalla, 125 000 iteraatiolla 32 kuvan eräkoossa Adam-optimoijalla (erittäin alhaisella) 1e-4 oppimisnopeudella.
Kohdekasvojen tunnistusmalli käytti muunnelmaa ResNet-50:stä rungona, ArcFace-häviöfunktiolla koulutuksen aikana. Lisäksi malli koulutettiin CFSM:llä ablaatio- ja vertailukokeena (merkitty “ArcFace” tuloksissa alla).

CFSM:n ensisijaiset testitulokset. Suuremmat luvut ovat parempia.
Kirjoittajat toteavat ensisijaisista tuloksista:
‘ArcFace-malli päihittää kaikki vertailumallit sekä kasvojen identifioinnissa että henkilöllisyyden varmentamisessa ja saavuttaa uuden huipputason suorituskyvyn.’
Kyky erottaa kohdealueet vanhojen tai vaatimattomasti varustettujen valvontajärjestelmien erilaisista ominaisuuksista antaa tutkijoille myös mahdollisuuden vertailla ja arvioida näiden järjestelmien jakaumien samankaltaisuutta sekä kuvata jokaista järjestelmää visuaalisena tyylinä, jota voidaan hyödyntää jatkotyössä.

Eri aineistojen esimerkeissä näkyy selviä tyylieroja.
Tutkijat huomauttavat myös, että järjestelmä voi hyödyntää tekniikoita, joita tutkimus- ja konenäköyhteisö on tähän asti pitänyt pelkkinä ratkaistavina ongelmina:
”CFSM osoittaa, että adversaarista manipulointia voidaan käyttää muuhunkin kuin hyökkäämiseen: se voi parantaa tunnistustarkkuutta konenäkötehtävissä. Lisäksi määrittelemme aineistojen samankaltaisuusmittarin opittujen tyylikantojen perusteella. Ne kuvaavat tyylieroja riippumatta luokkamerkinnöistä tai ennustimesta.
”Uskomme tutkimuksemme osoittavan ohjattavan ja opastetun kasvonsynteesimallin mahdollisuudet kasvojentunnistuksessa rajoittamattomissa olosuhteissa sekä lisäävän ymmärrystä aineistojen välisistä eroista.”
* Kirjoittaja on muuttanut tutkijoiden tekstinsisäiset lähdeviitteet hyperlinkeiksi.
Julkaistu ensimmäisen kerran 1. elokuuta 2022.


