
Prompt engineering
ChatGPT ja edistynyt kehotesuunnittelu: Tekoälyn kehityksen ohjaaminen

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa

Keskeiset kohdatKehittyneet kehoteinsinööritystekniikat, kuten ReAct ja ketjumainen ajattelu, ovat…
Näytä lisää
- Kehittyneet kehoteinsinööritystekniikat, kuten ReAct ja ketjumainen ajattelu, ovat ratkaisevan tärkeitä tekoälyn harhojen vähentämisessä ja päättelykyvyn parantamisessa.
- Hyvin määritellyt kehotekkeet ovat välttämättömiä ChatGPT:n tuotoksen laadun hallitsemiseksi ja asiaankuuluvien, käyttäjäystävällisten vastausten varmistamiseksi.
- Pienen otoksen oppiminen mahdollistaa mallien, kuten GPT-3:n, sopeutumisen uusiin tehtäviin ilman kalliita hienosäätöjä tai räätälöityjä aineistoja.
OpenAI on ollut keskeisessä asemassa kehittämässä vallankumouksellisia työkaluja, kuten OpenAI Gym, joka on suunniteltu vahvistusoppimisalgoritmien koulutukseen, ja GPT-malleja. Huomio kohdistuu myös DALL-E:hen, joka on tekoälymalli, joka luo kuvia tekstisyötteistä. Yksi tällainen malli, joka on saanut merkittävää huomiota, on OpenAI:n ChatGPT, joka on loistava esimerkki suurten kielimallien alueella.
GPT-4: Kehotesuunnittelu
ChatGPT on muuttanut chatbot-maailman, tarjoamalla ihmismäisiä vastauksia käyttäjän syötteisiin ja laajentamalla sovelluksia eri aloilla – ohjelmistokehityksestä ja testaamisesta liiketoimintaviestintään ja jopa runouden luomiseen.
Yritysten ja yksityishenkilöiden käsissä, GPT-4 esimerkiksi voisi toimia loppumattomana tietovarantona, joka on taitava aiheissa, jotka ulottuvat matematiikasta ja biologiasta oikeustutkimuksiin. Tällaiset kehittyneet ja helposti saatavilla olevat tekoälymallit ovat valmiina uudelleenmäärittelemään tulevaisuuden työtä, oppimista ja luovuutta.

Generatiiviset mallit, kuten GPT-4, voivat tuottaa uutta dataa olemassa olevien syötteiden perusteella. Tämä erottuva ominaisuus mahdollistaa niille monenlaisten tehtävien suorittamisen, mukaan lukien tekstin, kuvien, musiikin ja videoiden generointi.
ChatGPT: n ja OpenAI-mallien kontekstissa kehote on syöte, jonka käyttäjät antavat malleille, yleensä tekstin muodossa. Kehotteet ovat ensisijainen keino ohjata mallien tuottamaa tulostetta, mikä tekee niistä tärkeitä onnistuneiden ja merkityksellisten keskustelujen kannalta.
Kehotteen laadun vaikutus
Hyvin määritellyt kehotteet ovat avain onnistuneisiin ja merkityksellisiin keskusteluihin tekoälyjärjestelmien kanssa. Huonosti määritellyt kehotteet voivat johtaa tuloksiin, jotka eivät ole käyttäjälle hyödyllisiä ja johtavat jopa harhaanjohtaviin sisältöihin.
Kehotteen laadun vaikutuksen havainnollistamiseksi vertaamme kahta eri kehotetta, jotka annettiin ChatGPT: lle. Ensimmäinen kehote, joka on huonosti määritelty ja olettaa aiempaa tietämystä, tuottaa mahdollisesti ei-hyödyllisen vastauksen käyttäjälle. Toisaalta toinen kehote tarjoaa enemmän kontekstia ja esimerkkejä, varmistaen enemmän relevantin ja ymmärrettävän vastauksen.
Kehote 1: “Kerro minulle konvoluutio-neuroverkoista.”
Vastaus 1: “Konvoluutio-neuroverkot (CNN) ovat monikerroksisia perceptron-verkkoja, jotka koostuvat täysin kytkettyjen kerrosten ja pooling-kerrosten yhdistelmästä. Ne ovat yleisesti käytettyjä kuvatunnistustehtävissä. Prosessiin kuuluu suodattimien soveltaminen syötekuviin ja niiden alentaminen pooling-kerrosten avulla.”
Kehote 2: “Haluan oppia konvoluutio-neuroverkoista, mutta minulla ei ole aiempaa tietämystä neuroverkoista. Voitko antaa aloittelijaystävällisen selityksen ja esimerkin siitä, miten CNN-verkkoja käytetään kuvatunnistuksessa?”
Vastaus 2: “Konvoluutio-neuroverkot (CNN) ovat tietynlainen neuroverkko, jota käytetään pääasiassa kuvatunnistustehtävissä. Toisin kuin muut neuroverkot, ne hyödyntävät konvoluutio- ja pooling-kerroksia kuvien prosessointiin. Kuvittele, että sinulla on kuva kissasta. CNN: t voivat tunnistaa eri piirteitä kuvassa, kuten viiksiä, korvia ja häntää, soveltamalla suodattimia ja alentamalla kuvaa pooling-kerrosten avulla. Tämä prosessi tekee CNN: t erittäin tehokkaiksi objektien tunnistamisessa kuvissa.”
Vertaamalla kahta vastausta on selvää, että hyvin määritelty kehote johtaa relevantimpaan ja käyttäjälle ystävällisempään vastaukseen. Kehotteiden suunnittelu eli kehotesuunnittelu on kasvava ala, jotka pyrkivät optimoimaan tekoälymallien, kuten ChatGPT: n, tulosteen laatua.
Seuraavissa artikkelin osioissa syvennymme edistyneiden menetelmien maailmaan, joilla voidaan jalostaa suuria kielimalleja (LLM), kuten kehotesuunnittelutekniikoita ja taktiikoita. Nämä sisältävät muutamaan esimerkkiin perustuvan oppimisen, ReActin, ketjuajattelun, RAG: n ja muita.
Edistyneet kehotesuunnittelutekniikat
Ennen kuin jatkamme, on tärkeää ymmärtää yksi LLM:ien ongelma, jota kutsutaan “hallusinaatioksi”. LLM:ien kontekstissa “hallusinaatio” tarkoittaa näiden mallien taipumusta tuottaa tuloksia, jotka saattavat vaikuttaa järkeviltä, mutta eivät perustu tosiasioihin tai annettuun kontekstiin.
Tämä ongelma korostui äskettäisessä oikeustapauksessa, jossa puolustusasianajaja käytti ChatGPT: ää oikeudelliseen tutkimukseen. Tekoälytyökalu, joka epäonnistui hallusinaatio-ongelmansa vuoksi, mainitsi olemattomia oikeustapauksia. Tämä virhepäätös aiheutti merkittäviä seurauksia, aiheuttaen sekaannusta ja vahingoittaen uskottavuutta oikeudenkäynnissä. Tämä tapaus on voimakas muistutus tekoälyjärjestelmien “hallusinaatio”-ongelman kiireellisestä ratkaisemistarpeesta.
Kehotesuunnittelutekniikoiden tutkimisemme pyrkii parantamaan näitä LLM:ien puolia. Tehostamalla niiden tehokkuutta ja turvallisuutta, luomme innovatiivisia sovelluksia, kuten tietojen hakua. Lisäksi se mahdollistaa LLM:ien helpon integroimisen ulkoisiin työkaluihin ja tietolähteisiin, laajentamalla niiden soveltamisalueita.
Oppiminen ilman esimerkkejä ja muutaman esimerkin avulla: Optimointi esimerkkien avulla
Generatiiviset esikoulutetut transformaattorit (GPT-3) merkitsivät tärkeää käännekohtaa generatiivisten AI-mallien kehityksessä, koska se esitteli “muutamaan esimerkkiin perustuvan oppimisen” käsitteen. Tämä menetelmä oli pelinmuuttaja sen kyvyn vuoksi toimia tehokkaasti ilman kattavaa hienosäätöä. GPT-3-kehys on käsitelty tutkimuksessa “Kielen mallit ovat muutaman esimerkin oppijoita“, jossa tutkijat osoittavat, miten malli menestyy erilaisissa sovelluksissa ilman mukautettuja tietoja tai koodia.
Toisin kuin hienosäätö, joka vaatii jatkuvaa ponnistelua ratkaistaessaan erilaisia sovelluksia, muutaman esimerkin avulla toimivat mallit osoittavat helpomman sopeutumisen laajempaan sovellusvalikoimaan. Vaikka hienosäätö saattaa tarjota vahvoja ratkaisuja joissakin tapauksissa, se voi olla kallista suuremmassa mittakaavassa, mikä tekee muutaman esimerkin avulla toimivien mallien käytön käytännöllisemmäksi, erityisesti yhdistettynä kehotesuunnitteluun.
Kuvittele, että yrität kääntää englantia ranskaan. Muutamaan esimerkkiin perustuvassa oppimisessa antaisit GPT-3: lle joitain käännösesimerkkejä, kuten “sea otter -> loutre de mer”. GPT-3, ollen kehittynyt malli, pystyy jatkamaan antamalla tarkkoja käännöksiä. Ilman esimerkkejä tapahtuvassa oppimisessa et antaisi esimerkkejä, ja GPT-3 pystyisi silti kääntämään englannin kielen ranskaan tehokkaasti.
“Muutamaan esimerkkiin perustuvan oppimisen” käsite tulee siitä, että malli saa rajoitetun määrän esimerkkejä “opettelemaan” niistä. On tärkeää huomata, että “opetteleminen” tässä kontekstissa tarkoittaa, että mallin suorituskykyyn vaikutetaan, eikä se vaadi mallin parametrien tai painojen päivittämistä.

Muutamaan esimerkkiin perustuvan oppimisen esimerkki GPT-3-tutkimuksesta
Ilman esimerkkejä tapahtuvassa oppimisessa ei anneta mallille esimerkkejä tehtävän suorittamisesta. Mallin odotetaan suoriutuvan tehtävästä sen alkuperäisen koulutuksen perusteella, mikä tekee tämän menetelmän ihanteelliseksi avoimen kysymyksen vastaamisen tilanteisiin, kuten ChatGPT: ssä.
Monissa tapauksissa malli, joka on taitava ilman esimerkkejä tapahtuvassa oppimisessa, voi suoriutua hyvin, kun sille annetaan muutamia oppimisesimerkkejä tai jopa yksittäisiä esimerkkejä. Tämä kyky vaihdella ilman esimerkkejä, yhden esimerkin ja muutaman esimerkin oppimistilanteiden välillä korostaa suurten mallien sopeutumiskykyä ja parantaa niiden soveltamismahdollisuuksia eri aloilla.
Ilman esimerkkejä toimivat oppimismenetelmät ovat yhä yleisempiä. Nämä menetelmät ovat tunnettuja kyvystään tunnistaa objekteja, joita ei ole nähty koulutuksessa. Tässä on käytännön esimerkki muutamaan esimerkkiin perustuvasta kehotteesta:
Käännä seuraavat englanninkieliset lauseet ranskaan:
'sea otter' kääntyy 'loutre de mer'
'sky' kääntyy 'ciel'
Mitä 'cloud' kääntyy ranskaan?"
Antamalla mallille joitain esimerkkejä ja asettamalla sille kysymys, voimme ohjata mallin tuottamaan halutun tuloksen. Tässä tapauksessa GPT-3 todennäköisesti kääntäisi “cloud” oikein ranskaan “nuageksi”.
Me tutkimme syvemmälle kehotesuunnittelutekniikoiden moninaisuutta GPT-malleissa ja niiden olennaista roolia mallien suorituskyvyn optimoimisessa päättelyvaiheen aikana. Selvitämme myös, miten niitä voidaan käyttää luomaan kustannustehokkaita ja skaalattavia ratkaisuja laajalle sovellusvalikoimalle.
Kun tutkimme kehotesuunnittelutekniikoiden moninaisuutta GPT-malleissa, on tärkeää korostaa aiempaa postaustamme “Kehotesuunnitteluopas ChatGPT: ssä“. Tämä opas tarjoaa näkemyksiä strategioista tekoälymallien ohjaamiseksi tehokkaasti laajalla sovellusvalikoimalla.
Aiemmissa keskusteluissamme syvennymme kehotteiden perusmenetelmiin suurten kielimallien (LLM) kanssa, kuten nolla- ja muutamaan esimerkkiin perustuvassa oppimisessa sekä ohjeita antavissa kehotteissa. Näiden menetelmien hallitseminen on olennaista navigoidessaan monimutkaisempien kehotesuunnittelutekniikoiden haasteiden kanssa, joita tutkimme tässä.
Muutaman esimerkin oppimista voi rajoittaa LLM:ien rajoitettu konteksti-ikkuna. Lisäksi ilman asianmukaisia varotoimia LLM: t voidaan johtaa antamaan mahdollisesti haitallista tulostetta. Monet mallit kamppailevat myös päättelytehtävien tai useamman vaiheen ohjeiden seuraamisen kanssa.
Näiden rajoitusten vuoksi haasteena on hyödyntää LLM: iä monimutkaisiin tehtäviin. Ilmeinen ratkaisu voisi olla kehittää edistyneempiä LLM: iä tai parantaa olemassa olevia, mutta se vaatisi merkittävää ponnistelua. Kysymys on: miten voimme optimoida nykyisiä malleja parantamaan ongelmanratkaisukykyä?
Yhtä mielenkiintoista on tutkia, miten tämä tekniikka liittyy luovuuden sovelluksiin Unite AI: n “Tekoälytaiteen mestaruus: Lyhyt opas Midjourneyhin ja kehotesuunnitteluun“, joka kuvaa, miten taiteen ja tekoälyn yhdistäminen voi johtaa hämmästyttäviin taideteoksiin.
Ketjuajattelupyyntö
Ketjuajattelupyyntö hyödyntää suurten kielimallien (LLM) sisäisiä auto-regressiivisia ominaisuuksia, jotka ovat erittäin tehokkaita ennustamaan seuraavaa sanaa annetussa järjestyksessä. Pyytämällä mallia selittämään ajatteluprosessiaan, se indusoi perusteellisemman, systemaattisemman ideoiden generoinnin, joka yleensä vastaa tarkkaa tietoa. Tämä suuntautuminen johtuu mallin taipumuksesta prosessoida ja toimittaa tietoa järjestyksessä ja johdonmukaisesti, samalla tavalla kuin ihmisasiantuntija selittäisi monimutkaisen käsitteen kuulijalle. Yksinkertainen lause, kuten “ohjaa minua askel askeleelta…”, on usein riittävä laukaisemaan tämän tarkemman ja yksityiskohtaisemman tuloksen.
Nolla-ketjuajattelupyyntö
Vaikka perinteinen ketjuajattelupyyntö vaatii esimerkkejä, nolla-ketjuajattelupyyntö on nouseva ala. Tämä lähestymistapa, jota Kojima et al. (2022) esittivät, lisää innovatiivisesti lauseen “Ajatellaan askel askeleelta” alkuperäiseen pyyntöön.
Luo edistynyt pyyntö, jossa ChatGPT: tä pyydetään tiivistämään tärkeät havainnot tekoäly- ja NLP-tutkimusartikkeleista.
Tässä esimerkissä käytämme mallin kykyä ymmärtää ja tiivistää monimutkaisia tietoja akateemisista teksteistä. Käyttämällä muutamaan esimerkkiin perustuvaa menetelmää, opetamme ChatGPT: ä tiivistämään tärkeät havainnot tekoäly- ja NLP-tutkimusartikkeleista:
1. Artikkelin otsikko: "Huomio on kaikki, mitä tarvitaan"
Tärkein havainto: Esiteltiin transformer-malli, jossa korostettiin huomion mekanismien tärkeyttä toistuvien kerrosten sijaan järjestysmuunnoksissa.
2. Artikkelin otsikko: "BERT: Syvän bidirectional transformerin esikoulutus kielen ymmärtämiselle"
Tärkein havainto: Esiteltiin BERT, joka osoitti syvän bidirectionaalin mallin esikoulutuksen tehokkuuden saavuttamalla huipputuloksia useissa luonnollisen kielen käsittelyn tehtävissä.
Nyt, tämän esimerkin kontekstissa, tiivistä tärkeät havainnot seuraavasta artikkelista:
Artikkelin otsikko: "Kehotesuunnittelu suurissa kielimalleissa: Tutkimus"
Tämä pyyntö ei ainoastaan säilytä selkeää ketjuajattelua, vaan hyödyntää myös muutamaan esimerkkiin perustuvaa menetelmää ohjaamaan mallia. Se liittyy avainsanoihimme keskittyen tekoäly- ja NLP-aloihin, erityisesti pyytäen ChatGPT: ä suorittamaan monimutkaisen toiminnon, joka liittyy kehotesuunnitteluun: tiivistämään tutkimusartikkeleita.
ReAct-pyyntö
ReAct eli ”Reason and Act” esiteltiin Googlen (GOOGL ) tutkimuksessa “ReAct: Synergizing Reasoning and Acting in Language Models“, ja se muutti kielimallien vuorovaikutusta tehtävien kanssa ohjaamalla niitä tuottamaan dynaamisesti sekä sanallisia päättelyjälkiä että tehtäväkohtaisia toimintoja.
Kuvittele, että olet keittiössä kuin ihmiskokki: sinun on suoritettava sarja toimia (viipaloida vihanneksia, keittää vettä, sekoittaa aineita) ja osallistua myös sanalliseen päättelyyn tai sisäiseen puheeseen (“nyt kun vihannekset on viipaloitu, minun pitäisi laittaa kattila liedelle”). Tämä jatkuva mentaalinen dialogi auttaa suunnittelemaan prosessia, sopeutumaan äkillisiin muutoksiin (“minulla ei ole oliiviöljyä, käytän voita sen sijaan”) ja muistamaan tehtävien järjestyksen. ReAct jäljittelee tämän ihmisen kyvyn, mahdollistaen mallille nopeasti oppia uusia tehtäviä ja tehdä vahvoja päätöksiä, kuten ihminen tekisi uusissa tai epävarmoissa olosuhteissa.
ReAct voi ratkaista hallusinaation, yleisen ongelman ketjuajattelujärjestelmissä (CoT). CoT on tehokas tekniikka, mutta siltä puuttuu kyky vuorovaikuttaa ulkoisen maailman kanssa, mikä voi johtaa faktahallusinaatioon ja virheen leviämiseen. ReAct kuitenkin korvaa tämän puutteen vuorovaikuttaen ulkoisten tietolähteiden kanssa. Tämä vuorovaikutus mahdollistaa järjestelmän validoida päättelynsä ja päivittää tietämys perustuen ulkoisen maailman viimeisimpiin tietoihin.
ReActin perustoimintaa voidaan selittää esimerkin avulla HotpotQA-tehtävästä, joka vaatii korkean tason päättelyä. Kun ReAct-malli vastaanottaa kysymyksen, se hajottaa kysymyksen hallitettaviin osiin ja luo toimintasuunnitelman. Malli generoi päättelyjäljen (ajattelun) ja tunnistaa relevantin toiminnan. Se saattaa päättää etsiä tietoa Apple (AAPL ) Remote -laitteesta ulkoisesta lähteestä, kuten Wikipediasta (toiminta), ja päivittää ymmärryksensä hankittujen tietojen perusteella (havainto). Useiden ajattelu-toiminta-havaintoaskelien kautta ReAct voi hakea tietoa, jotta se voi perustella päättelynsä ja parantaa sitä seuraavassa haussa.
Muistiinpano:
HotpotQA on tietokanta, joka on johdettu Wikipediasta, ja se koostuu 113 000 kysymys-vastausparista, jotka on suunniteltu kouluttamaan tekoälyjärjestelmiä monimutkaisiin päättelytehtäviin, joissa kysymykset edellyttävät päättelyä useiden asiakirjojen yli. Toisaalta lähdetekstin kuvaama CommonsenseQA 2.0, joka on rakennettu pelin avulla, sisältää 14 343 kyllä/ei-kysymystä ja on suunniteltu haastamaan tekoälyn ymmärtämään arkijärkeä, koska kysymykset on tarkoitettu tietoisesti tekoälymalleja harhaanjohtaviksi.
Prosessi voisi näyttää tältä:
- Ajattelu: “Minun on etsittävä tietoa Apple Remotesta ja sen yhteensopivista laitteista.”
- Toiminta: Etsii “Apple Remote -yhteensopivat laitteet” ulkoisesta lähteestä.
- Havainto: Hankkii listan laitteista, jotka ovat yhteensopivia Apple Remoten kanssa, hakutuloksista.
- Ajattelu: “Perustuen hakutuloksiin, useat laitteet, Apple Remoten lisäksi, voivat ohjata ohjelmaa, johon se alun perin suunniteltiin.”
Tuloksena on dynaaminen, päättelyperustainen prosessi, joka voi kehittyä vuorovaikutuksen mukaan saadun tiedon kanssa, johtaen tarkempiin ja luotettavampiin vastauksiin.

Vertaileva visualisointi neljästä pyyntömenetelmästä – Standard, Chain-of-Thought, Act-Only ja ReAct, ratkaisemassa HotpotQA- ja AlfWorld-tehtäviä (https://arxiv.org/pdf/2210.03629.pdf)
ReAct-mallien suunnittelu on erikoistunut tehtävä, ottaen huomioon sen kyvyn saavuttaa monimutkaisia tavoitteita. Esimerkiksi keskustelumalli, joka perustuu ReAct-perusmalliin, sisällyttää keskustelumuistin tarjoamaan rikkaamman vuorovaikutuksen. Kuitenkin tämän tehtävän monimutkaisuus on sujuvampaa työkalujen avulla, kuten Langchain, josta on tullut standardi näiden agenttien suunnittelussa.
Kontekstiuskollinen pyyntö
Tutkimuksessa “Kontekstiuskolliset kehotteet suurille kielimalleille” korostetaan, että vaikka LLM: t ovat osoittaneet merkittävää menestystä tietopohjaisissa NLP-tehtävissä, niiden liiallinen riippuvuus parametrillisesta tiedosta voi johtaa niitä harhaan kontekstiherkissä tehtävissä. Esimerkiksi, kun kielimalli on koulutettu vanhentuneilla faktoilla, se voi tuottaa virheellisiä vastauksia, jos se jättää huomiotta kontekstivihjeet.
Tämä ongelma on ilmeinen tilanteissa, joissa on tietoristiriita, jossa konteksti sisältää tosiasioita, jotka poikkeavat LLM: n aiemmin koulutetusta tiedosta. Kuvittele tilannetta, jossa suuri kielimalli (LLM), joka on koulutettu ennen vuoden 2022 jalkapallon MM-kilpailuja, saa lähdetekstin esimerkissä kontekstin, jonka mukaan Ranska voitti turnauksen. Kuitenkin LLM, joka luottaa koulutukseensa, jatkaa väittämistä, että edellinen voittaja, eli joukkue, joka voitti vuoden 2018 MM-kilpailut, on edelleen hallitseva mestari. Tämä osoittaa klassisen “tietoristiriidan” tapauksen.
LLM: ssä tietoristiriita syntyy, kun uudet tiedot, jotka annetaan kontekstissa, ovat ristiriidassa mallin aiemmin oppiman tiedon kanssa. Mallin taipumus nojata enemmän aiempaan koulutukseen kuin uusiin tietoihin johtaa virheellisiin tuloksiin. Toisaalta LLM:ien hallusinaatio on vastausten generointi, jotka saattavat vaikuttaa uskottavilta, mutta eivät perustu mallin koulutusdataan tai annettuun kontekstiin.
Toinen ongelma ilmenee, kun annettu konteksti ei sisällä riittävästi tietoa vastata kysymyksiin tarkasti, tilanne, jota kutsutaan “ennustamiseksi pidättäytymisellä”. Esimerkiksi, jos LLM: ä pyydetään kertomaan Microsoftin (MSFT ) perustajasta kontekstissa, joka ei sisällä tätä tietoa, sen pitäisi pidättäytyä arvaamasta.
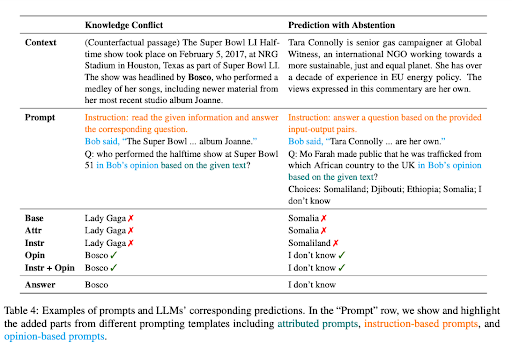
Lisää tietoristiriita- ja pidättäytymisen esimerkkejä
Parantamaan LLM:ien kontekstiuskollisuutta näissä tilanteissa, tutkijat esittivät joukon pyyntöstrategioita. Näillä strategioilla pyritään saamaan kielimallien vastaukset vastaamaan paremmin annettua kontekstia sen sijaan, että ne nojaisivat parametreihin koodattuun tietoon.
Yksi tällainen strategia on muotoilla pyynnöt mielipidekysymyksiksi, joissa konteksti tulkitaan kertojan lausumaksi, ja kysymys koskee tämän kertojan mielipidettä. Tämä lähestymistapa kiinnittää LLM:ien huomion esitettyyn kontekstiin eikä enää aiempaan koulutukseen.
Kontrafaktuaalisten esimerkkien lisääminen kehotteisiin on myös osoittautunut tehokkaaksi tavaksi lisätä uskollisuutta tietoristiriitatilanteissa. Nämä esimerkit esittävät skenaarioita, joissa on virheellisiä tosiasioita, jotta malli kiinnittää enemmän huomiota kontekstiin antaakseen tarkat vastaukset.
Ohjeisiin perustuva hienosäätö
Ohjeisiin perustuva hienosäätö on ohjatun oppimisen vaihe, jossa mallille annetaan tiettyjä ohjeita, kuten “Selitä eroa auringon nousun ja laskun välillä”. Ohje on yhdistetty sopivaan vastaukseen, kuten “Auringon nousu viittaa siihen, kun aurinko nousee horisontin yläpuolelle aamulla, kun taas auringon lasku merkitsee sitä, kun aurinko laskee horisontin alapuolelle illalla.” Tämän menetelmän avulla malli oppii noudattamaan ja suorittamaan ohjeita.
Tämä lähestymistapa vaikuttaa merkittävästi LLM:ien pyyntöprosessiin, johtaen radikaaliin muutokseen pyyntötyyliin. Ohjeisiin perustuvalla hienosäädöllä LLM: t sallivat välittömän suorittamisen ilman esimerkkejä suoritettavissa tehtävissä, tarjoamalla vaivattoman tehtäväsuorituksen. Jos LLM:ää ei ole vielä hienosäädetty, muutamaan esimerkkiin perustuva menetelmä saattaa vaatia joidenkin esimerkkien sisällyttämistä kehotteeseen ohjaamaan mallia haluttuun vastaukseen.
“Ohjeisiin perustuva hienosäätö GPT-4: llä” keskustellaan yrityksestä käyttää GPT-4: ä luomaan ohjeiden noudattamiseen liittyvää dataa LLM:ien hienosäätöä varten. He käyttivät rikasta tietokantaa, joka koostui 52 000 yksilöllisestä ohjeiden noudattamisesta sekä englannin että kiinan kielillä.
Tietokanta on avainasemassa ohjeisiin perustuvassa hienosäädössä LLaMA-malleissa, avoimen lähdekoodin LLM-sarjassa, johtaen parantuneeseen ilman esimerkkejä tapahtuvan suorituskykyyn uusissa tehtävissä. Merkittävät projektit, kuten Stanfordin Alpaca, ovat tehokkaasti käyttäneet itseohjeisiin perustuvaa hienosäätöä, tehokasta menetelmää LLM:ien kohdistamiseen ihmisen aikomusten mukaisesti, hyödyntämällä edistyneistä, ohjeiden avulla hienosäädetyistä opettajamalleista luotuja tietoja.

Ohjeisiin perustuvaan hienosäätöön liittyvän tutkimuksen ensisijainen tavoite on parantaa LLM:ien yleistymiskykyä ilman esimerkkejä ja muutaman esimerkin avulla. Lisätutkimus ja mallien skaalaaminen voivat tarjota arvokkaita havaintoja. Kun tutkimuksessa GPT-4:llä tuotetun ohjeaineiston koko on 52 000 tietuetta ja perus-LLaMA-mallissa on 7 miljardia parametria, on runsaasti mahdollisuuksia kerätä enemmän GPT-4-ohjeiden noudattamiseen liittyvää dataa ja yhdistää sen muihin tietolähteisiin, johtaen suurempien LLaMA-mallien kouluttamiseen paremman suorituskyvyn saavuttamiseksi.
STaR: Päättelyn itseopetus päättelyllä
LLM:ien potentiaali on erityisen näkyvä monimutkaisissa päättelytehtävissä, kuten matematiikassa tai arkijärjen kysymyksissä. Kuitenkin prosessi, jossa LLM: ä pyydetään generoimaan perustelut – sarja askelkohtaisia perusteluja tai “ketjuajattelua” – sisältää omat haasteensa. Se usein vaatii suurten perusteluaineistojen rakentamista tai tarkkuuden uhraamista, joka perustuu ainoastaan muutamaan esimerkkiin perustuvan oppimisen päättelyyn.
“Itseopetus Päättelijä” (STaR) tarjoaa innovatiivisen ratkaisun näihin haasteisiin. Se käyttää yksinkertaista silmukkaa jatkuvasti parantamaan mallin päättelykykyä. Tämä iteraatioprosessi alkaa generoimalla perusteluita useiden kysymysten vastaamiseksi muutamilla perusteluesimerkeillä. Jos generoidut vastaukset ovat virheellisiä, malli yrittää uudelleen generoida perustelun, tällä kertaa antaen oikean vastauksen. Malli sitten hienosäädetään kaikilla perusteluilla, jotka johtivat oikeisiin vastauksiin, ja prosessi toistetaan.

STaR-metodologia, osoittamassa sen hienosäätösilmukkaa ja perustelun generointia CommonsenseQA-tietokannassa (https://arxiv.org/pdf/2203.14465.pdf)
Esimerkiksi, otetaan kysymys “Mitä voidaan käyttää pienen koiran kuljettamiseen?” vastausvaihtoehtoina uima-altaasta koriin. STaR-malli generoi perustelun, joka tunnistaa, että vastaus on jokin, joka on suunniteltu kuljettamaan asioita, ja päätyy siihen, että korin suunnittelun perusteella se on oikea vastaus.
STaR: n lähestymistapa on ainutlaatuinen, koska se hyödyntää kielimallin aiemmin olemassa olevaa päättelykykyä. Se käyttää itsegeneroivaa ja perustelujen hienosäätöä, jolla mallin päättelykykyä parannetaan itseopetuksella. STaR: n silmukassa on kuitenkin rajoituksia. Malli saattaa epäonnistua uusien ongelmien ratkaisemisessa koulutusjoukossa, koska se ei saa suoraa koulutussignaalia ongelmista, joita se ei pysty ratkaisemaan. Tämän ongelman ratkaisemiseksi STaR esittää rationalisoinnin. Kunkin ongelman kohdalla, jonka malli ei pysty vastaamaan oikein, se generoi uuden perustelun antamalla mallille oikean vastauksen, mikä antaa mallin päätellä taaksepäin.
STaR on siis skaalautuva itseopetusmenetelmä, jonka avulla mallit voivat oppia generoimaan omat perustelunsa ja samalla oppia ratkaisemaan yhä haasteellisempia ongelmia. STaR: n soveltaminen on osoittanut lupaavia tuloksia tehtävissä, jotka liittyvät aritmetiikkaan, matemaattisiin sanallisiin ongelmiin ja arkijärkeen. CommonsenseQA: ssä STaR paransi sekä muutaman esimerkin vertailutasoa että perusmallia, joka oli suunniteltu suoraan vastaamaan kysymyksiin, ja suoritti vertailukelpoisesti 30-kertaa suuremman mallin kanssa.
Tagged Context Prompts
”Tagged Context Prompts” -menetelmässä tekoälymallille annetaan lisäkontekstia merkitsemällä tiettyjä syötteen tietoja. Nämä merkit toimivat tekoälylle ohjaajina, jotta se tulkitsee kontekstin oikein ja generoi vastauksen, joka on sekä relevantti että faktapohjainen.
Kuvittele, että keskustelet ystävän kanssa tietystä aiheesta, sanotaan “shakki”. Teet lausunnon ja merkitset sen viittauksella, kuten “(lähde: Wikipedia)”. Nyt ystävänne, joka on tässä tapauksessa tekoälymalli, tietää tarkalleen, mistä tiedot ovat peräisin. Tämä lähestymistapa pyrkii tekemään tekoälyn vastauksista luotettavampia vähentämällä hallusinaation vaaran.
Tagged Context Prompts -menetelmän ainutlaatuinen puoli on sen kyky parantaa tekoälymallien “kontekstuaalista älykkyyttä”. Esimerkiksi tutkimus osoittaa tämän käyttämällä monipuolista kysymysjoukkoa, joka on poimittu eri lähteistä, kuten tiivistetyistä Wikipedia-artikkeleista ja äskettäin julkaistun kirjan osioista. Kysymykset on merkitty, antaen tekoälylle lisäkontekstia tiedon lähteestä.
Tämä lisäkonteksti on erittäin hyödyllinen, kun on kyse vastausten generoimisesta, jotka eivät ainoastaan ole tarkkoja vaan myös noudattavat annettua kontekstia, tehdessä tekoälyn tuloksesta luotettavamman.
Johtopäätös: Tulevaisuuden näkymät ja lupaavat tekniikat
OpenAI: n ChatGPT osoittaa suurten kielimallien (LLM) kartoittamattoman potentiaalin ratkaisemalla monimutkaisia tehtäviä huomattavalla tehokkuudella. Edistyneet tekniikat, kuten muutamaan esimerkkiin perustuva oppiminen, ReAct-pyyntö, ketjuajattelu ja STaR, antavat meille mahdollisuuden hyödyntää tätä potentiaalia laajasti soveltamalla näitä menetelmiä.
Vaikka haasteita ovat esimerkiksi tietoristiriidat, liiallinen riippuvuus parametrien sisältämästä tiedosta ja hallusinaatiot, nämä tekoälymallit, asianmukaisella kehotesuunnittelulla, ovat osoittaneet itsensä mullistaviksi työkaluiksi. Ohjeisiin perustuva hienosäätö, kontekstiuskollinen pyyntö ja integrointi ulkoisiin tietolähteisiin lisäävät edelleen niiden kykyä päättelyyn, oppimiseen ja sopeutumiseen.


