
Fundamentos de la IA
¿Qué es la auto‑atención? El mecanismo que impulsa a los transformadores
La auto‑atención permite que cada token construya una representación sensible al contexto al ponderar la información de otros tokens en la misma secuencia. Esta guía explica el mecanismo, los compromisos, la evaluación y los controles que importan en la práctica.

 Añade Unite.AI a tus fuentes preferidas en Google
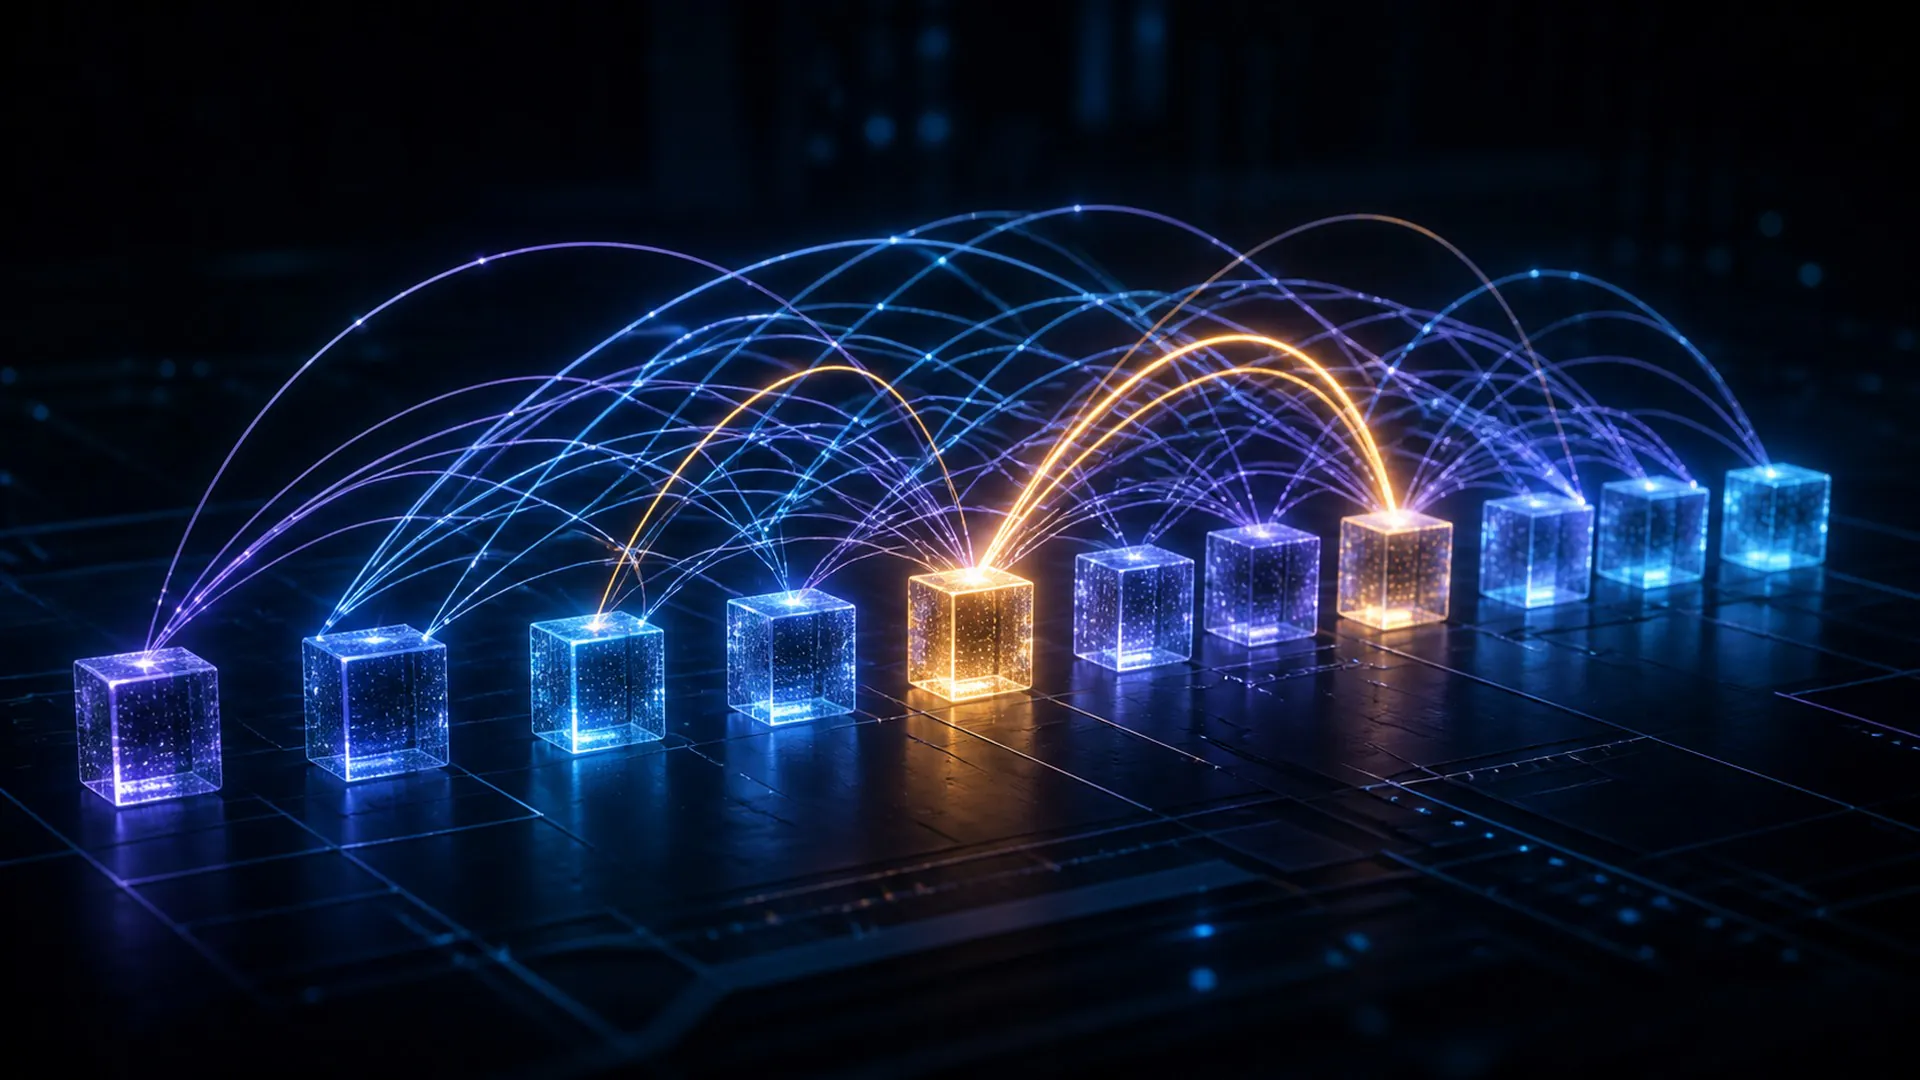
La auto‑atención permite que cada token construya una representación sensible al contexto al ponderar la información de los demás tokens de la misma secuencia.
La auto‑atención merece una explicación precisa porque su nombre identifica un flujo de información particular, una elección de entrenamiento, un mecanismo en tiempo de ejecución o un límite de gobernanza. Tratarla como sinónimo de “IA avanzada” hace que las afirmaciones sean imposibles de probar. Esta guía sigue el concepto desde su entrada y supuestos hasta su resultado observable, y luego evalúa el atajo que con mayor probabilidad se confunde con ella.
Auto‑atención: Definición, Límite y Propósito
La auto‑atención permite que cada token construya una representación sensible al contexto al ponderar la información de los demás tokens de la misma secuencia. La definición contiene tres compromisos prácticos: existe una entrada identificable, una transformación o decisión característica de la auto‑atención y un resultado que puede evaluarse frente a un objetivo declarado. Si falta alguno de esos elementos, la etiqueta puede describir una aspiración más que un mecanismo implementado.
Las pilas modernas de IA construyen abstracciones una sobre otra: las representaciones respaldan arquitecturas, el preentrenamiento crea capacidades reutilizables, la adaptación modifica el comportamiento y las optimizaciones de despliegue determinan lo que es práctico. Para la auto‑atención, esta visión sistémica importa porque el rendimiento puede depender de los datos circundantes, las interfaces, el hardware, los permisos y las personas, incluso cuando el modelo subyacente no cambia. Por lo tanto, una explicación útil separa el comportamiento aprendido por el modelo del producto que decide cuándo, dónde y con qué autoridad se utiliza ese comportamiento.
El atajo engañoso más cercano es un modelo recurrente que debe transportar la información paso a paso. Puede compartir una característica visible con la auto‑atención, pero altera la historia causal: diferentes evidencias establecerían el éxito, diferentes recursos dominarían el costo y diferentes controles evitarían daños. Por lo tanto, el límite es operativo más que terminológico.
Mapa operativo de cinco etapas de la auto‑atención
El diagrama es un mapa causal compacto para la auto‑atención, no una afirmación de que todas las implementaciones utilicen cinco componentes de software. Algunos sistemas combinan etapas y otros las repiten en un bucle. El mapa sigue siendo útil porque obliga a que cada cambio en la información o autoridad tenga un responsable, una entrada, una salida y una prueba.
1. Proyectar tokens en consultas, claves y valores: Entrada y suposiciones en la auto‑atención
En esta etapa de la auto‑atención, el sistema debe proyectar los tokens en consultas, claves y valores. La pregunta útil no es solo si esa operación ocurre, sino qué información consume, qué estado modifica y qué evidencia demuestra que el cambio es válido. Un revisor debe poder distinguir la operación de un modelo recurrente que debe transportar la información paso a paso y reproducir su resultado bajo las mismas condiciones declaradas.
La transferencia a esta etapa de la auto‑atención comienza con el objetivo declarado y debe terminar con un resultado que pueda respaldar la comparación de cada consulta con las claves relevantes. Registre la incertidumbre, las alternativas rechazadas, el uso de recursos y cualquier control humano o de software aplicado en el límite. Ese rastro es donde los equipos pueden detectar si el costo crece rápidamente con la longitud de la secuencia y si los pesos de atención no son una explicación completa del razonamiento antes de que la misma debilidad llegue a una salida consecuente.
2. Comparar cada consulta con claves relevantes: Representación o decisión en la auto‑atención
En esta etapa de la auto‑atención, el sistema debe comparar cada consulta con las claves relevantes. La pregunta útil no es solo si esa operación ocurre, sino qué información consume, qué estado modifica y qué evidencia demuestra que el cambio es válido. Un revisor debe poder distinguir la operación de un modelo recurrente que debe transportar la información paso a paso y reproducir su resultado bajo las mismas condiciones declaradas.
La transferencia a esta etapa de Auto‑atención comienza con proyectar los tokens en consultas, claves y valores y debe terminar con un resultado que pueda soportar la escalabilidad y normalizar las puntuaciones. Registre la incertidumbre, las alternativas rechazadas, el uso de recursos y cualquier control humano o de software aplicado en el límite. Esa trazabilidad es donde los equipos pueden detectar si el costo crece rápidamente con la longitud de la secuencia y si los pesos de atención no explican completamente el razonamiento antes de que la misma debilidad llegue a una salida consecuente.
3. Escalar y Normalizar las Puntuaciones: Transformación Distintiva en la Auto‑atención
En esta etapa de la Auto‑atención, el sistema debe escalar y normalizar las puntuaciones. La pregunta útil no es solo si esa operación ocurre, sino qué información consume, qué estado modifica y qué evidencia demuestra que el cambio fue válido. Un revisor debe poder distinguir la operación de un modelo recurrente que debe transportar la información paso a paso y reproducir su resultado bajo las mismas condiciones declaradas.
La transferencia a esta etapa de Auto‑atención comienza comparando cada consulta con las claves relevantes y debe terminar con un resultado que pueda combinar valores usando esos pesos. Registre la incertidumbre, las alternativas rechazadas, el uso de recursos y cualquier control humano o de software aplicado en el límite. Esa trazabilidad es donde los equipos pueden detectar si el costo crece rápidamente con la longitud de la secuencia y si los pesos de atención no explican completamente el razonamiento antes de que la misma debilidad llegue a una salida consecuente.
4. Combinar Valores Usando Esos Pesos: Límite de Restricción y Verificación en la Auto‑atención
En esta etapa de la Auto‑atención, el sistema debe combinar valores usando esos pesos. La pregunta útil no es solo si esa operación ocurre, sino qué información consume, qué estado modifica y qué evidencia demuestra que el cambio fue válido. Un revisor debe poder distinguir la operación de un modelo recurrente que debe transportar la información paso a paso y reproducir su resultado bajo las mismas condiciones declaradas.
La transferencia a esta etapa de Auto‑atención comienza escalando y normalizando las puntuaciones y debe terminar con un resultado que pueda repetirse a través de cabezas y capas. Registre la incertidumbre, las alternativas rechazadas, el uso de recursos y cualquier control humano o de software aplicado en el límite. Esa trazabilidad es donde los equipos pueden detectar si el costo crece rápidamente con la longitud de la secuencia y si los pesos de atención no explican completamente el razonamiento antes de que la misma debilidad llegue a una salida consecuente.
5. Repetir a Través de Cabezas y Capas: Salida, Retroalimentación y Regla de Detención en la Auto‑atención
En esta etapa de la Auto‑atención, el sistema debe repetirse a través de cabezas y capas. La pregunta útil no es solo si esa operación ocurre, sino qué información consume, qué estado modifica y qué evidencia demuestra que el cambio fue válido. Un revisor debe poder distinguir la operación de un modelo recurrente que debe transportar la información paso a paso y reproducir su resultado bajo las mismas condiciones declaradas.
La transferencia a esta etapa de Auto‑atención comienza combinando valores usando esos pesos y debe terminar con un resultado que pueda soportar la monitorización o una decisión final. Registre la incertidumbre, las alternativas rechazadas, el uso de recursos y cualquier control humano o de software aplicado en el límite. Esa trazabilidad es donde los equipos pueden detectar si el costo crece rápidamente con la longitud de la secuencia y si los pesos de atención no explican completamente el razonamiento antes de que la misma debilidad llegue a una salida consecuente.
Lea el mapa de Auto‑atención hacia adelante para comprender la producción y hacia atrás para diagnosticar fallos. El análisis hacia adelante pregunta cómo una etapa alimenta a la siguiente. El análisis hacia atrás parte de un resultado incorrecto, lento, costoso o inseguro y rastrea qué suposición anterior lo permitió. La ruta inversa es a menudo donde un equipo descubre que el error decisivo ocurrió antes de que el modelo produjera cualquier cosa.
Un Ejemplo Práctico de Auto‑atención
En una oración con dos posibles antecedentes, la atención puede incorporar el sustantivo relevante en la representación del pronombre.
Este ejemplo es informativo porque la Auto‑atención puede vincularse a entradas observables, estados intermedios y un resultado, en lugar de juzgarse mediante una demostración pulida. Una prueba rigurosa construiría casos ordinarios, difíciles y deliberadamente engañosos alrededor del escenario, preservaría una línea base sin la técnica y registraría tanto el rendimiento medio como la gravedad de los fallos individuales.
Cambie una suposición en el ejemplo de Auto‑atención y repita el análisis. Elimine una entrada requerida, introduzca una señal conflictiva, limite el cómputo, altere la población de usuarios o obligue al sistema a abstenerse. Un mecanismo que solo tiene éxito bajo una demostración cuidadosamente arreglada no ha demostrado que se generalice al entorno operativo.
Auto‑atención vs. Su Atajo Más Común
La Auto‑atención a menudo se reduce a un modelo recurrente que debe transportar la información paso a paso. Esa reducción elimina el propio límite que define el concepto. Puede llevar a los compradores a comparar productos incongruentes, a los investigadores a sobreestimar lo que demuestra un experimento y a los operadores a monitorizar la señal equivocada después del despliegue.
| Lente | Respuesta práctica |
|---|---|
| Definición | La auto‑atención permite que cada token construya una representación sensible al contexto al ponderar la información de otros tokens en la misma secuencia. |
| Confusión | un modelo recurrente que debe transportar información paso a paso. |
| Riesgo | el costo crece rápidamente con la longitud de la secuencia y los pesos de atención no son una explicación completa del razonamiento. |
La comparación también debe identificar la unidad de análisis. Un artículo sobre Self-attention puede aislar un modelo o algoritmo, mientras que un servicio implementado añade recuperación, enrutamiento, caché, políticas, identidad, interfaces de usuario y monitoreo. Dos productos pueden usar el mismo término principal mientras implementan diferentes partes de esa pila. Pregunte qué componente realiza la transformación definitoria y qué otros componentes son necesarios para el resultado reportado.
Por qué la auto‑atención es importante en los sistemas de IA actuales
La auto‑atención es importante ahora porque a los sistemas de IA se les están proporcionando contextos más amplios, más modalidades, mayor capacidad de cómputo en tiempo de ejecución, acceso más amplio a herramientas y conexiones más profundas con decisiones organizacionales. En esas condiciones, lo que antes parecía un detalle de investigación puede determinar la latencia, la seguridad, la accesibilidad, el costo ambiental, la calidad del producto o la responsabilidad legal.
La medida relevante no es si la auto‑atención puede producir un solo resultado impresionante. Es si la técnica mejora un resultado que importa en condiciones representativas y lo hace de manera más eficaz que una línea base más simple. Informe distribuciones, categorías de fallas, latencia de cola, uso de recursos y subgrupos afectados en lugar de comprimir todos los resultados en un solo promedio.
La elección técnica adecuada depende de la carga de trabajo y del hardware. Compare una línea base simple, mida la calidad en fragmentos representativos y siga la memoria, la latencia, el costo y la mantenibilidad junto con la precisión del benchmark. Aplicado específicamente a la auto‑atención, esa disciplina hace que la evidencia sea portable: otro equipo puede juzgar si la ganancia alegada probablemente sobrevivirá a un modelo, idioma, plataforma de hardware, conjunto de datos, población de usuarios o tolerancia al riesgo diferentes.
Beneficios que la auto‑atención puede ofrecer
La razón más fuerte para usar la auto‑atención es que puede abordar directamente su cuello de botella previsto. Según la implementación, el beneficio puede manifestarse como una mejor fundamentación, una representación más fiel, una generalización mejorada, menor latencia, reducción del movimiento de memoria, mayor claridad en la rendición de cuentas o un límite más seguro entre la propuesta de un modelo y una acción real.
Los beneficios deben expresarse como decisiones y mediciones. “Más inteligente” no es un criterio de aceptación para la auto‑atención. Un objetivo útil podría especificar la tasa de error en casos difíciles, la recuperación tras evidencia conflictiva, el costo en un percentil del tráfico, el tiempo de revisión humana, la calibración o el porcentaje de acciones mantenidas dentro de un límite de autoridad definido.
El modo de falla que define la auto‑atención
La limitación central es que el costo crece rápidamente con la longitud de la secuencia y los pesos de atención no son una explicación completa del razonamiento. Esta falla no es una reflexión posterior para enumerarla una vez que el desarrollo está completo. Debe influir en la recopilación de datos, la arquitectura, los permisos, la evaluación, los criterios de lanzamiento y el monitoreo de la auto‑atención desde el principio.
Un control para la auto‑atención solo es útil si actúa antes de una consecuencia costosa o irreversible. Identifique el precursor observable más temprano del fallo, establezca un umbral o regla, asigne un responsable y pruebe la recuperación. Según el caso de uso, la recuperación puede significar abstenerse, recurrir a un sistema más simple, solicitar más evidencia, escalar a una persona, revertir un modelo o detener una acción por completo.
Un plan de evaluación para la auto‑atención
Comience la evaluación de la auto‑atención redactando la decisión que la evidencia debe respaldar. Defina la población operativa, la consecuencia de un resultado incorrecto, la información realmente disponible en el momento de la decisión y la alternativa creíble más simple. Esto evita que un benchmark se convierta en el objetivo solo porque es fácil de ejecutar.
Utilice un conjunto de pruebas sin modificar para comparaciones controladas y luego valide la auto‑atención en un entorno operativo por etapas. La evaluación offline hace que las variantes sean comparables; el modo sombra, los canarios, los límites de velocidad o las puertas de aprobación revelan cómo el tráfico real, los bucles de retroalimentación y las personas cambian el comportamiento. La fase de despliegue debe contar con una condición de parada explícita en lugar de asumir que toda mejora merece una implementación completa.
Versione las entradas necesarias para reproducir la auto‑atención: datos de origen, preprocesamiento, tokenizador o codificador, pesos del modelo, configuración, prompt o política, índice de recuperación, conjunto de evaluación, supuestos de hardware y código de servicio según corresponda. Sin trazabilidad, un equipo no puede determinar si un resultado modificado provino de la técnica, del entorno o de una edición de la canalización no detectada.
Finalmente, pregunte qué hallazgo falsificaría la afirmación de que la auto‑atención ayuda. Si ningún resultado pudiera revertir la decisión de adopción, la evaluación es marketing. Los umbrales de aceptación preestablecidos y un conjunto de confirmación preservado convierten el ejercicio en evidencia.
Preguntas que hacer antes de adoptar la auto‑atención
- Objetivo: ¿Qué cuello de botella medible pretende resolver la auto‑atención?
- Mecanismo: ¿Cuál de las cinco etapas contiene la transformación distintiva?
- Línea base: ¿Cómo se compara con un modelo recurrente que debe transportar información paso a paso o con otra alternativa más simple?
- Evidencia: ¿Qué casos ordinarios, difíciles, adversariales y de subgrupos se probaron?
- Operaciones: ¿Qué costos de latencia, memoria, cómputo, energía, mantenimiento y revisión aparecen a gran escala?
- Riesgo: ¿Cómo detectará el equipo que el costo crece rápidamente con la longitud de la secuencia y que los pesos de atención no son una explicación completa del razonamiento?
- Recuperación: ¿Puede el sistema abstenerse, recurrir, revertir o escalar antes de causar daño?
Fuentes principales para estudiar la auto‑atención
Los puntos de partida autoritativos para la parte de la pila de IA que rodea la auto‑atención incluyen Attention Is All You Need, artículo de investigación LoRA, Direct Preference Optimization. Léelos junto con la documentación del modelo exacto, el conjunto de datos, el hardware y la jurisdicción involucrados. Una fuente general puede definir el mecanismo, pero solo la evidencia específica de la implementación puede establecer que una implementación particular es adecuada.
Qué recordar sobre la auto‑atención
La auto‑atención es un mecanismo definido dentro de un sistema sociotécnico más amplio. Su valor proviene de mejorar un resultado específico bajo condiciones explícitas, no de la etiqueta en sí. El mapa de cinco etapas hace visible su flujo de información, la comparación identifica lo que no es, y la ruta de control muestra dónde un operador responsable puede intervenir.
La regla práctica para la auto‑atención es definir el objetivo, compararlo con una línea base creíble, probar el fallo que más importa y conservar la evidencia necesaria para monitorear el cambio. Con esos elementos, el concepto se convierte en una elección de ingeniería y gobernanza que puede evaluarse. Sin ellos, sigue siendo un nombre prometedor asociado a un riesgo operativo desconocido.


