
Líderes de opinión
El próximo cuello de botella de energía de IA estará dentro de las ciudades

 Añade Unite.AI a tus fuentes preferidas en Google
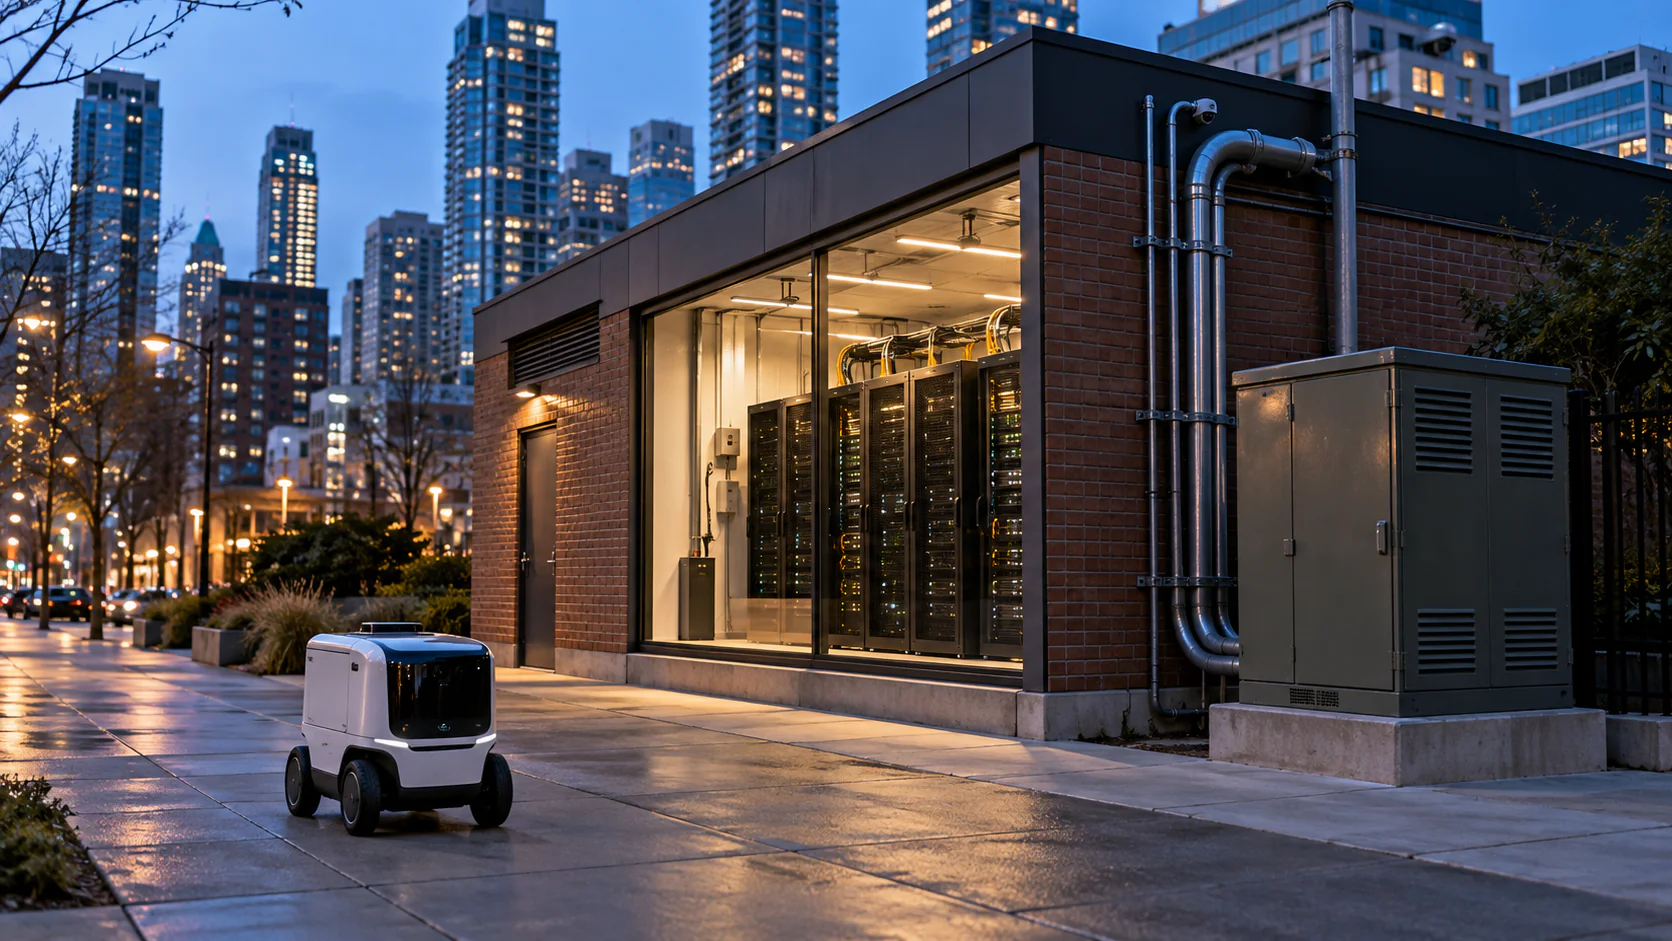
En los últimos años, y contando, el mercado de infraestructura de IA ha dedicado una gran cantidad de tiempo y dinero (cerca de $7 trillion de inversión en centros de datos para 2030, según la estimación de McKinsey) aprendiendo a construir grandes centros de datos donde haya energía disponible. “Donde” es la palabra clave porque la ubicación no era muy importante. Un clúster de entrenamiento simplemente necesita acceso a suficiente energía. Pero la ubicación está empezando a ser cada vez más relevante hoy en día, a medida que el uso de la IA crece más allá de interfaces de chat hacia máquinas, sistemas de voz, video y aplicaciones que interactúan con el mundo físico. Tales operaciones requieren que la potencia de cálculo esté más cerca de los centros urbanos donde ocurren esas interacciones para mantener baja la latencia. Mientras que herramientas como los chatbots pueden tolerar medio segundo de retraso, aplicaciones de servicio automatizado como robots de entrega supervisados remotamente, asistentes de voz en vivo o sistemas de cumplimiento automatizado pueden necesitar reaccionar en milisegundos.
Este es el nuevo desafío para las empresas de IA. ¿Cómo encontrar bloques más pequeños de energía fiable en y alrededor de grandes áreas metropolitanas? Y aun después de haber localizado los sitios, ¿cómo afrontar la resistencia que están experimentando incluso los centros de datos remotos?
La demanda de IA en los centros urbanos está en aumento
Existe una demanda creciente dentro de la esfera urbana de IA que va más allá del uso personal de chatbots o de cualquier obsesión con los robots. Un documento de trabajo del FMI estima que el consumo eléctrico de los centros de datos y la IA ya había alcanzado entre 400 y 500 TWh a nivel mundial en 2023, y que el consumo impulsado por IA podría llegar potencialmente a 1 500 TWh para 2030. La automatización necesaria para hacer más eficientes operaciones simples —ya sea en el procesamiento de documentos o en el archivo de videos— requiere mucha energía a gran escala.
Las ciudades están a la vanguardia de esto, como se muestra en una revisión de la OCDE de 250 ciudades en 78 países. Encontró que el 56 % ya utilizaba IA activamente, mientras que otro 35 % estaba pilotando o planificando despliegues. Para ilustrar un caso de uso sencillo, consideremos las cámaras de vigilancia en la ciudad. IHS Markit estimó hace varios años que el número de cámaras de vigilancia en todo el mundo superaría los mil millones. Aunque se usan principalmente con fines de grabación, ahora también se emplean para tareas más exigentes computacionalmente, por ejemplo, rastrear objetos a través de una red, o buscar en grandes archivos de video mediante lenguaje natural. Tales procesos no pueden realizarse en cada cámara con el procesamiento de IA actual. ¿Deberían enviarse fuera de la ciudad a un centro de datos lejano para procesarse? Eso es poco práctico debido a las regulaciones de datos y al costo de mover volúmenes tan grandes de tráfico.
Una encuesta reciente de Gallup muestra que alrededor del 30 % de los empleados del sector privado y público utilizan IA en su función y los números están en aumento. Estos sectores —ya sea banca, hospitales u organizaciones del sector público— se enfrentan a los mismos problemas. Quieren infraestructura de IA dentro de su propia jurisdicción y físicamente lo suficientemente cerca para controlarla. Sus sistemas de voz interactiva y aplicaciones de video se degradan a medida que aumenta la latencia de la red. Incluso si el problema puede ser inicialmente eludido manteniendo a un operador humano para la primera generación de sistemas autónomos, esa supervisión en sí no es muy tolerante a la latencia. Por ejemplo, los robots de entrega y los robots domésticos supervisados mediante una conexión de video requieren un bucle de comunicación completo que debe mantenerse por debajo de aproximadamente 80 milisegundos, según un estudio remoto de teleoperación robótica. Los coches autónomos, contrariamente, son la excepción: la conducción se mantiene a bordo por razones de seguridad, y los operadores remotos de Waymo trabajan con un cuarto de segundo de latencia, algunos incluso desde otro continente. Lo que la ciudad hereda de las flotas autónomas son sus datos, no su volante.
El mercado de centros de datos está subestimando este aumento de la demanda. El Banco Mundial publicó un documento que muestra cómo los municipios en países como Argentina, India y Etiopía, entre otros, han adoptado IA en áreas de justicia, anticorrupción, aduanas, administración pública y mejora de servicios. Esto no es un caso local. Es una transformación global. En Teravolt, nuestra estimación es que una área metropolitana de 10 a 15 millones de habitantes podría soportar aproximadamente entre 6 y 13 MW de carga continua de IA sensible a la latencia para 2030, antes de que los robots de propósito general se desplieguen masivamente. Es cierto que no es una cifra muy grande a escala hiperescalar, pero encontrarla en el lugar adecuado es mucho más difícil de lo que parece. Para 2036, la misma área metropolitana pasa a 22 a 50 MW de carga sensible a la latencia —y a 60 a 100 MW si la industria automotriz comienza a producir robots a escala automotriz. La economía de la demanda es implacable en el mejor sentido: unos pocos cientos de dólares al año de costo de servidor en una máquina que reemplaza entre $30,000 y $60,000 de mano de obra es una demanda que no negocia el precio.
Añadiendo un cuarto nivel a la computación
Actualmente, la potencia computacional para IA existe en tres niveles. La capa superior está compuesta por gigafábricas que se utilizan para entrenar modelos. Su ubicación solo importa a los desarrolladores en la medida en que garantiza grandes cantidades de energía a un precio aceptable. Luego vienen las instalaciones regionales de IA, típicamente entre 20 y 200 MW, donde ocurre la demanda recurrente de inferencia en las principales operaciones de nube y empresariales. Por último, tenemos la potencia de cálculo integrada directamente en el dispositivo o el robot.
Parece que existe una brecha entre las dos últimas capas que identifico como la capa urbana — la brecha responsable de los problemas de latencia. Estas deberían ubicarse dentro o muy cerca de las grandes ciudades. Deberían medirse en megavatios de un solo dígito o bajo doble dígito mientras se sitúan dentro de áreas metropolitanas y están conectadas a fibra de alta calidad. El punto de partida podría ser alrededor de 2 MW si el sitio cuenta con energía garantizada. Para ilustrar su practicidad, consideremos un robot de reparto. Maneja diferentes solicitudes y no todas pueden procesarse en el propio dispositivo. Aunque se entrena en la gigafábrica, se necesitaría asistencia más avanzada en tiempo real que fuera procesada por una instalación urbana cercana en lugar de enviarla a una instalación regional cada vez.
El problema del tráfico bidireccional
Los centros de datos urbanos no serán simplemente puntos intermedios que reciben datos de los centros de entrenamiento, sino que también producirán grandes cantidades de datos que se enviarán de vuelta por la cadena.
Cada máquina autónoma y cada sistema rico en sensores acumulará información que necesitará ser procesada y enviada de vuelta para integrarse en el entrenamiento. Las flotas de robots que regresan a sus puntos de carga después de un turno enviarán una enorme cantidad de información útil sobre casos límite y operaciones diarias que los centros de datos necesitan para mejorar sus funciones. Imagine todo este tráfico enviado a la vez en la misma dirección. Creará un cuello de botella. Aquí es donde el centro de datos urbano resulta útil, ya que puede procesar parte de la carga antes de que abrume la instalación de computación regional. Puede identificar y descartar algunos datos erróneos mientras comprime y avanza las partes útiles.
Esencialmente, el centro de datos urbano proporciona una capa adicional de filtrado a las dos capas que lo preceden, haciendo que el flujo de datos esté aún más organizado.
¿Será el futuro un servidor en cada cuadra?
Aunque presento los servidores urbanos como una solución, también es simplemente demasiado costoso resolver los problemas de latencia con una proliferación desenfrenada. No importa el tamaño, un centro de datos sigue requiriendo una conexión a la red eléctrica, transformadores, refrigeración, seguridad, redes y personal. Estos costos no se reducen proporcionalmente con la carga de TI. Para ponerlo en perspectiva, una instalación de 0,5 MW sigue teniendo muchos de los mismos costos fijos que un sitio mucho más grande.
En nuestros proyectos, hemos observado que un centro de datos urbano independiente se vuelve económicamente viable alrededor de 5 a 8 MW. Incluso asumiendo que varios sitios pudieran compartir un centro de operaciones de red, el umbral solo baja a 1,5 a 3 MW. Por lo tanto, la conclusión sigue siendo la misma. Splitting 20 MW distribuidos en veinte ubicaciones en lugar de dos o tres ahorra casi nada de latencia dentro de una zona metropolitana — el anillo de fibra de la ciudad tiene solo unos pocos milisegundos de longitud — mientras multiplica el capital y el costo operativo.
Esta es la razón por la que creo que la industria debe reducir el tamaño y construir lo que llamo “subestaciones para la inteligencia”. Actualmente, los desarrolladores están aprendiendo a construir instalaciones regionales en el rango de 20 a 100 MW. El objetivo futuro es aplicar eso a sitios urbanos aún más pequeños para alcanzar el nivel de 2 MW adecuado para las grandes ciudades.
El obstáculo político
Superado el tema de la viabilidad económica, el desafío político sigue presente. Los centros de datos se han vuelto cada vez más vilipendiados en los medios por su impacto adverso en el medio ambiente. Según una encuesta de Pew, más de la mitad de los estadounidenses consideran que los centros de datos son dañinos para el medio ambiente y tienen opiniones negativas al respecto. El argumento de la creación de empleo palidece en comparación con la cantidad de agua, tierra y electricidad consumidas; así como el ruido y las emisiones generadas. Obtener aprobaciones incluso para instalaciones urbanas más pequeñas resultará difícil.
Ya estamos viendo ejemplos de desarrolladores de centros de datos y autoridades municipales en conflicto. En EE. UU., el uso de turbinas de gas por parte de xAI para acelerar su expansión en Memphis ha generado disputas de permisos, oposición comunitaria y litigios. Europa ha ido más allá: Ámsterdam impuso una moratoria a instalaciones superiores a 70 MW, Dublín ahora solo admite nuevos centros de datos si aportan su propia generación o almacenamiento, y la subestación clave del corredor del oeste de Londres no se reforzará antes de principios de la década de 2030. Incluso fuera de casos de alto perfil, al tratarse de una nueva área de controversia, muchas autoridades municipales no tienen un proceso de aprobación claro para autorizar 10 MW adicionales de infraestructura de IA dentro del área urbana. Como señala un informe de la National League of Cities, uno de los desafíos más comunes para las ciudades es que los códigos de zonificación locales más antiguos no abordan explícitamente los centros de datos, lo que lleva a revisiones caso por caso. Tales incertidumbres legales pueden retrasar incluso proyectos técnicamente viables.
Las decisiones de infraestructura de hoy moldean nuestra capacidad para el futuro
Todo esto significa que debemos planificar y construir de forma preventiva la infraestructura necesaria para los futuros avances en IA. Porque, aunque los modelos se desarrollan rápidamente, la energía necesaria para ejecutarlos depende de un tipo de infraestructura que lleva tiempo construir. Las conexiones a la red pueden tardar años, y en algunos de los principales mercados de centros de datos, las colas ahora se extienden a siete a diez años. Así que, si las ciudades están aumentando la potencia de computación de IA para 2030, esa infraestructura eléctrica debe implementarse ahora. En Teravolt, nuestro modelo operativo estima que la demanda mundial de IA urbana será de 9 a 18 GW para 2036. Eso implica alrededor de 1.000 a 1.500 sitios urbanos y metropolitanos significativos en todo el mundo, según el tamaño promedio de las instalaciones, y en conjunto, podría representar un mercado valorado en aproximadamente $500 billion to $1 trillion.
Si no se lleva a cabo la planificación necesaria, nos quedaremos atrapados con una capacidad avanzada de IA que no podremos aprovechar. La era móvil necesitó contar con la infraestructura de torres para la cobertura de radio que siguiera a las personas; de lo contrario, el teléfono móvil habría sido irrelevante. Del mismo modo, debemos reconocer la discrepancia entre la evolución de la IA y la instalación de la infraestructura eléctrica. Donde la era móvil medía la cobertura en barras de señal, la era de la IA la medirá en milisegundos y vatios por residente — y no necesitará millones de torres, sino aproximadamente mil instalaciones del tamaño de una subestación. La fibra, los milisegundos y los megavatios son la moneda en este campo, y quienes reconocen esta escasez con anticipación están mejor posicionados para dar forma al futuro.


