
Ángulo de Anderson
Hacia la creación de humanos mediante IA en tiempo real con Neural Lumigraph Rendering

 Añade Unite.AI a tus fuentes preferidas en Google
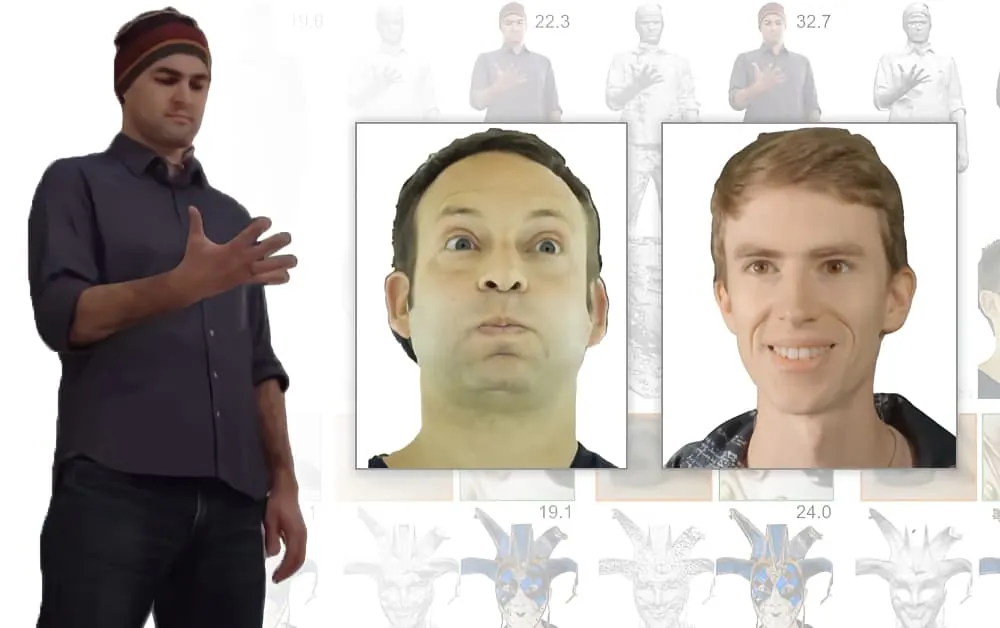
Puntos claveLa renderización Neural Lumigraph mejora NeRF en aproximadamente dos órdenes de…
Ver más
- La renderización Neural Lumigraph mejora NeRF en aproximadamente dos órdenes de magnitud.
- NLR utiliza redes SIREN para combinar las fortalezas de NeRF e IDR en gráficos en tiempo real.
- NLR carece de capacidades de iluminación dinámica y de reiluminación, lo que limita la salida a la iluminación del momento de la captura.
Pese al actual auge del interés por los campos de radiancia neuronal (NeRF), una tecnología capaz de crear entornos y objetos 3D generados por IA, este nuevo enfoque de la síntesis de imágenes todavía requiere mucho tiempo de entrenamiento y carece de una implementación que permita interfaces muy reactivas en tiempo real.
Sin embargo, una colaboración entre algunas figuras destacadas de la industria y el mundo académico ofrece una nueva perspectiva para abordar este desafío, conocido genéricamente como síntesis de nuevas vistas (NVS, por sus siglas en inglés).
El artículo de investigación, titulado Neural Lumigraph Rendering, afirma que mejora el estado del arte en aproximadamente dos órdenes de magnitud, lo que representa varios pasos hacia la renderización de gráficos por computadora en tiempo real mediante flujos de trabajo de aprendizaje automático.

Neural Lumigraph Rendering (derecha) ofrece una mejor resolución de los artefactos de mezcla y un tratamiento mejorado de la oclusión en comparación con los métodos anteriores. Fuente.
Aunque en los créditos del artículo solo se menciona a Stanford University y a Raxium, una empresa de tecnología de pantallas holográficas que actualmente opera en modo sigiloso, entre los colaboradores figuran un arquitecto principal de aprendizaje automático de Google y un científico informático de Adobe (ADBE ), así como el director de tecnología de StoryFile (que recientemente fue noticia por una versión de William Shatner creada con IA).
En relación con la reciente campaña publicitaria de Shatner, StoryFile parece estar utilizando NLR en su nuevo proceso para crear entidades interactivas generadas por IA, basadas en las características y los relatos de personas concretas.
StoryFile contempla el uso de esta tecnología en exposiciones de museos, relatos interactivos en línea, pantallas holográficas, realidad aumentada (RA) y documentación del patrimonio; además, parece estar considerando posibles nuevas aplicaciones de NLR en entrevistas de selección de personal y aplicaciones de citas virtuales:

Usos propuestos en un video en línea de StoryFile.
Captura volumétrica para interfaces y video de síntesis de nuevas vistas
El principio de la captura volumétrica, tal como se plantea en el creciente número de artículos sobre el tema, consiste en tomar imágenes fijas o videos de un sujeto y utilizar el aprendizaje automático para «completar» los puntos de vista que no cubría el conjunto original de cámaras.
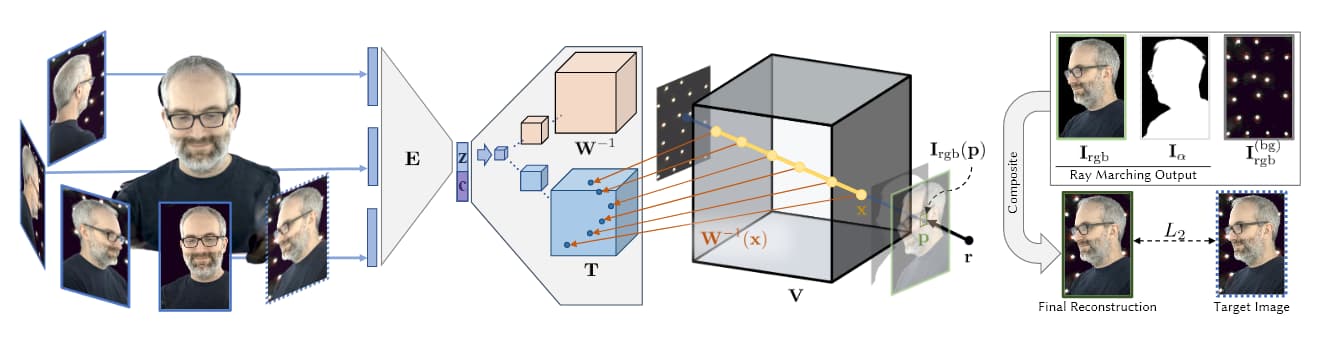
Fuente: https://research.fb.com/wp-content/uploads/2019/06/Neural-Volumes-Learning-Dynamic-Renderable-Volumes-from-Images.pdf
En la imagen de arriba, tomada de la investigación sobre IA de Facebook de 2019 (véase más abajo), se muestran las cuatro etapas de la captura volumétrica: varias cámaras obtienen imágenes o grabaciones; una arquitectura de codificador y decodificador (u otras arquitecturas) calcula y concatena la relación entre las vistas; los algoritmos de trazado de rayos calculan los vóxeles (u otras unidades geométricas espaciales XYZ) de cada punto del espacio volumétrico; y, en la mayoría de los artículos más recientes, se lleva a cabo un entrenamiento para sintetizar una entidad completa que pueda manipularse en tiempo real.
Hasta la fecha, esta fase de entrenamiento, que suele ser extensa y requiere grandes cantidades de datos, ha impedido que la síntesis de nuevas vistas se aplique a la captura en tiempo real o con gran capacidad de respuesta.
El hecho de que la síntesis de nuevas vistas genere un mapa 3D completo de un espacio volumétrico significa que resulta relativamente sencillo unir esos puntos para crear una malla tradicional generada por computadora y, de ese modo, capturar y articular sobre la marcha a una persona generada por computadora (o cualquier otro objeto de límites relativamente definidos).
Los enfoques que utilizan NeRF se basan en nubes de puntos y mapas de profundidad para generar interpolaciones entre los escasos puntos de vista de los dispositivos de captura:
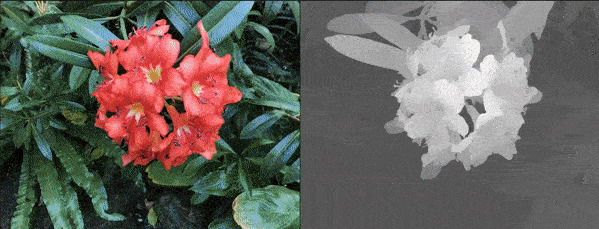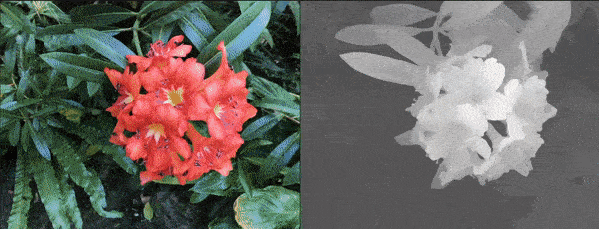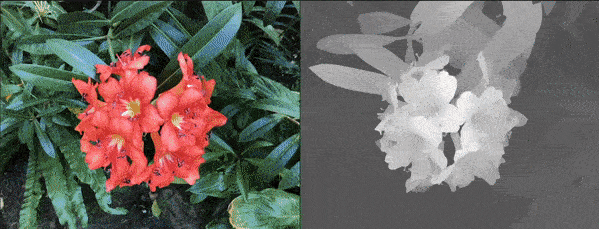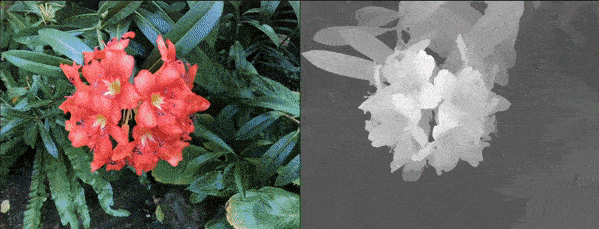
NeRF puede generar profundidad volumétrica mediante el cálculo de mapas de profundidad, en lugar de generar mallas de gráficos por computadora. Fuente: https://www.youtube.com/watch?v=JuH79E8rdKc
Aunque NeRF puede calcular mallas, la mayoría de las implementaciones no lo hacen para generar escenas volumétricas.
En cambio, el enfoque Implicit Differentiable Renderer (IDR), publicado por el Weizmann Institute of Science en octubre de 2020, se basa en aprovechar la información de mallas 3D generada automáticamente a partir de conjuntos de cámaras de captura:
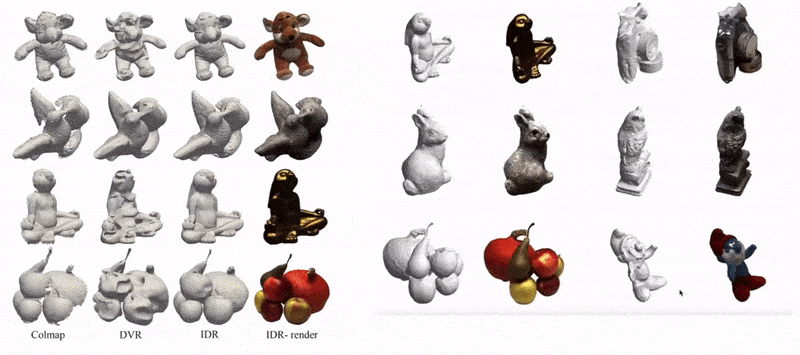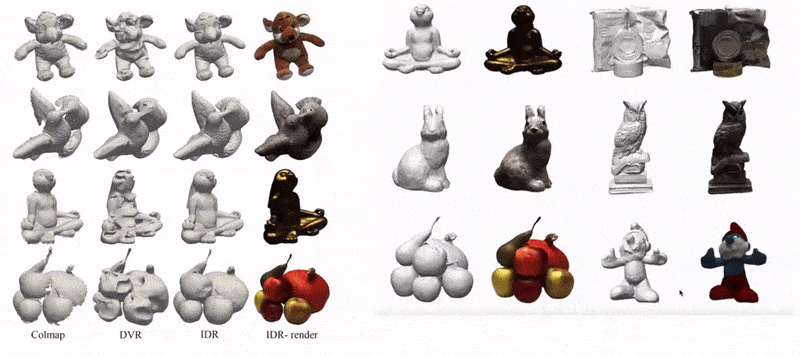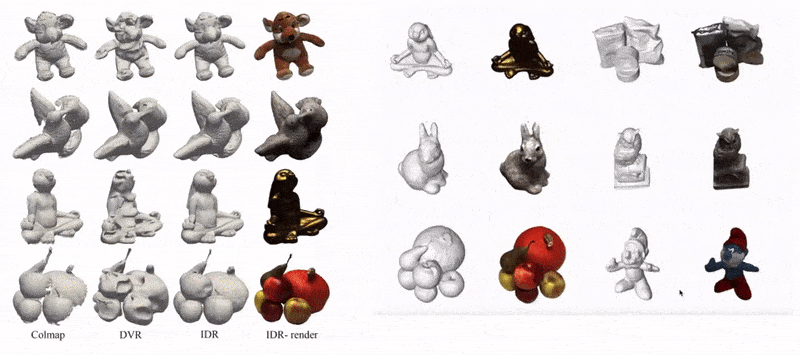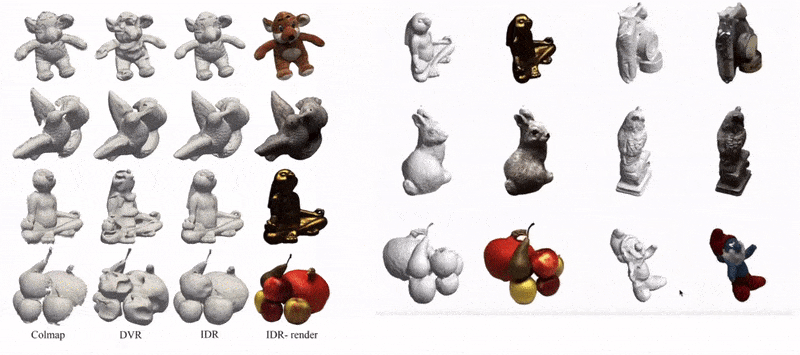
Ejemplos de capturas con IDR convertidas en mallas interactivas de gráficos por computadora. Fuente: https://www.youtube.com/watch?v=C55y7RhJ1fE
Aunque NeRF carece de la capacidad de IDR para estimar formas, IDR no puede igualar la calidad de imagen de NeRF, y ambos requieren muchos recursos para entrenar y recopilar datos (aunque las innovaciones recientes en NeRF están empezando a abordar este problema).

Equipo de cámaras personalizado de NLR con 16 cámaras GoPro HERO7 y 6 cámaras Back-Bone H7PRO centrales. Para renderizar en «tiempo real», estas funcionan a un mínimo de 60 fps. Fuente: https://arxiv.org/pdf/2103.11571.pdf
En cambio, Neural Lumigraph Rendering utiliza SIREN (redes de representación sinusoidal) para incorporar las fortalezas de cada enfoque a su propio marco de trabajo, cuyo propósito es generar resultados que puedan utilizarse directamente en las canalizaciones de gráficos en tiempo real existentes.
SIREN se ha utilizado para implementaciones similares durante el último año y ahora es una llamada a la API popular en los Colabs de aficionados de las comunidades de síntesis de imágenes; sin embargo, la innovación de NLR consiste en aplicar SIREN a la supervisión de imágenes multivista bidimensionales, algo problemático debido a la tendencia de SIREN a producir resultados sobreajustados en lugar de generalizables.
Una vez extraída la malla de CG de las imágenes del conjunto, se rasteriza mediante OpenGL y las posiciones de sus vértices se asignan a los píxeles correspondientes; después, se calcula la combinación de los distintos mapas que contribuyen al resultado.
La malla resultante es más generalizable y representativa que la de NeRF (véase la imagen a continuación), requiere menos cálculos y no aplica detalles excesivos a zonas (como la piel lisa del rostro) que no pueden beneficiarse de ellos:

Fuente: https://arxiv.org/pdf/2103.11571.pdf
En el aspecto negativo, NLR aún no cuenta con capacidad para la iluminación dinámica ni la reiluminación, y los resultados se limitan a mapas de sombras y otros aspectos de iluminación obtenidos en el momento de la captura. Los investigadores tienen previsto abordar esta cuestión en trabajos futuros.
Además, el artículo admite que las formas generadas por NLR no son tan precisas como las de algunos enfoques alternativos, como Selección de vistas píxel a píxel para estéreo multivista no estructurado, o las del estudio del Instituto Weizmann mencionado anteriormente.
El auge de la síntesis volumétrica de imágenes
La idea de crear entidades 3D a partir de una serie limitada de fotografías mediante redes neuronales es anterior a NeRF; hay artículos visionarios que se remontan a 2007 o incluso antes. En 2019, el departamento de investigación de IA de Facebook publicó un artículo fundamental, Volúmenes neuronales: aprendizaje de volúmenes dinámicos renderizables a partir de imágenes, que permitió por primera vez crear interfaces interactivas para humanos sintéticos generados mediante captura volumétrica basada en aprendizaje automático.
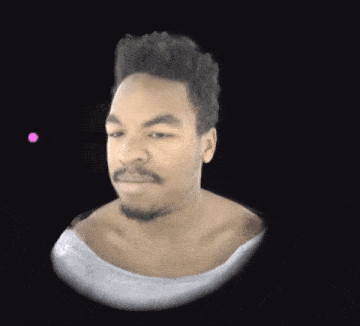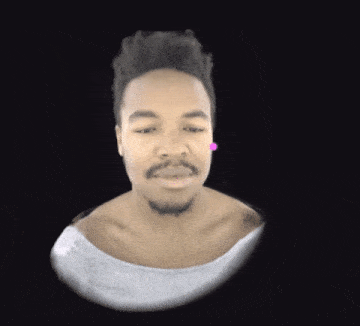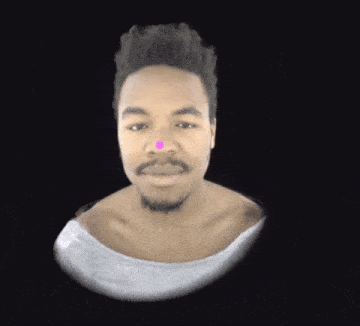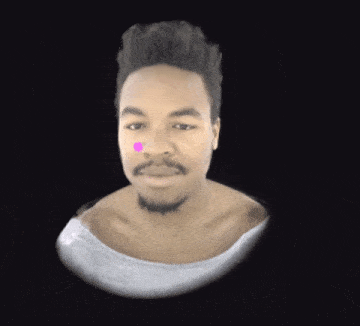
La investigación de Facebook de 2019 permitió crear una interfaz de usuario interactiva para una persona volumétrica. Fuente: https://research.fb.com/publications/neural-volumes-learning-dynamic-renderable-volumes-from-images/


