
Entrevistas
Nikunj Bajaj, cofundador y CEO de TrueFoundry – Serie de entrevistas

 Añade Unite.AI a tus fuentes preferidas en Google
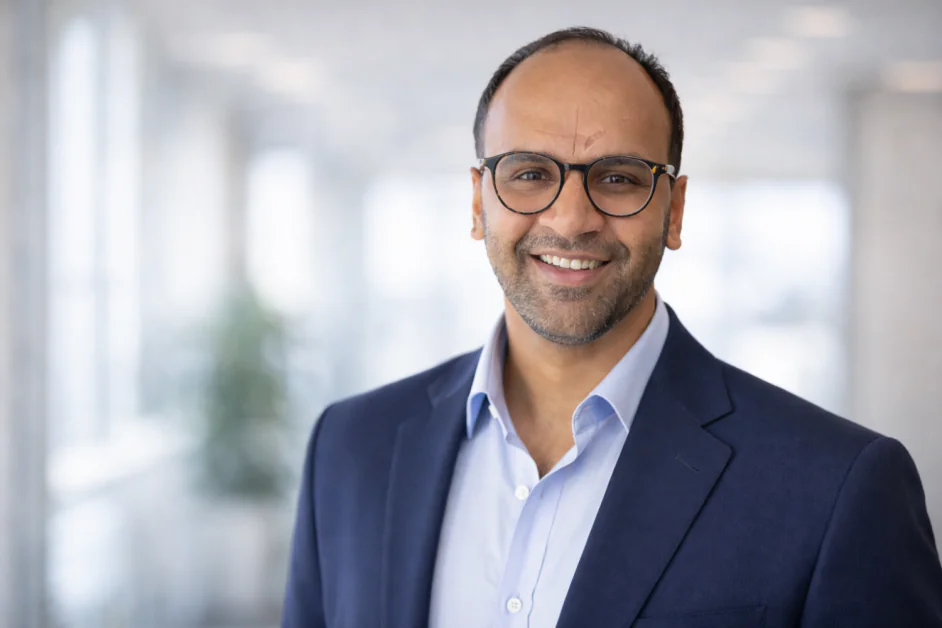
Antes de fundar TrueFoundry, trabajó en investigación de aprendizaje automático, IA en producción en Facebook (META ) y sistemas de recomendación a gran escala. ¿Qué experiencias lo impulsaron más directamente a crear una empresa de infraestructura de IA empresarial y qué problema consideraba que seguía sin resolverse en aquel momento?
En Meta veíamos el aprendizaje automático como un caso particular del software y la IA generativa como un caso particular del aprendizaje automático. El resultado era una pila tecnológica vertical con el software en la base, el aprendizaje automático en el centro y la IA generativa en la parte superior. En esta estructura, los modelos que construyo como desarrollador de aprendizaje automático siguen el mismo patrón de despliegue que el resto del software, lo que hace muy sencillo escalar los sistemas.
Sin embargo, la mayoría de las empresas desplegaban pilas paralelas, es decir, pilas separadas para software, aprendizaje automático e IA generativa. Cuando existen estas pilas paralelas, el escalado se complica debido a los traspasos de trabajo necesarios entre el ámbito del aprendizaje automático y el mundo del software.
Nuestro equipo siempre ha trabajado en la intersección entre la creación de modelos de aprendizaje automático y su infraestructura. Esa perspectiva singular nos permitió ver que podíamos llevar pilas verticales similares a las empresas y adaptarlas a sus requisitos específicos. A finales de 2021 también teníamos la hipótesis de que el aprendizaje automático se acercaba a un punto de inflexión. Cuando llegara ese momento, más empresas necesitarían una pila integrada verticalmente para desplegar y escalar estos sistemas de forma eficaz. Esto fue lo que finalmente nos llevó a fundar TrueFoundry, y nuestra hipótesis resultó acertada. La adopción de IA se aceleró tras el lanzamiento de ChatGPT a finales de 2022.
A medida que los sistemas de IA pasan de la experimentación a las operaciones diarias, ¿qué ha cambiado en la forma en que las organizaciones deberían pensar sobre la fiabilidad y los fallos?
Con la IA generativa hay mucho más en juego que con los sistemas tradicionales de aprendizaje automático. Cuando estos sistemas pasan a producción, las organizaciones afrontan niveles mucho más altos de ambigüedad y no determinismo, porque los LLM son estocásticos por naturaleza. Los sistemas de agentes construidos sobre ellos añaden aún más ambigüedad.
Además, los fallos ya no son binarios. No se trata solo de que un sistema falle o no falle: muchos problemas se presentan como fallos parciales o degradaciones silenciosas. Con el tiempo, los sistemas pueden responder con mayor latencia, menor calidad o comportamientos incorrectos. En muchos casos, estas degradaciones son más difíciles de detectar y, a veces, incluso más perjudiciales que una interrupción completa.
Las organizaciones deben pensar en la fiabilidad no solo en términos de tiempo de actividad, sino también de degradación del rendimiento a lo largo del tiempo.
TrueFailover se lanzó en medio de una oleada de interrupciones de servicios de nube e IA que tuvieron gran repercusión. ¿Qué acontecimientos recientes dejaron claro que la fiabilidad de la IA había pasado de ser un complemento deseable a un requisito arquitectónico fundamental?
Uno de nuestros clientes del sector sanitario procesa en tiempo real solicitudes de pacientes relacionadas con recetas médicas, en las que es fundamental responder a tiempo. Este cliente sufrió una interrupción causada por el fallo de un modelo. Sus flujos de trabajo generan miles de dólares de ingresos por segundo, y la interrupción afectó a algunos de estos flujos críticos. Era uno de los primeros clientes de TrueFailover, por lo que pudimos ayudarlo a restablecer rápidamente el funcionamiento y contener el impacto.
Incidentes como este plantean una pregunta importante: si cada vez hay más en juego con los sistemas de IA generativa, ¿por qué los procesos de recuperación siguen siendo en gran medida manuales? Esto reforzó la idea de que los sistemas deben construirse con la premisa de que los fallos ocurrirán y diseñarse para corregirse automáticamente. La fiabilidad también debe integrarse en la propia pila de IA mediante puertas de enlace de IA, que pueden proporcionar enrutamiento centralizado, observabilidad, mecanismos de protección y cambios inteligentes entre modelos de distintos proveedores.
Muchas interrupciones de IA todavía se presentan como pequeños contratiempos técnicos. ¿Dónde ve que empiezan a aparecer los verdaderos costes económicos y humanos cuando los sistemas de IA dejan de funcionar?
La IA empresarial ha evolucionado hasta un punto en el que estos contratiempos ya no afectan solo a los flujos de trabajo internos. Hoy, las interrupciones y las degradaciones influyen directa e inmediatamente en la percepción pública y los beneficios, porque las aplicaciones en producción ahora atienden a los clientes. Este paso de las pruebas internas a aplicaciones de cara al público en las que hay mucho en juego explica la creciente necesidad de atención y supervisión por parte de la alta dirección.
A medida que los sistemas de IA se integran más profundamente en los flujos de trabajo operativos, las interrupciones dejan de ser únicamente problemas técnicos. Cada vez tienen consecuencias más directas para el negocio, los clientes y la reputación.
En entornos de misión crítica, como farmacias, servicios sanitarios o atención al cliente, ¿con qué rapidez puede el tiempo de inactividad de la IA convertirse en un riesgo operativo o reputacional?
En los entornos de misión crítica, la escalada se produce casi de inmediato, porque estos sistemas respaldan flujos de trabajo en tiempo real que requieren una respuesta oportuna. Incluso una interrupción breve puede detener procesos críticos, retrasar la prestación de servicios o interrumpir sistemas posteriores que dependen de esos resultados, creando efectos operativos en cascada en toda la organización.
En sectores como la sanidad, el impacto va más allá de la interrupción operativa y alcanza la experiencia del cliente y los resultados de los servicios. Si un paciente no puede obtener a tiempo los medicamentos recetados, puede haber consecuencias reales. Esto no solo supone un problema para el paciente, sino que también puede perjudicar la reputación de la farmacia o del proveedor sanitario. En entornos de misión crítica donde la confianza es importante, resulta primordial que los sistemas sigan funcionando. Por eso las organizaciones reconocen cada vez más que los sistemas de IA deben diseñarse con la premisa de que habrá fallos y que los mecanismos de recuperación deben activarse automáticamente para minimizar el riesgo.
Ha dicho que muchos equipos diseñan la arquitectura pensando en las capacidades y no en la continuidad. ¿Por qué cree que la resiliencia ha tenido históricamente una prioridad menor en el diseño de sistemas de IA?
Esto se debe en gran medida a los incentivos dentro de las organizaciones. Las nuevas capacidades son visibles y despiertan entusiasmo. Permiten demostraciones, funciones y nuevas posibilidades del producto que la dirección puede ver de inmediato.
La continuidad, por definición, es invisible cuando todo funciona bien. Por eso los sistemas de recompensa tienden a favorecer el lanzamiento de nuevas funciones frente a la garantía de que nada falle. Como resultado, las organizaciones suelen invertir de manera desproporcionada en el desarrollo de capacidades en comparación con la ingeniería de resiliencia.
Con la creciente dependencia de modelos y API externos, ¿qué nuevas fragilidades aparecen en la pila de IA cuya importancia los directivos quizá todavía no comprendan plenamente?
Los LLM son, fundamentalmente, recursos compartidos, y las empresas no los poseen como poseen la infraestructura tradicional. Además, los sistemas importantes y críticos para el negocio de las empresas se ejecutan sobre sistemas externos que aún no han sido plenamente probados a lo largo del tiempo. Los propios LLM evolucionan rápidamente, lo que significa que no se puede responsabilizar al proveedor de un modelo de cuestiones como la latencia o una ligera caída del rendimiento del modelo, porque realiza nuevas iteraciones de su investigación muy deprisa.
Como los LLM son recursos compartidos, la latencia puede dispararse cuando otro usuario realiza una acción concreta. La propia naturaleza de los LLM introduce muchos de estos puntos de fallo, y las empresas simplemente no tienen un control total en este nuevo mundo. Sin control total, lo mejor que puede hacer una empresa es crear suficiente redundancia en el sistema para diseñar una solución resiliente.
Sin centrarnos en productos concretos, ¿cómo deberían las organizaciones replantearse la arquitectura de IA para dar por hecho que habrá fallos, en lugar de tratar las interrupciones como casos extremos poco frecuentes?
Las organizaciones deberían volver a los principios fundamentales del diseño de sistemas distribuidos. Los sistemas de software se construyeron con la premisa de que los componentes de red y las máquinas fallarían y de que una región entera podría dejar de funcionar.
Los sistemas de IA no deberían ser diferentes. Debemos suponer que los proveedores de modelos sufrirán problemas de latencia, degradaciones o interrupciones e incorporar redundancia para que las aplicaciones mantengan su resiliencia ante distintos escenarios de fallo.
¿Espera que la resiliencia de la IA se convierta en un factor decisivo al elegir plataformas y proveedores, del mismo modo que el tiempo de actividad y la redundancia influyeron en las decisiones sobre infraestructura de nube?
A medida que más sistemas de IA pasan a producción, la resiliencia se convertirá en un requisito mínimo. Si un proveedor no puede mostrar gráficos y métricas del tiempo de actividad y la resiliencia general, ni siquiera se lo tendrá en cuenta. Cuando la resiliencia se convierta en una expectativa básica respecto de todos los proveedores, los factores decisivos pasarán a ser la experiencia del usuario, la optimización del rendimiento, la observabilidad y las capacidades del producto de nivel superior. Con el tiempo, componentes como una puerta de enlace de IA y las funciones de conmutación automática ante fallos se convertirán en elementos fundamentales de la infraestructura de IA empresarial.
De cara al futuro, ¿qué significa realmente una IA «lista para producción» en un mundo donde se espera que esté disponible continuamente y no que solo resulte útil de vez en cuando?
Los sistemas de IA listos para producción deben ser observables, controlables y recuperables. Es necesario cumplir los tres requisitos.
Para que la IA en producción sea observable, los equipos necesitan una visibilidad profunda del comportamiento de los modelos, la latencia, las tasas de error, el uso de tokens, la deriva y los patrones de fallo. Sin una observabilidad sólida, resulta muy difícil detectar degradaciones antes de que los usuarios comiencen a notarlas.
La capacidad de controlar los sistemas incluye la regulación del tráfico, la limitación de la tasa de solicitudes, los mecanismos de protección, la aplicación de políticas y el enrutamiento inteligente entre modelos y proveedores. Aquí una puerta de enlace de IA se vuelve fundamental: actúa como un plano de control centralizado que aplica las protecciones, proporciona una gobernanza coherente y permite cambiar dinámicamente de modelo cuando disminuyen el rendimiento o la fiabilidad.
Por último, para poder recuperarse, los sistemas deben construirse con la premisa de que los componentes pueden quedar parcial o completamente inoperativos, ya sea por interrupciones del proveedor, degradación de la calidad del modelo, límites de la tasa de solicitudes o entradas inesperadas de actores maliciosos. La conmutación automática ante fallos y los mecanismos de autorrecuperación deben estar integrados en la arquitectura, en lugar de depender de procedimientos manuales que se activan después de que algo salga mal.
Esa es la dirección en la que trabajamos en TrueFoundry. Los proveedores que definan así la preparación para producción, combinando observabilidad, control centralizado y recuperación automatizada, se ganarán la confianza de los clientes a largo plazo y podrán seguir resolviendo nuevos problemas a medida que surjan.
Gracias por la excelente entrevista. Los lectores que deseen saber más pueden visitar TrueFoundry.


