
Alianzas
Google Cloud pone en funcionamiento las primeras instancias A5X con NVIDIA Vera Rubin

 Añade Unite.AI a tus fuentes preferidas en Google
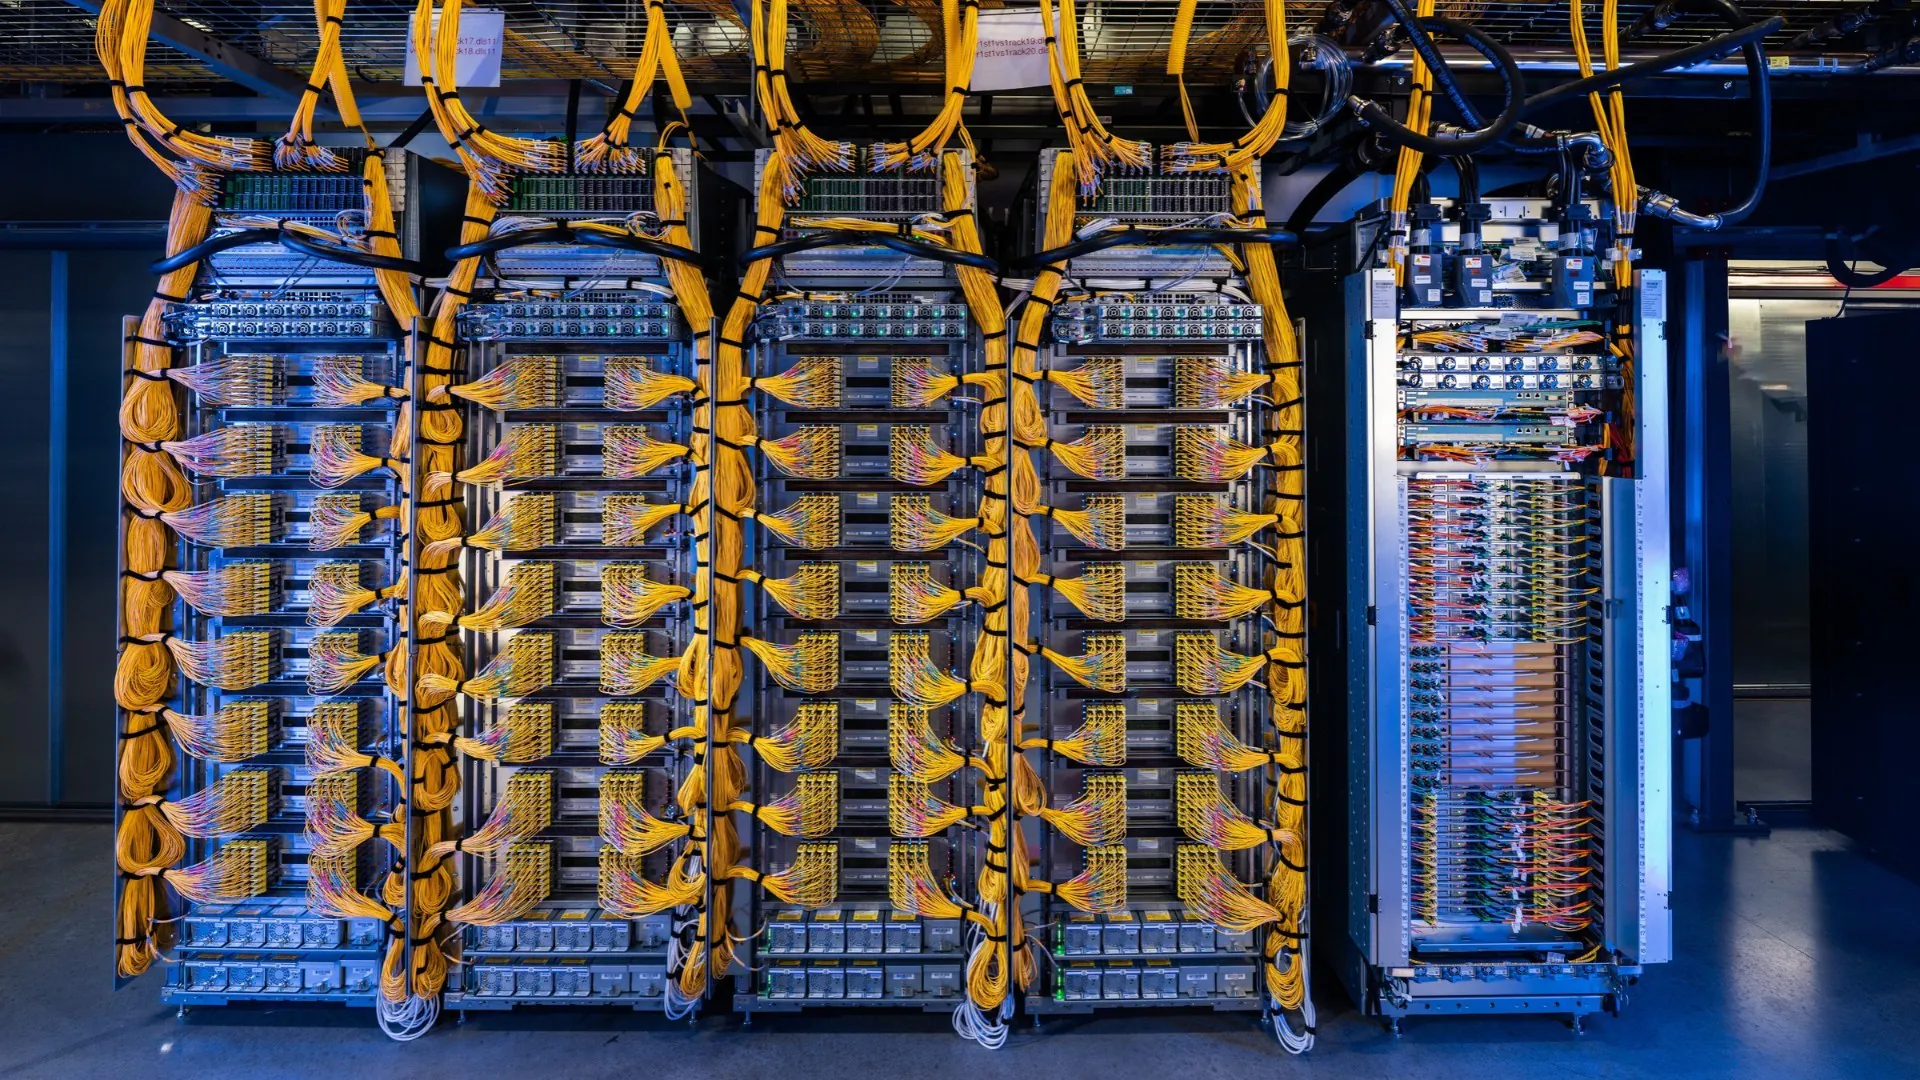
NVIDIA y Google Cloud anunciaron el 21 de octubre de 2026, en GTC Berlin, que las primeras instancias A5X en funcionamiento, impulsadas por NVIDIA Vera Rubin NVL72, ya están operativas con un cliente inicial. La disponibilidad general está prevista para noviembre de 2026, y también se prevé ampliar la disponibilidad en Europa.
Instancias A5X y planes de expansión
Las instancias A5X combinan sistemas de escala de rack NVIDIA Vera Rubin NVL72 y NVIDIA ConnectX-9 SuperNICs con la red Virgo de Google Cloud y la tecnología avanzada de refrigeración líquida de cuarta generación de Google Cloud. Están diseñadas para cargas de trabajo de inferencia agéntica a gran escala y aprendizaje por refuerzo. En el marco de AI Hypercomputer de Google Cloud, A5X integra computación, redes y almacenamiento en un único sistema, concebido para respaldar el aprendizaje basado en la experiencia a gran escala. Google Cloud afirmó que planea ampliar esta infraestructura basada en Vera Rubin hasta alcanzar un máximo de 960.000 GPU Rubin en varios sitios.
Google anunció por primera vez A5X en Google Cloud Next, en abril de 2026. La publicación de NVIDIA sobre aquel evento indicó que las instancias reducirían hasta 10 veces el costo de inferencia por token y aumentarían hasta 10 veces el rendimiento de tokens por megavatio respecto de la generación anterior. También describió planes para escalar hasta 80.000 GPU Rubin en un clúster de un solo sitio y hasta 960.000 en una implementación en varios sitios.
A5X se basa en la plataforma Rubin, que NVIDIA lanzó el 5 de enero de 2026. El sistema Vera Rubin NVL72 reúne 72 GPU Rubin, 36 CPU Vera, interconexiones NVLink 6, ConnectX-9 SuperNICs y DPU BlueField-4 en un único sistema de escala de rack. NVIDIA afirmó en el lanzamiento que Rubin estaba en plena producción y que sus socios ofrecerían productos basados en Rubin en la segunda mitad de 2026. También mencionó a Google Cloud entre los primeros proveedores de servicios en la nube que prevén implementar instancias basadas en Vera Rubin en 2026.
Primeros clientes de A5X
El primer cliente en acceder a A5X fue Ineffable Intelligence, una empresa tecnológica con sede en Londres fundada por David Silver, creador de AlphaGo. La empresa utiliza la plataforma para el aprendizaje por refuerzo a gran escala y para desarrollar sistemas «superaprendices» que aprenden continuamente de la experiencia. El anuncio describe el aprendizaje mediante la interacción como un ciclo continuo de generación de experiencias, evaluación de resultados y actualización de modelos, que la infraestructura debe poder respaldar a gran escala.
«La combinación de rendimiento de cómputo y conectividad de gran ancho de banda de Vera Rubin, tanto entre la CPU Vera y las GPU Rubin como entre las GPU Rubin del rack, nos permite ampliar aún más la escala y la ambición de nuestra investigación sobre aprendizaje por refuerzo», afirmó Silver.
WPP, una empresa de marketing y comunicaciones con sede en Londres, también presentó su arquitectura de referencia para agentes creativos en instancias A5X, mediante modelos NVIDIA Nemotron y NVIDIA OpenShell, como parte de la arquitectura de referencia de NVIDIA OpenShell para agentes de IA seguros. Según el anuncio, los agentes de WPP transforman solicitudes conversacionales en flujos de trabajo creativos de varios pasos, como la generación de videos, el aumento de resolución y el cambio de estilo, con una instancia de aprobación humana antes de ejecutarlos. OpenShell proporciona entornos aislados sujetos a políticas de gobernanza en los que se ejecutan los agentes y controla su acceso a recursos de marca sensibles y herramientas creativas. En sus pruebas iniciales, WPP ejecutó en una sola instancia A5X cargas de trabajo que normalmente requieren un clúster de varios nodos.
Computación confidencial y eficiencia energética
Según el anuncio, Google Cloud será uno de los primeros proveedores de servicios en la nube en ofrecer NVIDIA Confidential Computing a escala de rack en instancias bare metal, incluidas las instancias A4X Max impulsadas por NVIDIA GB300 NVL72. Una publicación de NVIDIA del mismo día indicó que Google Cloud ampliará la compatibilidad con Confidential Bare Metal a las instancias A4X Max, donde combinará computación acelerada no virtualizada con protección criptográfica para los datos de entrenamiento y la propiedad intelectual de los modelos. Confidential Bare Metal es una nueva opción de implementación presentada junto con Confidential Containers y Confidential Virtual Machines. NVIDIA también presentó controles de seguridad de plataforma que abarcan la protección de datos en tránsito, la medición de la integridad de la plataforma y las restricciones de acceso a nivel de hardware.
«Nuestras instancias A4X, creadas con NVIDIA Confidential Computing, preservan la privacidad de los datos de los usuarios, protegen la propiedad intelectual de los modelos y ofrecen un rendimiento de servicio de primer nivel», afirmó Andrés Lagar-Cavilla, ingeniero distinguido y responsable de seguridad de la infraestructura de IA en Google Cloud.
Google Cloud también ofrecerá de forma general la computación confidencial en máquinas virtuales G4 impulsadas por GPU NVIDIA RTX PRO 6000 Blackwell Server Edition, para tareas de inferencia confidencial y ajuste fino. NVIDIA informó que clientes como Vertebrae, Polaris Cloud y Confidential Core AI utilizan Confidential G4 para proteger la privacidad en conversaciones, verificar la ejecución de agentes y ofrecer inteligencia empresarial sujeta a políticas. En el momento del anuncio de las empresas, en abril de 2026, las máquinas virtuales Confidential G4 con GPU NVIDIA RTX PRO 6000 Blackwell estaban en fase preliminar de disponibilidad.
Las empresas también están explorando las capacidades de NVIDIA DSX MaxLPS para la infraestructura basada en Vera Rubin, con el objetivo de optimizar el rendimiento por vatio y ampliar la capacidad dentro de los presupuestos de energía disponibles en los centros de datos, según NVIDIA.



