
Entrevistas
Dr. Jaime Bland, Co-Fundadora y CEO de Aquila Health – Serie de Entrevistas

 Añade Unite.AI a tus fuentes preferidas en Google
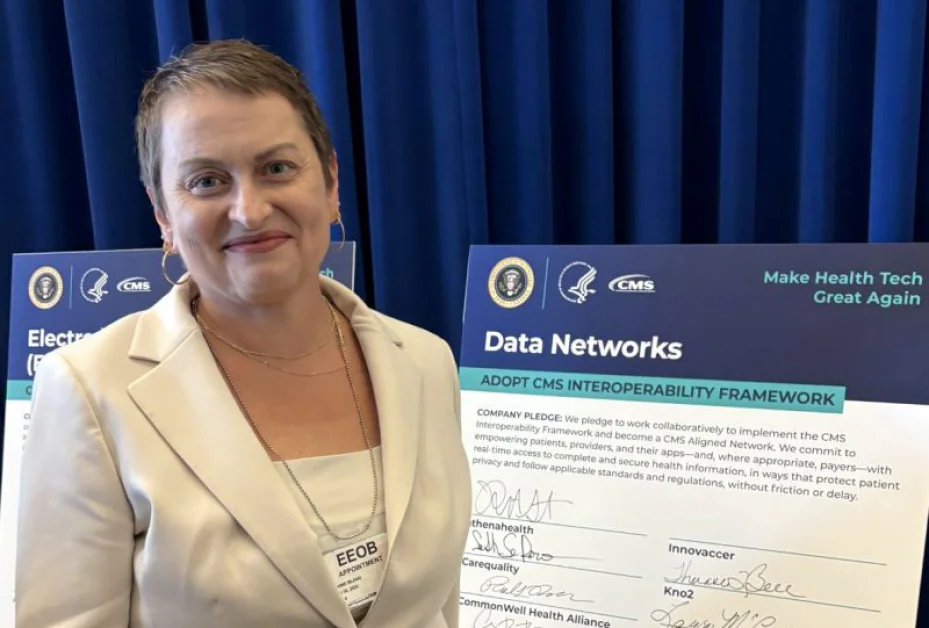
Dr. Jaime Bland, Co-Fundadora y CEO de Aquila Health, es una líder en tecnología sanitaria centrada en abordar uno de los desafíos más persistentes de la industria: los datos fragmentados y de difícil acceso. Co-fundó Aquila Health para crear una infraestructura de datos unificada que permita a las organizaciones sanitarias ir más allá de los sistemas aislados, aprovechando el aprendizaje automático y el análisis estructurado para generar conocimientos útiles mientras mantiene la supervisión clínica. Su trabajo se centra en mejorar la interoperabilidad, permitir la inteligencia de salud a nivel de población y apoyar la detección temprana de amenazas de salud emergentes a través de sistemas de datos clínicos, de reclamaciones y genómicos integrados.
Aquila Health es una plataforma de datos de salud impulsada por IA diseñada para unificar fuentes de datos dispares en un sistema interoperable que apoya tanto la eficiencia operativa como el análisis avanzado. La plataforma ingiere formatos de datos de salud de alto volumen como HL7 y FHIR, lo que permite una integración sin problemas en hospitales, sistemas de salud pública y otras partes interesadas. Al combinar enfoques de aprendizaje automático estructurado con un modelo de validación de humano en el bucle, Aquila se centra en proporcionar conocimientos confiables para la gestión de la salud de la población, la detección de anomalías y la toma de decisiones en tiempo real, en lugar de confiar únicamente en sistemas de IA opacos. Esto sitúa a la empresa en la intersección de la infraestructura de datos y la IA aplicada, donde la mejora de la calidad y la accesibilidad de los datos es fundamental para desbloquear todo el potencial de la inteligencia sanitaria.
Lideró CyncHealth a través de un crecimiento masivo, escalando la interoperabilidad en millones de registros de pacientes y múltiples estados, antes de fundar Aquila Health. ¿Cuáles fueron las limitaciones clave o fallos sistémicos que encontró durante ese viaje que finalmente la llevaron a construir Aquila desde cero?
En CyncHealth, pasamos años construyendo la infraestructura para conectar a las organizaciones de salud en Nebraska y Iowa. Conectamos más de 1.100 sitios de atención y millones de registros de pacientes, abarcando una población de más de cinco millones de vidas.
Sin embargo, lo que seguíamos encontrando era que conectar sistemas y hacer que los datos sean útiles son dos problemas muy diferentes. Por ejemplo, trabajamos para crear un panel de seguimiento de sobredosis de opioides que coordinara los datos que recibimos de múltiples fuentes. Tomó meses con cientos de horas de trabajo y coordinación entre muchas partes interesadas para hacer que este solo punto de datos fuera comprensible en un contexto de salud pública y atención sanitaria. Y después de todo eso, la imagen seguía siendo incompleta.
Esa experiencia fue la semilla para Aquila. La forma tradicional de conectar interfaces sin comprender la integridad y la calidad de los datos exportados no cumplirá con las necesidades de los avances en IA que hemos visto en los últimos años. Cuando la IA puede lograr en horas lo que antes tomaba meses a un equipo, y lo hace con mayor calidad a una fracción del costo, debes utilizar ese conocimiento para reconstruir desde una nueva base. Eso es lo que hicimos con Aquila; nos centramos en herramientas modernas que disminuyen el costo de la conexión para que podamos centrarnos en completar la imagen completa de la salud, no solo los datos derivados de fuentes tradicionales de EHI, sino la imagen completa.
Aquila acaba de salir de la clandestinidad con una plataforma centrada en unificar los datos de salud fragmentados en una capa única lista para la IA. ¿Cuáles fueron los avances técnicos clave que hicieron que esto fuera posible ahora, en lugar de hace unos pocos años?
Las capacidades de la IA han impulsado este cambio casi por completo.
Pasé años viendo a ingenieros habilidosos reconciliar manualmente los estándares de datos, uno a la vez. Funcionó, pero ese modelo nunca puede escalarse. No podrías contratar suficientes personas para salir de él lo suficientemente rápido como para mantener el ritmo del volumen y la variedad de datos que genera la atención sanitaria.
Lo que es diferente ahora es que la IA puede hacer el trabajo de normalización de forma continua en la capa de datos a medida que la información se mueve a través del sistema. No es un proceso por lotes que se ejecuta durante la noche. Ocurre casi en tiempo real. Eso cambia lo que es posible para los equipos clínicos y de salud pública, porque los datos que necesitan están estructurados y validados (hechos útiles) antes de que lleguen a ellos.
Los clínicos están acostumbrados a tomar decisiones sin la imagen completa del paciente. La salud pública está acostumbrada a impulsar programas sin datos recientes para respaldarlos. Aquila está cambiando el panorama y proporcionando la velocidad que hace que la toma de decisiones basada en datos sea posible en toda la atención sanitaria.
Construimos TREUE ™ como el marco que organiza los datos clínicos derivados de los registros electrónicos de salud, los laboratorios, la salud pública, las reclamaciones, la farmacia y los datos sociales en una estructura unificada. La IA no reemplaza la buena gobernanza de los datos; la hace escalable por primera vez.
Has enfatizado que el verdadero desafío en la IA sanitaria no son los modelos, sino los datos en sí. ¿Cuáles son las brechas más críticas en la infraestructura de datos de salud de hoy que impiden que la IA entregue resultados significativos?
La industria está hablando del modelo de IA, pero el modelo no es la parte difícil.
La parte difícil es que un paciente puede entrar en tres instalaciones diferentes en un solo día y aparecer como tres personas diferentes en tres sistemas diferentes. Los laboratorios no coinciden con las notas clínicas. El registro del pagador tiene un identificador diferente al del hospital y la salud pública utiliza un identificador completamente diferente. Para cuando se resuelve todo eso manualmente, la ventana clínica ya se ha cerrado.
Las conexiones técnicas sólidas no pueden solucionar registros que llegan incompletos o fuera de secuencia. La IA no puede detectar un patrón que no esté en los datos, y no puede hacer una recomendación confiable a partir de un registro que falta la mitad de la información histórica o actual que debería contener.
La brecha no es la potencia de procesamiento, es la confianza en los datos subyacentes. Eso es lo que tiene que solucionarse primero, y solucionarlo a escala es donde la IA puede ganar su lugar.
Aquila se posiciona como la “capa de preparación de datos” antes de la ingesta de IA. ¿Puede explicar qué hace esa capa en la práctica, especialmente cuando se trata de entradas muy heterogéneas como registros clínicos, datos de reclamaciones y flujos de datos en tiempo real?
Usando el ejemplo de antes, considere lo que llega cuando una visita del paciente genera datos. Recibes un mensaje HL7 del hospital, un registro de reclamaciones del asegurador, un resultado de laboratorio de un laboratorio de referencia que utiliza un identificador diferente y un informe de salud pública presentado en una cronología completamente diferente. Ninguno de ellos estaba diseñado para ser reconciliado entre sí.
Nuestra capa de preparación, TREUE ™, es lo que se encuentra entre esas entradas y cualquier aplicación de análisis o IA posterior. Su trabajo es evaluar cada registro a medida que llega, coincidir identidades a través de fuentes, normalizar formatos y marcar lo que falta o es inconsistente antes de que los datos se muevan más.
En la práctica, esto significa que un clínico que mira a un paciente está trabajando a partir de un registro que ha sido validado y alineado a través de fuentes, en lugar de reconciliar manualmente cuatro vistas del sistema diferentes durante un encuentro de atención. Para los equipos de salud pública, significa que las señales de brotes no se retrasan por datos que llegaron en diferentes formatos desde diferentes jurisdicciones.
Es trabajo de infraestructura. No es glamoroso, pero nada funciona sin ello.
Los estándares de interoperabilidad como Fast Healthcare Interoperability Resources (FHIR) y United States Core Data for Interoperability (USCDI) han estado presentes durante años, sin embargo, la fragmentación persiste. ¿Qué es lo que todavía falta desde una perspectiva de estándares, y cómo aborda Aquila esas brechas de manera diferente?
FHIR y USCDI le dieron a la industria un lenguaje compartido para intercambiar datos. Eso fue un progreso importante. Pero un lenguaje compartido para enviar datos no es lo mismo que datos que se comportan de manera consistente una vez que llegan.
Aquí está la brecha: los datos de salud no provienen de un solo dominio. Los sistemas clínicos, los registros de salud pública, los laboratorios y las fuentes de datos sociales tienen sus propios requisitos de gobernanza, cronogramas y definiciones de lo que significa un campo. FHIR no te dice cómo reconciliar un conjunto de datos de determinantes sociales con un registro clínico de una jurisdicción diferente.
Lo que TREUE ™ agrega es un marco unificado para cómo los datos de todos esos dominios pueden organizarse y validarse juntos, respetando al mismo tiempo las reglas de gobernanza que se aplican a cada fuente. El resultado es datos que realmente se pueden analizar entre dominios, no solo datos que han sido transmitidos con éxito.
Aquila opera en entornos de alta consecuencia donde el fracaso no es una opción. ¿Cómo diseña sistemas de IA que equilibren el rendimiento en tiempo real con requisitos estrictos en torno a la gobernanza, la auditoría y la confianza?
Tienes que construir la gobernanza en la arquitectura antes de escribir la primera línea de código de la aplicación. No debe ser una capa que agregues después.
En entornos de atención sanitaria y gubernamentales, las decisiones que se toman basadas en estos datos afectan la atención al paciente, la respuesta a los brotes y cómo se asignan los recursos públicos. Cada acción tomada sobre los datos tiene que ser trazable, y el acceso tiene que estar estrictamente controlado. El sistema tiene que cumplir con los requisitos de cumplimiento de los entornos en los que opera.
Para Aquila, eso significa operar dentro de una infraestructura de nube de nivel gubernamental, controles de acceso de confianza cero y prácticas de seguridad alineadas con los estándares federales y HIPAA. Tenemos contratos activos en curso con gobiernos estatales, agencias federales y organizaciones de atención sanitaria, y esos entornos tienen requisitos de cumplimiento muy diferentes que la plataforma tiene que cumplir simultáneamente.
El componente de humano en el bucle es igual de importante. La IA puede detectar señales, pero los expertos clínicos validan las anomalías antes de que informen las decisiones operativas. La tecnología hace que encontrar esas señales sea más rápido. No reemplaza el juicio de las personas que tienen que actuar sobre ellas.
Su plataforma admite la implementación de IA segura en el dispositivo y la soberanía de los datos. ¿Cuán importante se está volviendo la descentralización en la IA sanitaria, especialmente dado el aumento de las preocupaciones sobre la privacidad de los datos y el cumplimiento normativo?
Está volviéndose esencial, y creo que la industria apenas comienza a darse cuenta de por qué.
Las organizaciones de atención sanitaria operan bajo obligaciones de privacidad estrictas. Los datos de pacientes sensibles no pueden simplemente centralizarse y procesarse en un entorno compartido. Diferentes estados tienen diferentes reglas. Las agencias federales tienen diferentes reglas. Los datos de salud internacionales tienen otro conjunto de restricciones. Cualquier arquitectura que requiera mover datos sensibles a un lugar centralizado va a chocar con esas barreras una y otra vez.
La dirección que realmente funciona es generar conocimientos más cerca de donde ya viven los datos. Las organizaciones pueden contribuir al análisis compartido sin renunciar al control de sus datos subyacentes. Eso es lo que permiten los modelos federados.
Nuestra plataforma está diseñada para operar en ese tipo de entorno regulado y descentralizado: la gobernanza que viaja con los datos en lugar de aplicarse en un solo punto. Es una arquitectura más difícil de construir, pero es la que es compatible con cómo funciona la gobernanza de los datos de salud en la práctica.
Muchas startups de IA se inclinan fuertemente hacia los modelos de caja negra, mientras que Aquila incorpora la validación de humano en el bucle. ¿Dónde ve la línea entre la automatización y la supervisión humana en los sistemas de IA clínicos?
Comencé mi carrera como enfermera de planta. Esa experiencia da forma a cómo pienso sobre dónde pertenece la IA en un entorno clínico y dónde no.
La IA es muy buena para encontrar patrones en grandes conjuntos de datos. No es buena para saber qué significa un patrón para un paciente específico con una historia específica en un contexto comunitario específico. Esa es todavía una llamada de juicio humano.
El papel correcto de la IA en los sistemas clínicos es detectar señales que un ser humano podría perder en volumen, no reemplazar el razonamiento clínico que sigue. En Aquila, las anomalías y los conocimientos señalados por el sistema van a los clínicos y expertos en el dominio para su revisión antes de que informen las decisiones operativas. La tecnología te dice dónde mirar, y el profesional te dice qué significa.
Donde creo que está la línea: automatizar la detección, mantener la interpretación con las personas que son responsables del resultado.
Aquila trabaja en salud pública, sistemas gubernamentales y sectores regulados. ¿Cómo difieren los requisitos para la infraestructura de IA entre estos entornos en comparación con los despliegues de IA empresariales tradicionales?
En un despliegue de IA empresarial típico, generalmente estás trabajando dentro del entorno de datos de una organización, un conjunto de reglas de gobernanza, un marco de cumplimiento.
Los entornos de salud pública y gubernamentales son estructuralmente diferentes. Estás coordinando a través de múltiples jurisdicciones, múltiples agencias, múltiples entornos clínicos, cada uno operando en diferentes cronogramas de informes y bajo diferentes marcos legales. Un hospital en un estado, una agencia de salud pública en otro, un programa federal con sus propios requisitos de datos. Todos necesitan intercambiar datos y generar conocimientos sin que ninguna entidad tenga acceso no controlado a los registros de otra.
La infraestructura tiene que admitir el procesamiento de alto volumen mientras mantiene la auditoría estricta a través de todas esas fronteras. Tiene que integrarse con formatos de mensajería de atención sanitaria heredados, porque esos sistemas no van a desaparecer. Y tiene que operar de forma confiable en entornos donde el tiempo de inactividad no es solo un problema comercial, es un problema de seguridad del paciente.
Esa complejidad es por qué comenzamos Aquila con esos entornos en lugar del mercado empresarial tradicional. Si puedes construir una infraestructura que funcione aquí, funciona en todas partes.
Las capacidades de la IA siguen avanzando más rápido que los marcos de gobernanza. ¿Qué responsabilidades tienen los fundadores y los constructores de plataformas para asegurarse de que estos sistemas se desplieguen de manera ética y segura desde el primer día?
Creo que la responsabilidad es directa, aunque cumplirla no lo es.
Si estás construyendo una IA que afecta las decisiones clínicas o los resultados de salud pública, no puedes tratar la gobernanza como un elemento del mapa de productos que llegarás eventualmente. Tiene que estar diseñada desde el principio.
Lo que significa en la práctica es que cada acción sobre los datos tiene que ser auditada. Los modelos tienen que ser lo suficientemente interpretables como para que un clínico pueda entender por qué se señaló una señal. Los expertos clínicos tienen que ser parte del proceso de revisión, no un pensamiento posterior. Y la organización tiene que ser honesta sobre lo que el sistema puede y no puede hacer de manera confiable.
He pasado mi carrera en entornos donde los fallos de datos tienen consecuencias reales para personas reales. Eso da forma a cómo pienso sobre esto. Las capacidades están avanzando rápidamente, y la responsabilidad por cómo se despliegan no debe ser permitida a retrasarse. Los fundadores que construyen estos sistemas tienen que mantener ese estándar para sí mismos, no esperar a que la regulación lo imponga.
Gracias por la discusión perspicaz. Los lectores interesados en explorar la plataforma y su enfoque de la infraestructura de datos de salud pueden obtener más información visitando Aquila Health.






