
Ángulo de Anderson
Disney combina CGI con renderizado neuronal para abordar el “valle inquietante”

 Añade Unite.AI a tus fuentes preferidas en Google
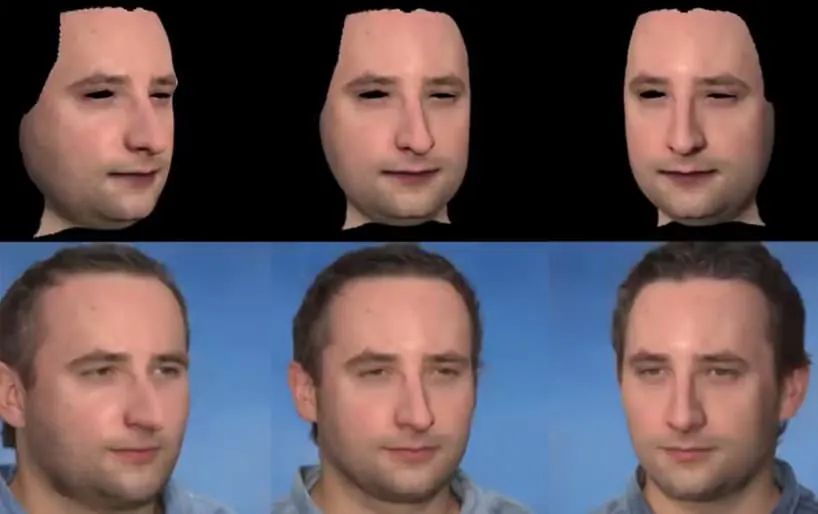
La división de investigación en IA de Disney ha desarrollado un método híbrido para la simulación facial de calidad cinematográfica, combinando las fortalezas del renderizado neuronal facial con la consistencia de un enfoque basado en CGI.
El artículo pendiente se titula Rendering with Style: Combining Traditional and Neural Approaches for High Quality Face Rendering, y se presenta en un nuevo video de 10 minutos en el canal de Disney Research en YouTube (incrustado al final de este artículo*).
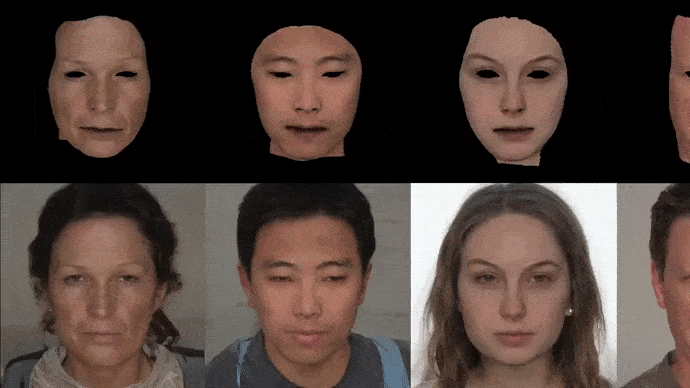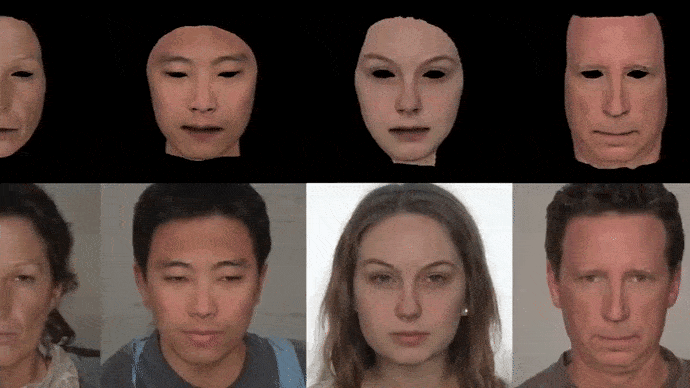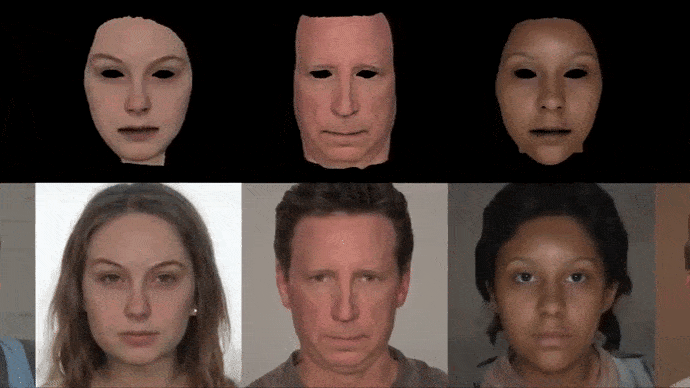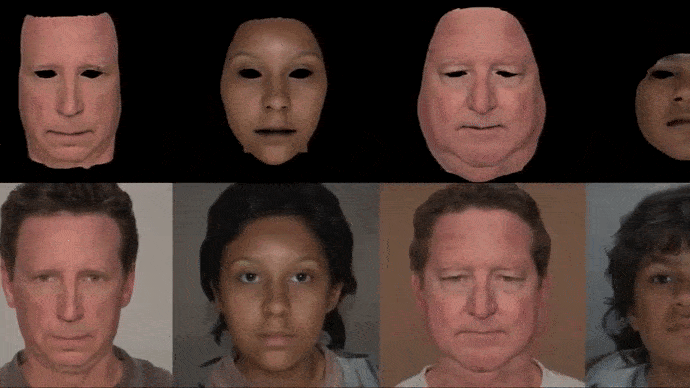
Meshes combined with neural facial renders. See video embed at end of article for better detail and quality. Source: https://www.youtube.com/watch?v=TwpLqTmvqVk
Como señala el video, el renderizado neuronal de rostros (incluidos los deepfakes) puede producir ojos y cavidades bucales mucho más realistas que lo que el CGI es capaz de lograr, mientras que las texturas faciales impulsadas por CGI son más consistentes y adecuadas para la producción de VFX a nivel cinematográfico.
Por lo tanto, Disney está experimentando con permitir que el generador neuronal StyleGan2 de NVIDIA maneje los rasgos circundantes de un rostro y los elementos “críticos para la vida” como los ojos, mientras superpone una piel facial CGI consistente y elementos relacionados en el resultado.
From the video (see end of article), the architectural concept behind Disney’s hybrid approach, where an old-school CGI mesh, of the type used to recreate ‘young’ Carrie Fisher and the late Peter Cushing for Rogue One (2016), is integrated into neurally-rendered face environments.
El video hace una referencia tácita a la frecuente crítica sobre la falta de autenticidad y el efecto del “valle inquietante” de la recreación CGI del fallecido actor británico de Star Wars, Peter Cushing, en Rogue One (2016), concediendo:
‘[Todavía] hay una gran brecha entre lo que la gente puede capturar y renderizar fácilmente y los dobles digitales fotorrealistas finales, completos con cabello, ojos y cavidad bucal interna. Para cerrar esta brecha, normalmente se requiere mucho trabajo manual de artistas especializados.’
En realidad, incluso los sistemas de captura facial más modernos no intentan recrear los ojos, las cavidades bucales internas o el cabello, los cuales presentan problemas de autenticidad en dichas técnicas (ojos) o de consistencia temporal (cabello).

The video illustrates what VFX artists will get after a typical modern facial capture session. Eyes, hair, facial hair, and mouth interiors will all have to be handled by separate teams in the production pipeline, in addition to texturing and lighting.
Control de Iluminación
El enfoque híbrido también aporta una ventaja en la reiluminación, un desafío notable para el renderizado neuronal de rostros, ya que las superposiciones de piel CGI pueden reiluminarse con mayor facilidad.

An animated version of the CGI/Neural approach.
En entornos más desafiantes, como rodajes en exteriores, los investigadores han desarrollado un método de rellenado alrededor de una especie de zona desmilitarizada que rodea a la persona que está siendo “creada”.
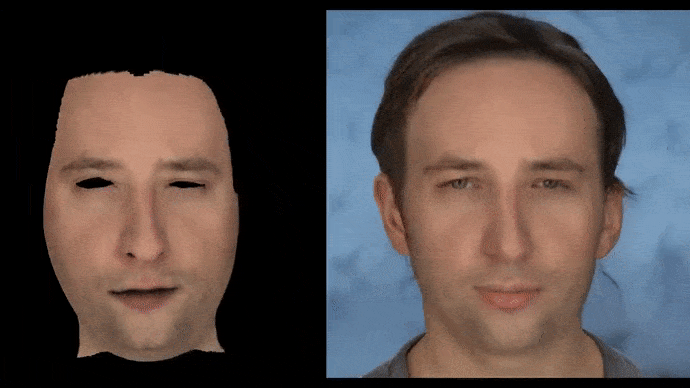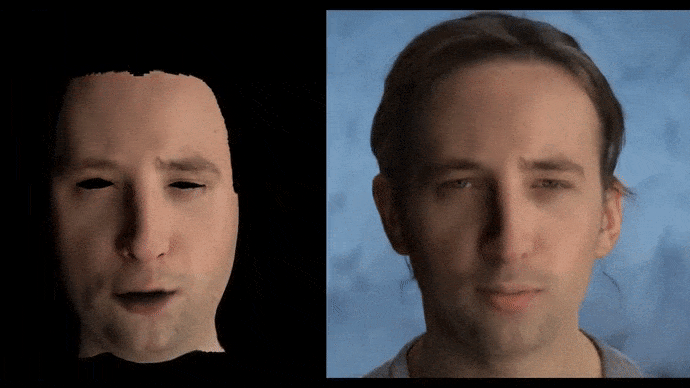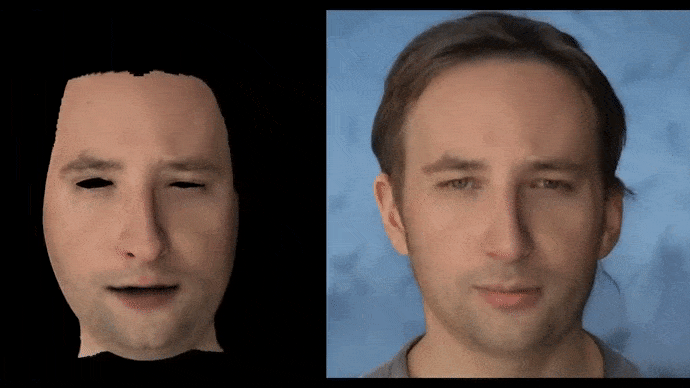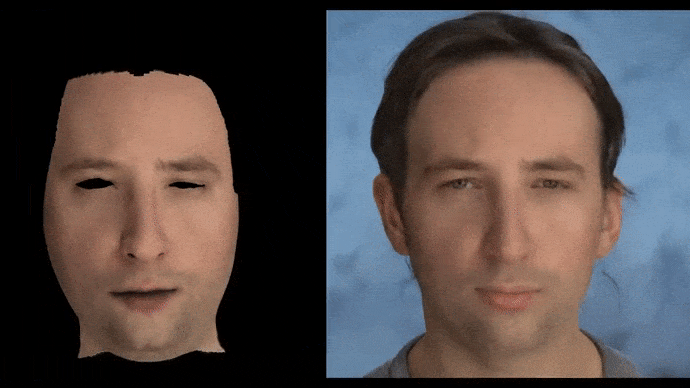
A black margin is generated to allow a ‘canvas’ for inpainting the outer parts of the identity and integrating the CGI skin into the combined CGI/neural output.
El video señala:
‘[El] render neuronal no coincide perfectamente con la restricción del fondo. – solo sirve como guía, ya que la optimización de componentes humanos realistas como el cabello, los ojos y los dientes es el objetivo principal. Lo más desafiante es intentar mantener una identidad consistente, mientras se cambia la iluminación del entorno.’
Creación de Mallas CGI a partir de Renderizados Neuronales
El equipo de investigación también ha desarrollado un autoencoder variacional entrenado con una (no especificada) gran base de datos de imágenes faciales 3D, y afirma que puede generar mallas faciales 3D “aleatorias pero plausibles” a partir de datos de verdad terreno.
Existen limitaciones que esta investigación debe superar, incluida la dificultad de mantener el cabello temporalmente consistente en los renderizados neuronales, y el video (ver más abajo) muestra varios ejemplos de cabello que muta rápidamente en un paneo de otro modo consistente alrededor de un rostro CGI/neural.
La consistencia temporal en el renderizado de video neuronal es un problema mucho más amplio que el de Disney, y parece probable que iteraciones posteriores de este sistema recurran a añadir cabello “en postproducción”, u otras posibles técnicas de generación de cabello, en lugar de esperar que un nuevo enfoque neuronal lo resuelva eventualmente.
Usos para la Generación de Conjuntos de Datos
El método también se propone como una posible forma de generar datos sintéticos y enriquecer el panorama de conjuntos de imágenes faciales, que en los últimos años se ha vuelto peligrosamente monótono.

Disney envisages the new technique populating facial image datasets.
‘[Cada] resultado fotorrealista que generamos tiene una geometría subyacente correspondiente y mapas de apariencia, renderizados desde puntos de vista de cámara desconocidos con iluminación conocida. Esta información de “verdad terreno” puede ser vital para entrenar aplicaciones posteriores, como la reconstrucción monocular 3D de rostros, reconocimiento facial o comprensión de escenas. Por lo tanto, cada renderizado de resultados podría considerarse una muestra de datos, y podemos generar muchas variaciones de muchos individuos diferentes.’
‘Además, incluso para una sola persona renderizada con una única expresión, punto de vista e iluminación, podemos generar variaciones aleatorias del render fotorrealista variando la semilla de aleatoriedad durante la optimización.’
Los investigadores señalan que esta diversidad de salida configurable podría ser útil para entrenar aplicaciones de reconocimiento facial, concluyendo:
‘[Nuestro] método es capaz de aprovechar la tecnología actual para la captura, modelado y renderizado de piel facial, y crear automáticamente renders faciales fotorrealistas completos que coincidan con la identidad, expresión y configuración de escena deseadas. Este enfoque tiene aplicaciones en el renderizado facial para cine y entretenimiento, ahorrando trabajo manual a los artistas, y también para la generación de datos en diferentes campos del aprendizaje profundo.’
Para una visión más profunda del nuevo enfoque, consulte el video de 10 minutos publicado hoy:
https://www.unite.ai/why-adversarial-image-attacks-are-no-joke/
* El enlace original del video fue sustituido por otro aparentemente idéntico 8 horas después de que se publicara este artículo. Cambié todos los enlaces relevantes, ya que no queda rastro del video original.
8:24 GMT+2 – Video reemplazado, ya que fue retirado por el canal de Disney Research en YouTube por alguna razón.


