
Lo mejor
10 mejores herramientas de extracción de datos web con IA (noviembre 2026)

 Añade Unite.AI a tus fuentes preferidas en Google
Unite.AI puede recibir una compensación cuando usa enlaces a productos que evaluamos. Esto no influye en nuestras evaluaciones editoriales. Lea nuestra divulgación de afiliados.
Puntos claveAjuste la herramienta de scraping al trabajo posterior a la carga en lugar de tratar…
Ver más
- Ajuste la herramienta de scraping al trabajo posterior a la carga en lugar de tratar toda la recolección como un único problema.
- Asigne la propiedad del flujo de trabajo a las personas que comprenden tanto los sitios de origen como el resultado requerido.
- Presupueste en función de los registros utilizables en lugar de las cifras destacadas de solicitudes, porque el renderizado y los proxies inflan los totales.
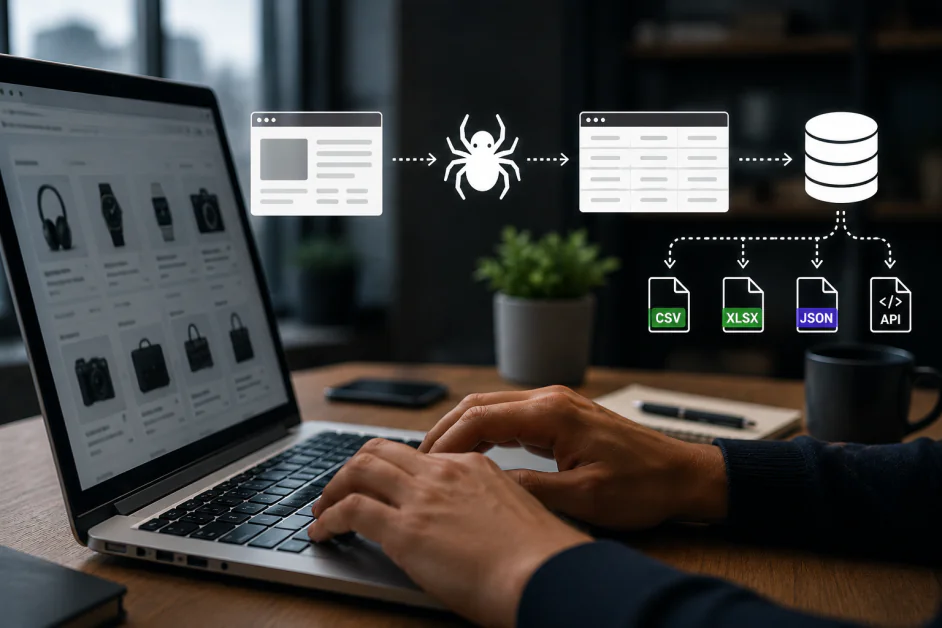
La mejor herramienta de extracción de datos web con IA depende de lo que quieras hacer después de que se cargue una página. Un asistente de investigación necesita contenido legible y enlaces a las fuentes. Un sistema de inteligencia de mercado necesita registros coherentes a gran escala. Un agente interactivo puede necesitar un navegador capaz de hacer clic en varios pasos y mantener activa la sesión.
Esta guía abarca diez herramientas para esas tareas, entre ellas plataformas de recopilación para empresas, API de contenido, herramientas de extracción sin código, servicios de datos de búsqueda y navegadores gestionados. Evaluamos cómo recopila información cada producto, quién puede mantener el flujo de trabajo y qué aspectos deben tenerse en cuenta cuando un prototipo se convierte en un proceso recurrente.
Nuestro equipo evaluó de forma independiente todas las soluciones de esta guía y analizó sus capacidades, ventajas prácticas, limitaciones y adecuación a los casos de uso reflejados en nuestra clasificación.
Comparativa de las mejores herramientas de extracción de datos web con IA
| Herramienta de IA | Ideal para | Ventajas principales |
|---|---|---|
| Bright Data | Recopilación empresarial y diversas canalizaciones de datos | API de extracción, Browser API, Scraper Studio, conjuntos de datos, proxies |
| Firecrawl | Contenido web para aplicaciones de IA | Buscar, extraer, mapear, rastrear, Markdown, JSON, interactuar, MCP |
| Apify | Tareas de extracción reutilizables y orquestación en la nube | Actors, Crawlee, programaciones, almacenamiento, proxies, API, MCP |
| Browse AI | Recopilación sin código y supervisión de cambios | Configuración asistida por IA, robots, alertas, programaciones, integraciones |
| SearchAPI | Resultados de búsqueda estructurados e investigación localizada | Google, mapas, compras, vídeo, plataformas de búsqueda con IA, JSON |
| Octoparse | Extracción visual con ejecución recurrente en la nube | Plantillas, asistente de IA, detección automática, ejecuciones en la nube, exportaciones |
| Browserless | Navegadores gestionados para Puppeteer y Playwright | Navegadores alojados, sesiones persistentes, API REST, MCP |
| ScrapingBee | Extracción gestionada mediante una API de aplicación | Extracción con IA, CSS/XPath, Markdown, escenarios de JS, MCP |
| Oxylabs | Recuperación gestionada de datos de sitios web públicos exigentes | Web API /Scrape, renderizado, salida estructurada, MCP |
| Diffbot | Extracción automática e inteligencia sobre entidades | Extraer, esquemas estándar, rastrear, Knowledge Graph |
Cómo elegir una herramienta de extracción de datos web con IA
Elige la herramienta según la tarea
Para una base de conocimientos de IA, prioriza el texto legible, los datos estructurados y la conservación de las URL de origen. En la investigación empresarial recurrente, un robot visual y las alertas de cambios pueden ser más importantes que una interfaz de programación. Para un agente interactivo, fíjate en la continuidad de la sesión y el control del navegador. Las API de resultados de búsqueda resuelven otro problema: proporcionan datos de búsqueda, mientras que recopilar las páginas enlazadas es un paso aparte.
Decide quién se encargará del flujo de trabajo
Una plataforma sin código permite que un analista ajuste directamente los pasos de extracción. Una API ofrece a los desarrolladores una interfaz sencilla para integrar la recopilación en una aplicación. Una plataforma de tareas en la nube incorpora programación y almacenamiento, mientras que un navegador gestionado deja más de la lógica de automatización en manos de tu equipo. La opción adecuada pone el mantenimiento en manos de quienes entienden tanto los sitios web de origen como el formato de salida requerido.
Presupuesta los registros útiles, no las solicitudes anunciadas
Compara el costo de una tarea completada con el de los campos que necesitas. El renderizado, los proxies prémium, la duración del navegador, la extracción con IA, el almacenamiento y los intentos repetidos pueden modificar el costo total. Un crédito gratuito, una unidad de navegador y una solicitud de búsqueda son medidas diferentes. Para el trabajo recurrente, además de las respuestas satisfactorias, controla la integridad, los duplicados, la actualidad y el costo por registro utilizable.
Las 10 mejores herramientas de extracción de datos web con IA
1. Bright Data
Bright Data es nuestra recomendación general para las organizaciones que necesitan varias formas de obtener datos web desde una misma plataforma. Su oferta incluye API de extracción listas para usar, conjuntos de datos recopilados previamente, Scraper Studio, Web Unlocker y servicios de proxy. Por ejemplo, un equipo de inteligencia de comercio electrónico puede utilizar fuentes estructuradas para minoristas conocidos y, al mismo tiempo, crear una recopilación personalizada para un mercado especializado. Esta amplitud resulta especialmente útil cuando el programa de datos va más allá de un solo sitio web o departamento.
Para páginas interactivas, Browser API aloja navegadores que los desarrolladores controlan con Puppeteer, Playwright o Selenium. Combina la ejecución del navegador con la gestión de proxies y la resolución de CAPTCHA, mientras que la compatibilidad con Chrome DevTools ayuda a los ingenieros a inspeccionar sesiones problemáticas. Esto resulta útil cuando un flujo de trabajo necesita navegar o interactuar con una página antes de que esté disponible la información deseada, en lugar de limitarse a descargar un conjunto de datos existente.
La principal contrapartida es la selección de productos y la gestión de costos. El tráfico del navegador, los resultados del raspado y la compra de conjuntos de datos corresponden a cargas de trabajo distintas, por lo que un único precio destacado no puede describir toda la plataforma. Bright Data es adecuado para equipos que cuentan con una persona responsable de la calidad de la recopilación, la cobertura de los objetivos y el gasto. Un proyecto de alcance limitado puede llegar a producción más rápido con una API de extracción más sencilla.
Ventajas y desventajas
- Amplias opciones de recopilación en una sola plataforma
- Los navegadores alojados son compatibles con bibliotecas de automatización consolidadas
- Las API y los conjuntos de datos listos para usar agilizan la configuración
- Los distintos productos requieren una planificación de costos por separado
- Las canalizaciones personalizadas siguen necesitando supervisión técnica
2. Firecrawl
Firecrawl es nuestra elección para los desarrolladores que convierten contenido web en contexto útil para una aplicación de IA. Sus herramientas de búsqueda, extracción, mapeo y rastreo cubren todo el proceso, desde encontrar una página hasta recopilar el contenido de un sitio web; además, Markdown y JSON estructurado reducen el trabajo de limpieza posterior a la recuperación. Así, un asistente de investigación o un producto de base de conocimiento puede dedicar más esfuerzo a responder preguntas y menos a eliminar menús de navegación del HTML sin procesar.
Su oferta actual, Interact, amplía la plataforma para incluir tareas en navegadores en tiempo real. Los agentes pueden describir acciones en lenguaje natural o ejecutar código en el navegador, mantener el estado entre llamadas y reutilizar perfiles autenticados. Esto supone una mejora importante para las páginas que requieren hacer clic, aplicar filtros o iniciar sesión antes de extraer información. El acceso mediante MCP y la línea de comandos también hace que Firecrawl resulte práctico en los flujos de desarrollo de agentes, y no solo como una API de aplicación convencional.
Firecrawl funciona mejor cuando la adquisición de contenido es la necesidad inmediata y la aplicación ya gestiona el almacenamiento y la recuperación. Los equipos aún deben definir los límites del rastreo, conservar las URL de origen y distinguir entre un campo ausente y uno vacío. Su código de código abierto ofrece otra opción de implementación, pero los equipos deben evaluar las funciones específicas y los requisitos operativos de la implementación elegida, en lugar de dar por sentado que las versiones alojada y autogestionada son idénticas.
Ventajas y desventajas
- Markdown y JSON son adecuados para las canalizaciones de IA
- Interact permite realizar tareas con estado en el navegador
- Acceso mediante API, MCP y CLI
- El contenido recuperado aún requiere validación
- Las implementaciones autogestionadas requieren trabajo operativo
3. Apify
Apify es la opción más sólida de esta selección para los equipos que buscan herramientas de extracción reutilizables y una plataforma donde ejecutarlas. Su mercado distribuye Actors: programas empaquetados que reciben datos de entrada, se ejecutan en la nube y devuelven resultados. Los Actors existentes pueden agilizar las tareas de recopilación habituales, mientras que los Actors personalizados permiten a los desarrolladores conservar su propia lógica de extracción. Esto convierte a Apify en un puente útil entre un experimento y un trabajo de producción repetible.
La plataforma también se encarga de aspectos operativos importantes, como la programación, el almacenamiento de resultados, el acceso a proxies, la supervisión y las integraciones. Los desarrolladores también pueden crear soluciones con Crawlee, su biblioteca de código abierto para rastreo y automatización de navegadores. El servidor MCP de Apify pone los Actors a disposición de los agentes de IA, de modo que una misma herramienta empaquetada puede servir a una aplicación, una canalización programada o un asistente sin necesidad de crear una implementación de extracción independiente para cada interfaz.
La selección de Actors merece tanta atención como la selección de la plataforma. Los distintos proveedores pueden ofrecer precios, mantenimiento, opciones de entrada y calidad de salida diferentes. Además, que una ejecución finalice correctamente no demuestra que se hayan recopilado todos los registros esperados. Apify resulta especialmente atractivo cuando alguien se responsabiliza del esquema del trabajo, supervisa los cambios y presupuesta el uso del Actor y de la infraestructura seleccionados; una extracción manual de una sola página rara vez necesita tanta coordinación.
Ventajas y desventajas
- Los Actors listos para usar y los personalizados comparten una misma plataforma
- La programación, el almacenamiento y la supervisión permiten repetir trabajos
- MCP integra los Actors en los flujos de trabajo de agentes
- El mantenimiento y la calidad de los Actors varían
- Es necesario presupuestar el uso y los cargos de los Actors
4. Browse AI
Browse AI es nuestra recomendación para usuarios empresariales que necesitan datos web recurrentes sin tener que desarrollar un proyecto de software. Su configuración actual puede leer una página proporcionada, proponer una estructura de datos y permitir que el usuario revise o ajuste los campos. La formación de robots sigue siendo fundamental para que la extracción sea repetible. Es un enfoque práctico para los equipos de operaciones y marketing que recopilan catálogos de productos, entradas de directorios o información de la competencia en tablas conocidas.
La supervisión es uno de sus puntos fuertes. Los robots pueden revisar páginas según un calendario, detectar incorporaciones o cambios y enviar alertas que expliquen qué se ha modificado. Los flujos de trabajo pueden conectar la recopilación entre distintas páginas, mientras que las integraciones con API, webhook y hojas de cálculo ayudan a que los resultados lleguen a las herramientas que el equipo ya utiliza. Así, un flujo de trabajo de seguimiento de precios puede convertirse en un proceso empresarial continuo, en lugar de una serie de comprobaciones manuales en el navegador.
La facilidad de uso no elimina la necesidad de definir claramente los datos. Los usuarios deben decidir qué cambios justifican una alerta y confirmar que la paginación, los pasos de inicio de sesión y los resultados vacíos funcionan correctamente. Los rediseños importantes aún pueden requerir intervención. Browse AI es ideal cuando un equipo empresarial puede revisar las filas extraídas y mantener el robot; los desarrolladores que necesiten una lógica de navegador con un control de versiones estricto quizá prefieran un servicio basado en código.
Ventajas y desventajas
- La configuración de campos asistida por IA reduce las barreras de entrada
- La supervisión programada destaca los cambios importantes
- Conexiones con hojas de cálculo, API y webhook
- Los cambios importantes en los sitios pueden exigir volver a entrenar el robot
- La lógica compleja requiere diseñar cuidadosamente el flujo de trabajo
5. SearchAPI
SearchAPI es nuestra recomendación especializada para recopilar resultados de búsqueda como datos estructurados. Su API de Google puede devolver enlaces a resultados y funciones de búsqueda en formato JSON, lo que evita tener que mantener un analizador para una página de resultados que cambia con frecuencia. Su catálogo más amplio incluye fuentes como mapas, compras, noticias, vídeos y experiencias de búsqueda con IA compatibles. Es especialmente útil cuando el producto de datos es el descubrimiento y la visibilidad en las búsquedas, y no un paso previo para rastrear otro sitio web.
La localización es una parte importante de esa adecuación. Los parámetros de ubicación, país, idioma y dispositivo permiten a los equipos estudiar un mercado desde un contexto de búsqueda definido. Una aplicación de SEO puede seguir una consulta en una ciudad, mientras que un asistente de investigación puede descubrir fuentes pertinentes y conservar los enlaces obtenidos para recuperarlos más adelante. La documentación específica de cada motor es importante porque los parámetros disponibles y los campos de resultados varían según el producto de búsqueda.
Conviene elegir SearchAPI en función de los motores y campos que realmente necesita el flujo de trabajo. Un resultado de búsqueda no contiene todo el contenido de la página enlazada, y las distintas presentaciones enriquecidas de resultados no siguen todas el mismo esquema. Los equipos deben prever el volumen de solicitudes, confirmar los requisitos de capacidad de procesamiento y gestionar adecuadamente la ausencia de secciones en los resultados. Para extraer datos de sitios web arbitrarios o interactuar con un navegador, es mejor empezar con otra herramienta de esta guía.
Ventajas y desventajas
- Los resultados estructurados evitan tener que mantener un analizador de páginas de resultados de búsqueda (SERP)
- Amplio catálogo de motores de búsqueda y servicios relacionados
- Controles detallados de localización
- Los resultados de búsqueda no sustituyen la extracción de datos de las páginas de destino
- Los campos y parámetros varían según el motor
6. Octoparse
Octoparse muestra su copiloto de IA y la automatización con intervención humana. Vídeo: Octoparse.
Octoparse es una buena opción para los analistas que quieren diseñar un extractor visualmente y ejecutarlo después de forma repetida. Su plataforma actual ofrece plantillas listas para usar, configuración con el Asistente de IA y detección automática de páginas en la aplicación de escritorio. Los usuarios pueden perfeccionar la tarea resultante en lugar de empezar con código para el navegador. Esa flexibilidad resulta útil para recopilar catálogos de productos, directorios o listados en los que la secuencia de páginas importa tanto como los campos de cada página.
La ejecución en la nube convierte una tarea preparada en un proceso de recopilación recurrente sin necesidad de mantener encendido un ordenador personal. La programación, el trabajo en paralelo, la rotación de direcciones IP y las conexiones de exportación permiten que los trabajos de mayor envergadura vayan más allá de un prototipo de escritorio. El enfoque visual resulta especialmente atractivo para los equipos que conocen sus sitios web de origen y sus requisitos de datos, pero no quieren mantener un servicio personalizado de automatización del navegador.
Octoparse sigue requiriendo un diseño cuidadoso de las tareas. La paginación, el desplazamiento infinito, los pasos de formulario y los registros duplicados pueden cambiar el significado de una ejecución que parece haber tenido éxito. Las cuotas de uso en la nube y las funciones del plan deben ajustarse a la frecuencia y al volumen previstos. Lo recomendamos cuando un equipo necesita más control sobre los pasos de extracción del que ofrece una herramienta rápida de un solo clic, y cuenta con una persona responsable que pueda ajustar la tarea cuando cambien las páginas de origen.
Ventajas y desventajas
- Las plantillas y la asistencia de IA simplifican la configuración
- La edición visual permite crear tareas de extracción detalladas
- La ejecución en la nube permite programar la recopilación
- Los sitios complejos requieren perfeccionar la tarea
- Las funciones en la nube dependen del plan seleccionado
7. Browserless
Recomendamos Browserless a los desarrolladores que quieren controlar un navegador y dejar su alojamiento y escalado en manos de un servicio gestionado. Los scripts existentes de Puppeteer o Playwright pueden conectarse a navegadores remotos, lo que lo convierte en una opción atractiva para proyectos que ya cuentan con código de automatización funcional. Esto resulta especialmente útil cuando la recopilación requiere varias interacciones, una interfaz con mucho JavaScript o una sesión que debe mantenerse activa más allá de una única solicitud sencilla.
El servicio también ofrece API REST para scraping, capturas de pantalla, archivos PDF y funciones de navegador personalizadas. Su servidor MCP alojado pone herramientas de navegador a disposición de los agentes de IA, mientras que las funciones de sesión y los perfiles autenticados permiten mantener la continuidad de los flujos de trabajo. Por eso, Browserless es adecuado tanto para un desarrollador que crea un recopilador de datos personalizado como para un agente que necesita navegar y recopilar información mediante un navegador real.
El principal aspecto que hay que tener en cuenta al contratarlo es cómo se contabiliza el uso del navegador. Actualmente, el plan gratuito incluye 1.000 unidades al mes y dos navegadores simultáneos; no garantiza 1.000 extracciones. El tiempo de uso del navegador consume unidades, y el tráfico de proxy y las resoluciones satisfactorias de CAPTCHA generan cargos adicionales; los límites de sesión varían según el plan. Los equipos siguen siendo responsables de la lógica de extracción y de comprobar los resultados, por lo que Browserless resulta más atractivo cuando el control del navegador es más importante que un creador visual de robots.
Ventajas y desventajas
- Mantiene los flujos de trabajo habituales de Puppeteer y Playwright
- Las API REST permiten hacer scraping y exportar páginas
- Las funciones de sesión y MCP son adecuadas para agentes interactivos
- El tiempo de uso del navegador y los complementos afectan al consumo de unidades
- La extracción personalizada sigue requiriendo lógica de aplicación
8. ScrapingBee
ScrapingBee es una excelente opción para los desarrolladores que prefieren una solicitud de scraping gestionada en lugar de controlar directamente un navegador de larga duración. Su API combina la obtención de páginas y la renderización de JavaScript con la gestión de proxies, y permite extraer datos mediante reglas CSS o XPath, o instrucciones de IA. Esta combinación resulta útil cuando un proyecto necesita registros estructurados de varios sitios web, pero no quiere gestionar su propia infraestructura de navegadores.
Los escenarios de JavaScript pueden hacer clic, desplazarse, escribir o esperar antes de recopilar los datos. La salida en Markdown facilita los flujos de trabajo de contenido con IA, y las capturas de pantalla permiten guardar la página renderizada. El producto actual también ofrece API específicas para determinados sitios, además de acceso mediante CLI y MCP. Un desarrollador puede usar reglas de extracción explícitas para campos estables y extracción en lenguaje natural cuando la estructura de la página o la pregunta sean menos previsibles.
La diferencia respecto a una plataforma de navegadores alojados es práctica: ScrapingBee se centra en la solicitud y el resultado que devuelve, mientras que una aplicación personalizada se encarga del trabajo más amplio. La coordinación entre páginas, la eliminación de duplicados, los calendarios de actualización y la validación de registros siguen necesitando una solución propia. El consumo de créditos también varía según las funciones utilizadas, incluidas la renderización y las opciones de proxy. Lo recomendamos a los equipos de desarrollo de aplicaciones que valoran una interfaz HTTP sencilla y quieren gestionar la orquestación de su canalización de datos en su propio código.
Ventajas y desventajas
- Las reglas de selección y la extracción con IA ofrecen flexibilidad
- La renderización y los escenarios permiten trabajar con páginas interactivas
- Markdown, CLI y MCP facilitan los flujos de trabajo con IA
- Las opciones avanzadas de solicitud aumentan el consumo de créditos
- Los trabajos con varias páginas siguen necesitando orquestación
9. Oxylabs
Oxylabs es una excelente opción para los equipos que necesitan acceso gestionado a sitios web públicos difíciles de recopilar y una forma de aumentar el volumen de recopilación. Su Web API actual incluye /Scrape, una función para obtener y estructurar datos web, con renderización de JavaScript y gestión del acceso integradas en el servicio. La oferta de productos también incluye /Search e infraestructura de navegadores, lo que brinda a los equipos distintos enfoques según si la tarea empieza por descubrir, extraer o interactuar.
Las opciones específicas para cada destino permiten obtener campos útiles de fuentes habituales de búsqueda y comercio, mientras que las conexiones de agentes mediante MCP y Agent Skills incorporan la recopilación a los flujos de trabajo con IA. Oxylabs también sigue documentando por separado su Classic Web Scraper API. Esta distinción es importante para las integraciones existentes: los equipos que mantengan la Classic API deben consultar la documentación correspondiente, en lugar de dar por sentado que un ejemplo más reciente de Web API es intercambiable con ella.
Oxylabs resulta más adecuado cuando la dificultad del sitio de destino, el volumen de procesamiento o el coste de mantener la infraestructura de acceso justifican una plataforma gestionada. La aplicación sigue teniendo que definir el esquema deseado, el intervalo de actualización y cómo gestionar los registros incompletos. Antes de implementarla, hay que asegurarse de que la generación de API elegida, las opciones de destino y el modelo de uso se ajusten al trabajo concreto. Para una extracción manual pequeña, un scraper visual puede ser una opción más directa.
Ventajas y desventajas
- Infraestructura administrada para la renderización y el acceso
- Opciones de extracción estructurada específicas para cada objetivo
- La API web actual admite integraciones con agentes
- Las API clásica y actual requieren configuraciones distintas
- La calidad de los resultados aún requiere verificaciones en la aplicación
10. Diffbot
Elegimos Diffbot cuando comprender la información de una página importa más que reproducir su diseño. Extract utiliza visión artificial y procesamiento del lenguaje natural para clasificar páginas y generar JSON estructurado mediante esquemas estándar. Para un equipo que recopila artículos o productos de muchas fuentes, esto puede reducir la cantidad de código de análisis específico de cada sitio que se necesita para convertir las páginas en registros comparables.
Knowledge Graph aborda una necesidad relacionada, pero distinta: trabajar con entidades como organizaciones, personas y artículos que ya se han reunido a partir de la web pública. Los registros pueden combinar información de varios orígenes y vincular entidades mediante relaciones significativas. Esto hace que Diffbot sea útil para enriquecer datos, investigar empresas y desarrollar aplicaciones de inteligencia que necesitan contexto más allá de los campos visibles en una sola página.
La contrapartida es que hay que ajustarse al modelo de datos de Diffbot. La extracción estandarizada es valiosa cuando sus tipos de página y campos se ajustan a la tarea, pero un campo poco habitual o una interacción especializada pueden requerir otro enfoque. Los equipos deben distinguir entre extraer las URL que han elegido y consultar un grafo de conocimiento existente, y luego evaluar la cobertura y la actualidad de las fuentes en consecuencia. Diffbot es más adecuado para equipos técnicos que crean productos de información con datos normalizados que para usuarios que solo necesitan copiar unas pocas filas en una hoja de cálculo.
Ventajas y desventajas
- La clasificación automática reduce el trabajo de análisis
- Los esquemas estándar ayudan a normalizar páginas similares
- Knowledge Graph aporta contexto sobre las entidades
- Es posible que los campos estándar no cubran requisitos especializados
- La extracción y el acceso al grafo responden a flujos de trabajo distintos
Preguntas frecuentes
¿Qué hace que una herramienta de extracción de datos web funcione con IA?
La IA puede ayudar a identificar campos, interpretar el contenido de una página, generar pasos de extracción o controlar acciones del navegador. Algunas herramientas usan IA durante la configuración; otras, en cada extracción. Un servicio también puede ayudar a las aplicaciones de IA proporcionando contenido limpio sin usar un modelo de lenguaje en cada solicitud. Elige la capacidad que resuelva tu problema de recopilación, en lugar de guiarte por la etiqueta.
¿Cuál es la diferencia entre la extracción de datos y la automatización del navegador?
La extracción de datos recopila información. La automatización del navegador realiza acciones en las páginas, como abrir menús, introducir una búsqueda o avanzar por un flujo de trabajo de varios pasos. Ambas suelen combinarse: un navegador automatizado llega al estado pertinente de la página y, después, un paso de extracción recopila los campos. Si esas interacciones no son necesarias, normalmente es más sencillo hacer una solicitud directa a una API.
¿Qué herramientas son más adecuadas para un equipo sin conocimientos técnicos?
Nuestra primera recomendación para la recopilación periódica de datos sencilla y la supervisión de cambios es Browse AI. Octoparse es una buena alternativa cuando el equipo quiere controlar visualmente los pasos de las tareas. Ambas funcionan mejor cuando alguien revisa los registros obtenidos y sabe reconocer cuándo ha cambiado el sitio web de origen.
¿Qué debe conservar un flujo de trabajo de IA o RAG de una extracción de datos?
Conserva la URL de origen, la hora de recopilación, el título de la página y el texto o los campos estructurados que necesita la aplicación. Markdown puede preservar una estructura documental legible, mientras que JSON permite definir registros. Elimina el contenido duplicado y evita mezclar el texto de navegación con el contenido principal. Conservar la procedencia facilita rastrear y actualizar las respuestas más adelante.
¿Cuándo conviene usar un navegador administrado?
Un navegador administrado resulta útil cuando la recopilación requiere ejecutar JavaScript, realizar varias interacciones o mantener la continuidad de la sesión, y el equipo quiere evitar alojar procesos del navegador. Browserless es una opción especializada para el código existente de Puppeteer o Playwright. Para una sola página estática, una API más sencilla de obtención o extracción puede consumir menos recursos.
¿Equivalen 1.000 unidades gratuitas a 1.000 extracciones?
No. Cada proveedor establece sus propias reglas para las unidades y los créditos. Browserless mide las conexiones al navegador en bloques de hasta 30 segundos; el tráfico de proxy y la resolución de CAPTCHA consumen unidades adicionales. Otros servicios cobran según las opciones de solicitud, los registros o el cómputo. Calcula el flujo de trabajo completo en lugar de equiparar las distintas asignaciones gratuitas.
¿Se puede confiar en un resultado de extracción con IA sin revisarlo?
Una respuesta JSON válida aún puede omitir un registro o interpretar mal un campo. Define los campos obligatorios, comprueba los tipos y los rangos, revisa una muestra de las páginas de origen y supervisa los cambios en la cantidad de registros. En los trabajos recurrentes, es más útil especificar claramente los estados de error y de resultado vacío que tratar cada respuesta como un conjunto de datos completo.
Reflexiones finales sobre las herramientas de extracción de datos web con IA
Bright Data es nuestra opción favorita en general para un programa amplio de recopilación de datos web, mientras que Firecrawl es el mejor punto de partida para convertir páginas web en contenido listo para la IA. Elige Apify cuando las herramientas reutilizables, las tareas programadas y las operaciones en la nube sean fundamentales para el proyecto.
Para los equipos empresariales, Browse AI facilita el monitoreo periódico, y Octoparse ofrece a los usuarios una forma visual de perfeccionar tareas de extracción más complejas. SearchAPI es la opción especializada cuando se necesitan datos de búsqueda estructurados.
Browserless se gana su lugar entre las opciones para desarrolladores que buscan ejecutar navegadores de forma administrada con bibliotecas de automatización conocidas. ScrapingBee es una alternativa sólida cuando una solicitud de extracción administrada se adapta mejor a la aplicación. Oxylabs es adecuada para la recuperación exigente de datos de la web pública, mientras que Diffbot destaca por la extracción estandarizada y la inteligencia de entidades.
La mejor opción a largo plazo es la que proporciona la información necesaria mediante un flujo de trabajo que tu equipo pueda mantener. Adapta el método de recopilación a la tarea, conserva el contexto de las fuentes y evalúa el valor según la utilidad de los resultados, no por la cantidad de páginas solicitadas.




