
Entrevistas
Ben Koska, Fundador y CEO de SF Tensor – Serie de Entrevistas

 Añade Unite.AI a tus fuentes preferidas en Google
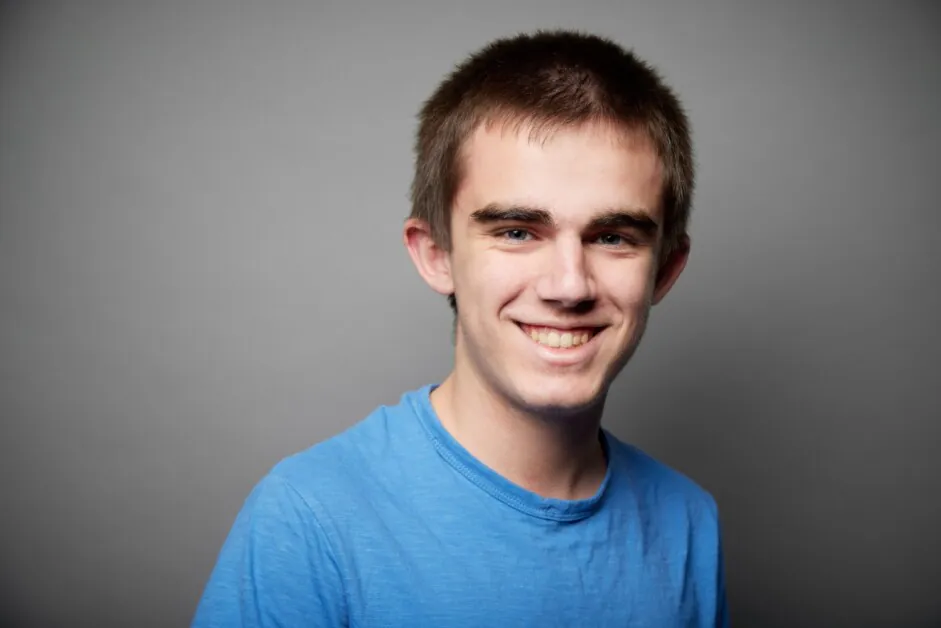
Ben Koska, Fundador y CEO de SF Tensor, es un investigador de inteligencia artificial y ingeniero de sistemas conocido por su trabajo en computación de alto rendimiento, optimización de kernel y entrenamiento de modelos eficientes. Su experiencia abarca el desarrollo de infraestructura de inteligencia artificial de bajo nivel, la mejora del rendimiento del entrenamiento y el diseño de herramientas que hacen que el desarrollo de modelos avanzados sea accesible sin la sobrecarga de ingeniería pesada. Se centra en construir sistemas que empujan los límites de la velocidad, la portabilidad y la confiabilidad en hardware heterogéneo.
SF Tensor es la empresa que dirige para convertir esa filosofía en una plataforma práctica. Introduce un modelo de programación unificado, un optimizador de kernel y una capa de orquestación entre nubes diseñada para eliminar la complejidad de las cargas de trabajo de inteligencia artificial distribuida. La plataforma tiene como objetivo dar a los ingenieros un entorno limpio y agnóstico de hardware donde puedan escribir una vez, implementar en cualquier lugar y lograr automáticamente un alto rendimiento. La misión de SF Tensor es hacer que la computación de inteligencia artificial sea dramáticamente más rápida, fácil de administrar y libre de bloqueo de proveedores.
Usted fundó SF Tensor a los 19 años, después de liderar la ingeniería en varias startups. ¿Qué lo inspiró a asumir el desafío de reinventar la infraestructura de inteligencia artificial tan temprano en su carrera?
El problema que estamos resolviendo es uno que me preocupa profundamente, porque es uno que yo mismo encontré. Cuando desarrollamos lo que ahora es la pila principal de SF Tensor, no estábamos trabajando en un proyecto comercial, era en realidad un esfuerzo académico. Habíamos recibido una subvención para realizar algunas investigaciones interesantes, pero pasamos la mayor parte del tiempo luchando con la infraestructura y las optimizaciones, en lugar de hacer investigación. Encontramos que la gente estaba universalmente más interesada en nuestra tecnología de infraestructura, no en nuestro proyecto de investigación.
SF Tensor se enfrenta a uno de los problemas más difíciles de la inteligencia artificial: romper con la dominancia de CUDA de NVIDIA. ¿Cómo abordó el diseño de un sistema que podría lograr una verdadera portabilidad de hardware sin comprometer el rendimiento?
Al final del día, toda la inteligencia artificial se reduce a simples matemáticas. Cada modelo es esencialmente un conjunto de operaciones matemáticas que debemos calcular los resultados. Al tratarlo principalmente como un problema matemático en lugar de un problema de ciencia de la computación, podemos identificar el conjunto más pequeño de restricciones en los cálculos, luego generar millones a miles de millones de formas diferentes de convertir esos cálculos en código de máquina, encontrando el más rápido. Eso es más fácil de decir que de hacer, ya que no podemos ejecutar realmente miles de millones de programas diferentes para encontrar el más rápido, así que para reducir nuestro espacio de búsqueda, tuvimos que crear un modelo matemático preciso para estimar la velocidad de un programa determinado para un hardware determinado, lo que es una de las innovaciones clave que hacen posible lo que hacemos hoy en día.
El blog de la empresa destaca innovaciones en torno a la optimización del compilador y la orquestación entre nubes. ¿Puede explicar cómo el enfoque de SF Tensor difiere de los marcos existentes como PyTorch o JAX?
No hemos escrito un blog técnico al respecto todavía, pero en realidad admitimos marcos como PyTorch y JAX, lo que permite que el código escrito en ellos sea optimizado por nuestra pila. Hay varias decisiones arquitectónicas que JAX y PyTorch tomaron que los diferencian de nuestra pila, pero la más significativa es que tratamos todo el modelo como un solo cálculo por resolver, en lugar de módulos individuales que deben ser optimizados individualmente y luego conjuntamente. En este sentido, en lugar de aplicar técnicas de optimización de compilador tradicionales y tratar de aplicar cada optimización individual, creamos un espacio de búsqueda de millones a veces miles de millones de kernels potenciales y afirmamos que ningún ser humano puede posiblemente llegar a un conjunto de reglas para transformar cualquier código dado en el más rápido, así que debemos simplemente crear todas las combinaciones y luego identificar la más rápida.
Muchas startups se centran en la eficiencia del entrenamiento, pero usted ha enfatizado el “impuesto de infraestructura” — el tiempo que los investigadores pierden al administrar la computación en lugar de innovar. ¿Cómo aborda SF Tensor este desequilibrio?
Creamos que ambos problemas deben abordarse, y gran parte de nuestro trabajo se centra en abordar la eficiencia del entrenamiento, pero el problema más agudo que podemos resolver ahora sin depender de futuras innovaciones es el impuesto de infraestructura, ya que es un problema que ya hemos resuelto para nosotros mismos.
Usted ha mencionado lograr reducciones de hasta el 80% en los costos de entrenamiento. ¿Qué optimizaciones o avances arquitectónicos específicos hacen posible esto?
Nuestra pila de software completa se basa en la idea de que un compilador basado en búsqueda siempre superará a las reglas creadas por humanos. Hasta ahora, la mayor restricción para estos compiladores ha sido el hecho de que no es posible probar y clasificar miles de millones o incluso millones de kernels. Fue necesario que creáramos un modelo matemático de cómputo que pueda estimar con precisión el tiempo que tomará un cálculo determinado o un conjunto de cálculos en un hardware determinado. Al hacer esto, podemos expandir nuestro espacio de búsqueda y luego reducirlo, lo cual es una necesidad si queremos encontrar los kernels más rápidos de manera consistente.
¿Cómo su experiencia en la creación del lenguaje de programación Emma influye en la arquitectura y la filosofía de SF Tensor hacia el rendimiento y la abstracción?
No se lo digan a mis inversionistas, pero en el fondo, sigo siendo un ingeniero de compiladores. Siempre me ha interesado encontrar formas de hacer que las cosas sean incluso ligeramente más rápidas. Al desarrollar Emma, tiramos el compilador completo 4 o 5 veces; empezamos desde cero, cada vez porque nos encontramos con una optimización que no podíamos implementar dadas las restricciones actuales, lo que nos obligó a rehacer el sistema para que fuera aún más general, mientras permitía que cayéramos en el nivel más bajo de optimización cuando fuera necesario, a menudo en contra de los principios comunes de diseño de compiladores y lenguajes. Esas lecciones y la arquitectura resultante combinaron casi dos años de lo que parecían optimizaciones menores y apuestas equivocadas, lo que se ha convertido en un sistema que nos permite ahora iterar más rápido y optimizar mejor que cualquier sistema que siga los principios comunes, porque esos principios están fundamentalmente diseñados para CPU, no para GPU y modelos de inteligencia artificial.
Ha trabajado en ejecuciones de entrenamiento a gran escala en más de 4.000 GPU — ¿cuáles fueron algunas de las lecciones más importantes que aprendió al administrar la computación a esa escala?
Una de las más grandes es que la falla del hardware es mucho más prevalente y problemática de lo que se asumiría. Después de pasar mucho tiempo trabajando con programas y compiladores tradicionales, generalmente hablando, una computadora hace exactamente lo que se le dice, y si algo sale mal, es casi siempre culpa de la persona que escribió el código. Con las GPU, por otro lado, la falla del hardware es un evento común, especialmente en entrenamientos distribuidos en clusters extremadamente grandes. Esto va de la mano con el hecho de que, a diferencia de las CPU que generalmente actúan de manera determinista y predecible, las GPU a veces inexplicablemente hacen cosas como reducir la velocidad del reloj sin razón aparente, ralentizando todo el proceso de entrenamiento porque un solo chip se ejecuta más lentamente.
Y Combinator ha respaldado a algunas de las empresas de infraestructura más transformadoras en la tecnología. ¿Cómo ha moldeado su experiencia en Y Combinator su enfoque para escalar el producto y la visión de SF Tensor?
Al entrar en Y Combinator, pensé que la apuesta que queríamos hacer entonces era ambiciosa. Después de solo unas semanas, nuestra definición de ambiciosa había cambiado drásticamente, y nos comprometimos con una apuesta aún mayor. Por otro lado, el sentido de comunidad y aprendizaje que puedo llamar por teléfono o enviar un correo electrónico a prácticamente cualquier empresa o persona allí y recibir una respuesta y consejo en cuestión de horas a días, ha cambiado la forma en que pensamos sobre abordar problemas y adoptar un enfoque significativamente más colaborativo.
Mirando hacia adelante, ha expresado interés en modelos no LLM, robótica y datos sintéticos. ¿Cómo se ajustan estas áreas a su visión a largo plazo para la empresa?
Los LLM son absolutamente una tecnología interesante y tendrán una parte integral en cómo se verá el mundo en el futuro, pero la razón por la que están tan avanzados en comparación con cualquier otra área de la inteligencia artificial se debe principalmente al hecho de que hay mucho dinero invertido en su desarrollo, y hay suficientes personas colaborando en el problema para que hayan obtenido una optimización bastante buena. Si podemos reducir la barrera de entrada, permitiendo que los investigadores de todo el país y el planeta, incluso aquellos con recursos limitados y poco o ningún conocimiento en optimizaciones, realicen su investigación de la manera más barata y eficiente posible, creo que veremos una nueva generación de modelos que abordarán problemas que los LLM no están diseñados para abordar, ya sea porque interactúan con el mundo físico o porque son problemas que no se pueden expresar adecuadamente en lenguaje.
¿Qué cree que se verá como la pila de infraestructura de inteligencia artificial dentro de cinco años — y dónde ve el papel de SF Tensor dentro de ella?
Dentro de cinco años, espero que muchas más empresas habrán desarrollado y lanzado sus propios chips especializados, y que los investigadores podrán aprovecharlos y utilizarlos sin necesidad de escribir código específico para ellos, idealmente sin necesidad de saber que existen. Ese es el futuro hacia el que estamos trabajando y en el que creo que tendremos un papel significativo en darle forma.
Gracias por la gran entrevista, los lectores que deseen aprender más pueden visitar SF Tensor.


