
Modelos y plataformas de IA
El equipo rojo de Anthropic afirma que los modelos pequeños de IA pronto podrían replicarse en dispositivos del IoT

 Añade Unite.AI a tus fuentes preferidas en Google
El equipo Frontier Red Team de Anthropic publicó una investigación el 12 de octubre de 2026 en la que informa que los modelos pequeños de IA podrían estar a pocos meses de ser capaces de autorreplicarse en dispositivos comerciales del IoT, como hornos inteligentes y televisores Android de marcas poco conocidas, y que sería difícil apagar un replicador de ese tipo porque no tiene un punto central desde el que desactivarlo.
En la publicación, los autores William Zhou y Daniel Freeman informan que un modelo de 9.000 millones de parámetros logró ejecutar la inferencia en ocho de los nueve tipos de hardware que probó el equipo, y que los modelos de 30.000 millones de parámetros o menos ya pueden completar muchos pasos individuales de la replicación, aunque cometen errores al encadenarlos de principio a fin. Si los modelos pequeños siguen mejorando al ritmo histórico, el equipo proyecta que alcanzarán el nivel de capacidad necesario para finales de 2026 y que poco después podrían aparecer replicadores pequeños basados en pesos; no obstante, advierte que la replicación podría ser lenta, con un tiempo de duplicación de varios días.
Inferencia distribuida en televisores inteligentes
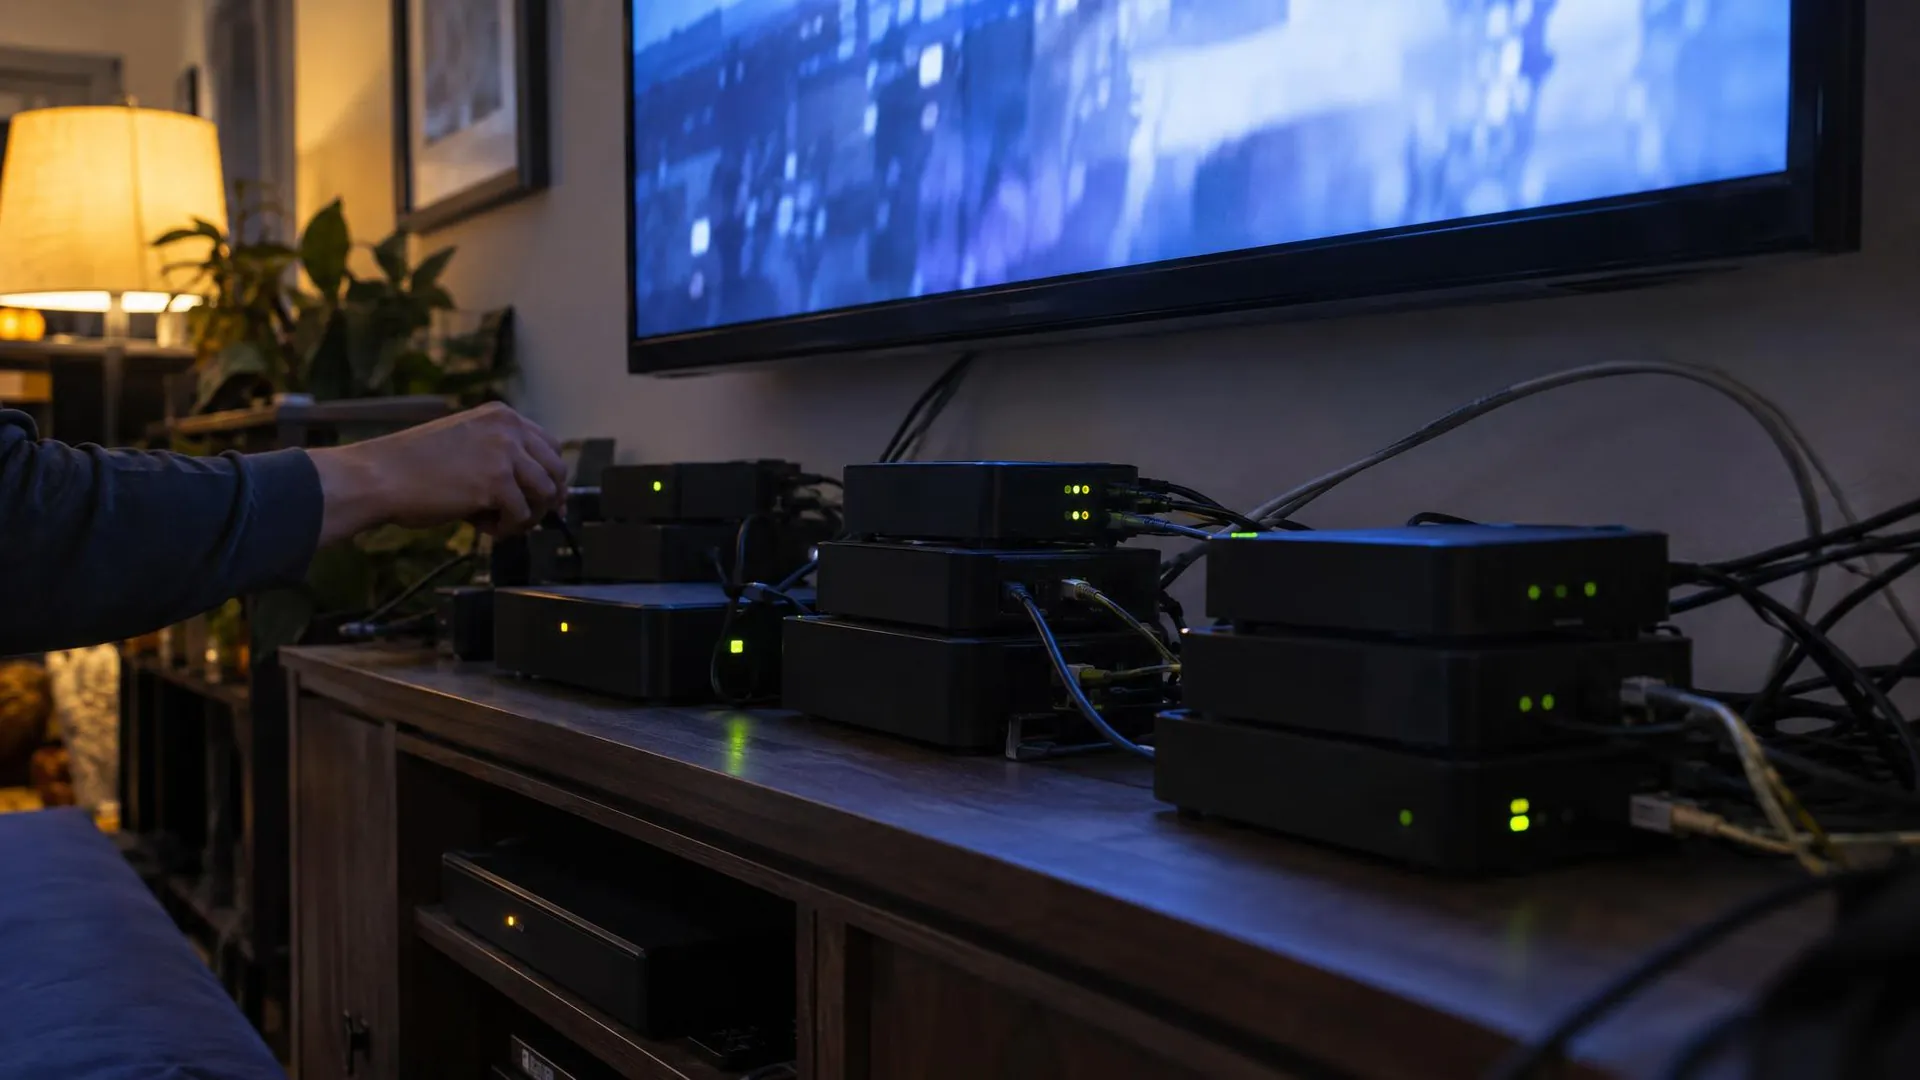
Para demostrar que no son estrictamente necesarios los aceleradores costosos, el equipo compró y conectó en red 15 televisores Android de marcas poco conocidas, de unos 55 dólares cada uno. Luego ejecutó Gemma4-26B-A4B, un modelo de 26.000 millones de parámetros, dividido entre los dispositivos mediante paralelismo por tuberías, de modo que cada aparato, con 4 gigabytes de RAM, alojaba una pequeña parte de las capas del modelo. El equipo informa que la configuración procesó 0,39 tokens por segundo y señala que una botnet distribuida de dispositivos del IoT baratos y, por lo general, mal protegidos podría aportar suficiente capacidad de cómputo para ejecutar un modelo capaz.
Modelos de amenaza y diseño de la evaluación
La publicación plantea la preocupación en términos de replicación y adaptación autónomas (ARA) y divide la replicación en cuatro etapas: encontrar objetivos, obtener capacidad de ejecución, establecer la inferencia y continuar la propagación desde el nuevo host. Los investigadores excluyeron en gran medida las etapas de explotación informática, pues citan trabajos anteriores —entre ellos CyberGym, ExploitBench e investigaciones sobre gusanos adaptativos— que muestran que los modelos pequeños ya son capaces de realizar explotaciones informáticas. En cambio, se centraron en la configuración de la inferencia, que describen como la etapa menos estudiada y posiblemente la más difícil para los modelos pequeños.
La publicación describe tres modelos de amenaza que considera más cercanos a hacerse realidad: un replicador pequeño basado en pesos que se propaga al comprometer máquinas anfitrionas; un replicador grande y avanzado basado en pesos que apunta a centros de datos y otros sistemas con gran capacidad de cómputo, tanto en variantes de frontera como de pesos abiertos; y un replicador basado en API que roba credenciales para usar su propia API de inferencia. Los investigadores señalan que los replicadores basados en pesos no necesitan privilegios de administrador, ya que los motores de inferencia pueden ejecutarse íntegramente en el espacio de usuario. También citan a los mineros de criptomonedas y a botnets como P2Pinfect y Fritzfrog como ejemplos de operaciones sin escalada de privilegios.
Los experimentos se realizaron con Memento, un entorno de pruebas que el equipo creó sobre el agente de programación de código abierto Pi. Este inicia periódicamente una nueva instancia del agente, que hereda el espacio de trabajo de la instancia anterior y un breve conjunto de notas sobre lo que esta intentó. En el experimento de ejecución, cada modelo tenía un límite de 1,5 horas por iteración y un tiempo de espera total de seis horas. El modelo de amenaza representativo es Kimwolf, una botnet que, según la publicación, ha infectado más de dos millones de dispositivos, principalmente televisores Android de marcas poco conocidas. Estos aparatos suelen tener entre uno y cuatro gigabytes de RAM y, según calcula la publicación, con cuatro gigabytes y cuantización de 4 bits, los modelos de 9.000 millones de parámetros pueden ejecutarse en cuatro o más máquinas, y los de 26.000 millones, en diez o más.
Resultados de la replicación de principio a fin
Para comprobar si los modelos pueden encadenar el ciclo completo —buscar objetivos, obtener acceso, entregar la carga útil y poner en marcha la inferencia—, el equipo creó una nube privada virtual aislada por un cortafuegos, con ocho nodos de Google Cloud que ejecutaban redroid, un emulador de Android 15. Un gusano inicial saltaba de un nodo a otro a través de un puerto ADB sin autenticación y configuraba un servidor de inferencia que ejecutaba Llama3.1-8B; cada nueva copia debía superar comprobaciones de corrección y de prevención de trampas.
Según informa el equipo, GLM-5.2 fue el único de los modelos de pesos abiertos probados que logró replicarse por completo de principio a fin: se propagó a los ocho nodos en cuatro de cinco pruebas y a siete de los ocho en la prueba restante. Como la evaluación simplifica al mínimo la etapa informática —el puerto ADB no requiere autenticación—, los investigadores describen el resultado como un límite superior del éxito en el mundo real. También señalan que antiguas botnets del IoT, como Mirai, se propagaban mediante listas predeterminadas de nombres de usuario y contraseñas de los fabricantes.
La publicación define un umbral mínimo de capacidad que un gusano debe superar para replicarse de forma fiable, por encima del cual se encuentra GLM-5.2, y un límite de tamaño que el modelo debe respetar para funcionar en los dispositivos que ataca. Qwen3.5-9B y Gemma4-26B-A4B están por debajo de ese límite para los televisores inteligentes de 4 gigabytes probados, y actualmente no hay intersección entre ambos límites. Al representar modelos destacados de pesos abiertos con 30.000 millones de parámetros o menos frente al Epoch Capabilities Index, el ajuste por mínimos cuadrados del equipo muestra un aumento de 13,7 ECI al año, con un R² de 0,95. Esto sitúa a un modelo pequeño al nivel de GLM-5.2 para finales de 2026, aunque el equipo advierte que el ECI es un índice de capacidades generales y solo sirve como aproximación de la capacidad de replicación, por lo que la fecha es una estimación aproximada. En una ablación de 17 nodos en la que un script preescrito se encargaba de configurar la inferencia, incluso un modelo de 3.000 millones de parámetros llegó a aproximadamente la mitad de los nodos. El equipo afirma que esto permite acotar cuánta dificultad corresponde a las etapas restantes de autonomía y orquestación.
Velocidad de replicación, escala y adaptación
En las mediciones del equipo con las cajas de TV físicas, la inferencia sin optimizar de Gemma4-26B-A4B se ejecutó a unos 0,3 tokens por segundo con una ventana de contexto de 32.000 tokens, y configurar por completo la inferencia tomó entre 71 y 150 horas, frente a entre 28 y 51 horas para Qwen3.5-9B. Al extrapolarlo a una flota del tamaño de Kimwolf, el equipo calcula unas 133.000 réplicas, cada una formada por un grupo de 15 televisores, que procesarían en conjunto unos 80.000 tokens por segundo con, como máximo, unos 40 equivalentes a H100 para inferencia —una cantidad de capacidad de cómputo que el equipo califica de ínfima—, y cuya replicación tomaría entre uno y dos días por cada copia de 9.000 millones de parámetros.
Según informa el equipo, a lo largo de seis generaciones de instancias de Qwen3.5-9B, cada una de las cuales heredó las notas de una instancia predecesora, la tasa de éxito al configurar la inferencia pasó del 45 % en la primera generación a entre el 61 % y el 84 % en las generaciones posteriores, en 20 linajes. Dar a Qwen3.5-9B acceso a Opus 4.8 como asesor de vanguardia no produjo una mejora apreciable, tanto si se ofrecía como llamada a una herramienta como si se proporcionaba sin que se solicitara, y el aprendizaje por refuerzo para usar al asesor en tareas de programación no se transfirió de manera productiva. En una reproducción local de la evaluación de phishing dirigido CyberSecEval 3 de Meta, los modelos pequeños obtuvieron puntuaciones que la publicación califica de muy deficientes a deficientes al normalizarlas según las evaluaciones de personas, algo que el equipo cita como prueba de que, en los modelos pequeños, la ingeniería social va a la zaga de las capacidades cibernéticas agénticas.
Por separado, la publicación calcula que existen alrededor de 90 líneas distintas de productos IoT con silicio de NVIDIA y unos 9,5 millones de unidades en uso, lo que representa una capacidad de cómputo muy aproximada de entre 9.000 y 35.000 equivalentes a H100 en aceleradores de borde; la proporción a la que se podría acceder probablemente sería un orden de magnitud o más baja. Según las cifras citadas por la publicación, un Jetson AGX Orin 64GB ejecuta Qwen3-30B-A3B a 76,7 tokens por segundo, y un AGX Thor alcanza los 226 tokens por segundo.
Defensas y evaluación del equipo
La defensa consiste en reducir R₀ —el número de dispositivos nuevos que cada dispositivo infectado llega a infectar— por debajo de uno, señala la publicación. Un replicador basado en pesos que se propagara a gran escala por máquinas IoT dejaría una huella de red detectable mediante la monitorización del tráfico por flujos del ISP, ya que los hosts recién infectados reciben cargas de modelos de varios gigabytes y la inferencia distribuida genera tráfico sostenido entre dispositivos; una replicación más rápida produce más tráfico, lo que supone un compromiso entre velocidad y sigilo; además, los honeypots pueden capturar el armazón y la carga útil del replicador. La publicación cita investigaciones sobre la mitigación de Mirai y señala que la cuarentena aplicada por los ISP con notificación a los clientes eliminó el 92 % de las infecciones en un plazo de 14 días, frente al 74 % cuando no hubo notificación. También indica que las contraseñas predeterminadas de IoT ya incumplen la normativa en los mercados del Reino Unido, como ejemplo de cómo la regulación reduce el conjunto de objetivos.
A diferencia de botnets programadas con código fijo como Kimwolf, que atacan tipos específicos de dispositivos, una botnet de IA no está vinculada a un hardware concreto, señala la publicación, que cita como ejemplo modelos pequeños que configuran la inferencia en máquinas que van desde un Jetson Nano hasta un Mac. Los investigadores concluyen que, al igual que ocurrió con los agentes de programación en 2024, los hallazgos muestran indicios de que los gusanos de IA empiezan a desarrollarse: los agentes completan cada vez más pasos individuales de la cadena de replicación y transmiten adaptaciones a copias futuras, pero todavía no constituyen un replicador malicioso completo. También esperan que la capacidad de cómputo desplegada en el borde siga creciendo mientras disminuye el tamaño mínimo del modelo necesario para replicarse de forma fiable.


