

Modelos y plataformas de IA
AniPortrait: Síntesis de Animación de Retrato Fotorealista Impulsada por Audio

 Añade Unite.AI a tus fuentes preferidas en Google
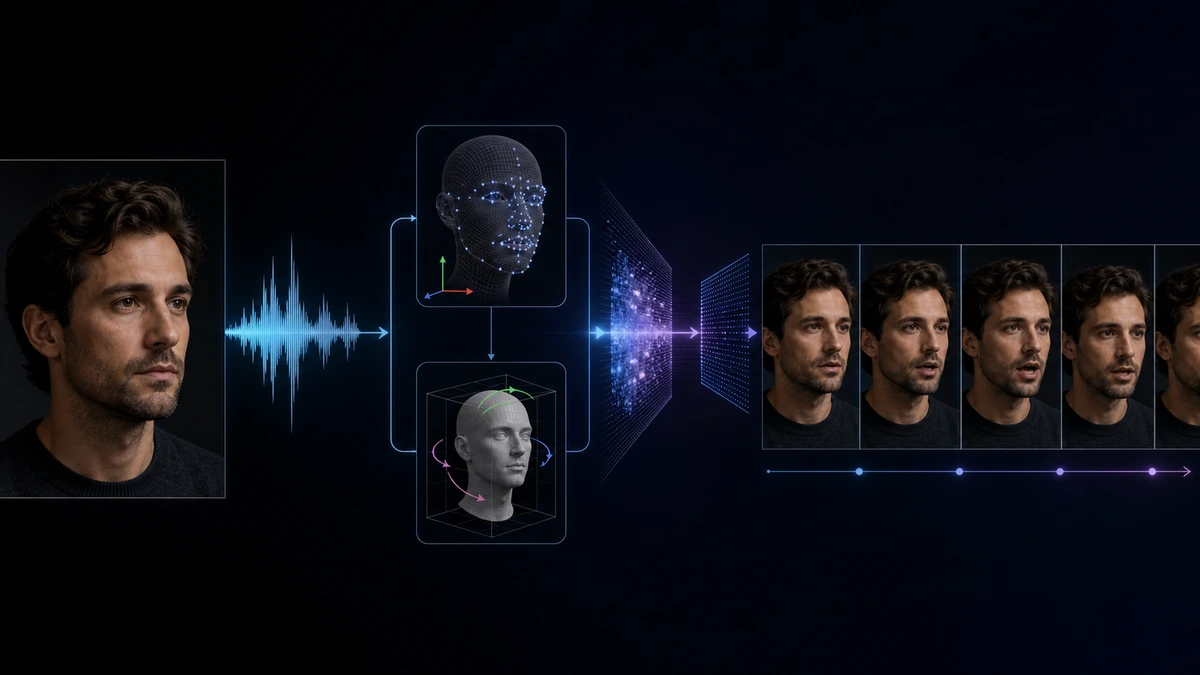
A lo largo de los años, la creación de animaciones de retratos realistas y expresivas a partir de imágenes estáticas y audio ha encontrado una variedad de aplicaciones, incluyendo juegos, medios digitales, realidad virtual y mucho más. A pesar de su potencial aplicación, todavía es difícil para los desarrolladores crear marcos capaces de generar animaciones de alta calidad que mantengan la consistencia temporal y sean visualmente atractivas. Una de las principales causas de la complejidad es la necesidad de una coordinación intrincada de los movimientos de los labios, las posiciones de la cabeza y las expresiones faciales para crear un efecto visualmente atractivo.
En este artículo, hablaremos sobre AniPortrait, un marco novedoso diseñado para generar animaciones de alta calidad impulsadas por una imagen de retrato de referencia y una muestra de audio. El funcionamiento del marco AniPortrait se divide en dos etapas. Primero, el marco AniPortrait extrae las representaciones intermedias 3D de las muestras de audio y las proyecta en una secuencia de puntos faciales 2D. A continuación, el marco emplea un modelo de difusión robusto acoplado con un módulo de movimiento para convertir las secuencias de puntos faciales en animaciones temporales consistentes y fotorealistas. Los resultados experimentales demuestran la superioridad y la capacidad del marco AniPortrait para generar animaciones de alta calidad con una calidad visual excepcional, diversidad de posiciones y naturalidad facial, lo que ofrece una experiencia perceptual mejorada y enriquecida. Además, el marco AniPortrait tiene un potencial notable en términos de controlabilidad y flexibilidad, y se puede aplicar de manera efectiva en áreas que incluyen la reencarnación facial, la edición de movimiento facial y más. Este artículo tiene como objetivo cubrir el marco AniPortrait en profundidad, y exploramos el mecanismo, la metodología, la arquitectura del marco junto con su comparación con los marcos de estado del arte. Así que comencemos.
AniPortrait: Animación de Retrato Fotorealista
Crear animaciones de retratos realistas y expresivas ha sido el enfoque de los investigadores durante un tiempo debido a su increíble potencial y aplicaciones que abarcan desde medios digitales y realidad virtual hasta juegos y más. A pesar de años de investigación y desarrollo, producir animaciones de alta calidad que mantengan la consistencia temporal y sean visualmente atractivas todavía presenta un desafío significativo. Un obstáculo importante para los desarrolladores es la necesidad de una coordinación intrincada entre las posiciones de la cabeza, las expresiones visuales y los movimientos de los labios para crear un efecto visualmente atractivo. Los métodos existentes no han podido abordar estos desafíos, principalmente porque la mayoría de ellos dependen de generadores de capacidad limitada como NeRF, decodificadores basados en movimiento y GAN para la creación de contenido visual. Estas redes exhiben capacidades de generalización limitadas y son inestables al generar contenido de alta calidad. Sin embargo, el reciente surgimiento de los modelos de difusión ha facilitado la generación de imágenes de alta calidad, y algunos marcos construidos sobre modelos de difusión junto con módulos temporales han facilitado la creación de videos atractivos, lo que permite que los modelos de difusión sobresalgan.
Basándonos en los avances de los modelos de difusión, el marco AniPortrait tiene como objetivo generar animaciones de retratos de alta calidad utilizando una imagen de referencia y una muestra de audio. El funcionamiento del marco AniPortrait se divide en dos etapas. En la primera etapa, el marco AniPortrait emplea modelos basados en transformadores para extraer una secuencia de malla facial 3D y posición de la cabeza de la entrada de audio, y las proyecta posteriormente en una secuencia de puntos faciales 2D. La primera etapa permite que el marco AniPortrait capture los movimientos de los labios y las expresiones sutiles desde el audio, además de los movimientos de la cabeza que se sincronizan con el ritmo de la muestra de audio. La segunda etapa, el marco AniPortrait emplea un modelo de difusión robusto y lo integra con un módulo de movimiento para transformar la secuencia de puntos faciales en una animación de retrato fotorealista y temporalmente consistente. Para ser más específicos, el marco AniPortrait se basa en la arquitectura de la red del modelo AnimateAnyone que emplea Stable Diffusion 1.5, un potente modelo de difusión para generar imágenes realistas y fluidas basadas en una imagen de referencia y una secuencia de movimiento corporal. Lo que es digno de nota es que el marco AniPortrait no utiliza el módulo de guía de pose dentro de esta red, ya que se implementa en el marco AnimateAnyone, pero lo rediseña, lo que permite que el marco AniPortrait no solo mantenga un diseño ligero, sino que también exhiba una precisión mejorada al generar movimientos de los labios.
Los resultados experimentales demuestran la superioridad del marco AniPortrait en la creación de animaciones con una naturalidad facial impresionante, una calidad visual excelente y variedad de posiciones. Al emplear representaciones faciales 3D como características intermedias, el marco AniPortrait gana la flexibilidad para modificar estas representaciones según sea necesario. La adaptabilidad mejora significativamente la aplicabilidad del marco AniPortrait en dominios que incluyen la reencarnación facial y la edición de movimiento facial.
AniPortrait: Funcionamiento y Metodología
El marco AniPortrait propuesto se compone de dos módulos, a saber, Lmk2Video y Audio2Lmk. El módulo Audio2Lmk intenta extraer una secuencia de puntos faciales que capturen los movimientos de los labios y las expresiones faciales intrincadas desde la entrada de audio, mientras que el módulo Lmk2Video utiliza esta secuencia de puntos faciales para generar videos de retrato de alta calidad con estabilidad temporal. La siguiente figura presenta una visión general del funcionamiento del marco AniPortrait. Como se puede observar, el marco AniPortrait primero extrae la malla facial 3D y la posición de la cabeza de la entrada de audio, y las proyecta posteriormente en puntos clave 2D. En la segunda etapa, el marco emplea un modelo de difusión para transformar los puntos clave 2D en un video de retrato con dos etapas que se entrenan concurrentemente dentro de la red.

Audio2Lmk
Para una secuencia dada de fragmentos de habla, el objetivo principal del marco AniPortrait es predecir la secuencia correspondiente de malla facial 3D con representaciones vectoriales de traducción y rotación. El marco AniPortrait emplea el método preentrenado wav2vec para extraer características de audio, y el modelo exhibe un alto grado de generalización, y es capaz de reconocer la entonación y la pronunciación desde el audio con precisión, lo que juega un papel crucial en la generación de animaciones faciales realistas. Al aprovechar las características de habla robustas adquiridas, el marco AniPortrait es capaz de emplear una arquitectura simple que consiste en dos capas fc para convertir estas características en mallas faciales 3D. El marco AniPortrait observa que este diseño directo implementado por el modelo no solo mejora la eficiencia del proceso de inferencia, sino que también garantiza la precisión. Cuando se convierte el audio en pose, el marco AniPortrait emplea la misma red wav2vec como la arquitectura base, aunque el modelo no comparte los pesos con el módulo de audio a malla. Esto se debe principalmente a que la pose se asocia más con el tono y el ritmo presentes en el audio, lo que tiene un énfasis diferente en comparación con las tareas de audio a malla. Para tener en cuenta el impacto de los estados anteriores, el marco AniPortrait emplea un decodificador de transformador para decodificar la secuencia de pose. Durante este proceso, el marco integra las características de audio en el decodificador utilizando mecanismos de atención cruzada, y para ambos módulos, el marco los entrena utilizando la pérdida L1. Una vez que el modelo obtiene la secuencia de pose y malla, emplea la proyección en perspectiva para transformar estas secuencias en una secuencia 2D de puntos faciales que se utilizan como señales de entrada para la etapa posterior.
Lmk2Video
Para una imagen de retrato de referencia dada y una secuencia de puntos faciales, el módulo Lmk2Video propuesto crea una animación de retrato temporalmente consistente, y esta animación alinea el movimiento con la secuencia de puntos faciales, y mantiene una apariencia que es consistente con la imagen de referencia, y finalmente, el marco representa la animación de retrato como una secuencia de cuadros de retrato. El diseño de la estructura de la red de Lmk2Video busca inspiración en el marco AnimateAnyone existente. El marco AniPortrait emplea Stable Diffusion 1.5, un modelo de difusión extremadamente potente como su arquitectura base, e incorpora un módulo de movimiento temporal que convierte efectivamente las entradas de ruido multi-marco en una secuencia de cuadros de video. Al mismo tiempo, un componente de red ReferencenNet refleja la estructura de Stable Diffusion 1.5, y lo emplea para extraer la información de apariencia de la imagen de referencia, y la integra en la arquitectura base. El diseño estratégico garantiza que la identidad facial permanezca consistente en todo el video de salida. A diferencia del marco AnimateAnyone, el marco AniPortrait mejora la complejidad del diseño de PoseGuider. La versión original del marco AnimateAnyone comprende solo unas pocas capas de convolución después de las cuales las características de los puntos faciales se fusionan con los latentes en la capa de entrada de la arquitectura base. El marco AniPortrait descubre que el diseño es insuficiente para capturar los movimientos intrincados de los labios, y para abordar este problema, el marco adopta la estrategia de multi-escala de la arquitectura ConvNet, e incorpora características de puntos faciales de escalas correspondientes en diferentes bloques de la arquitectura base. Además, el marco AniPortrait introduce una mejora adicional al incluir los puntos faciales de la imagen de referencia como una entrada adicional. El módulo de atención cruzada del componente PoseGuider facilita la interacción entre los puntos faciales objetivo de cada cuadro y los puntos faciales de referencia. Este proceso proporciona a la red con pistas adicionales para comprender la correlación entre la apariencia y los puntos faciales, lo que ayuda en la generación de animaciones de retrato con un movimiento más preciso.
AniPortrait: Implementación y Resultado
Para la etapa Audio2Lmk, el marco AniPortrait adopta el componente wav2vec2.0 como su arquitectura base, y aprovecha la arquitectura MediaPipe para extraer mallas 3D y posiciones 6D para anotaciones. El modelo obtiene los datos de entrenamiento para el componente Audio2Mesh de su conjunto de datos interno que comprende casi 60 minutos de datos de habla de alta calidad obtenidos de un solo hablante. Para garantizar que la malla 3D extraída por el componente MediaPipe sea estable, al actor de voz se le instruye que enfrente la cámara y mantenga una posición de cabeza estable durante todo el proceso de grabación. Para el módulo Lmk2Video, el marco AniPortrait implementa un enfoque de entrenamiento de dos etapas. En la primera etapa, el marco se centra en entrenar ReferenceNet y PoseGuider, el componente 2D de la arquitectura base, y deja fuera el módulo de movimiento. En la segunda etapa, el marco AniPortrait congela todos los demás componentes y se centra en entrenar el módulo de movimiento. Para esta etapa, el marco utiliza dos conjuntos de datos de video facial de alta calidad y grande para entrenar el modelo, y procesa todos los datos utilizando el componente MediaPipe para extraer puntos faciales 2D. Además, para mejorar la sensibilidad de la red hacia los movimientos de los labios, el modelo AniPortrait diferencia los labios superiores e inferiores con colores distintos al renderizar la imagen de pose desde los puntos faciales 2D.
Como se demuestra en la siguiente imagen, el marco AniPortrait genera una serie de animaciones que demuestran una calidad superior y realismo.

El marco luego utiliza una representación 3D intermedia que se puede editar para manipular la salida según sea necesario. Por ejemplo, los usuarios pueden extraer puntos faciales de una fuente determinada y alterar su ID, lo que permite que el marco AniPortrait cree un efecto de reencarnación facial.
Pensamientos Finales
En este artículo, hemos hablado sobre AniPortrait, un marco novedoso diseñado para generar animaciones de alta calidad impulsadas por una imagen de retrato de referencia y una muestra de audio. Al simplemente ingresar una imagen de referencia y un clip de audio, el marco AniPortrait es capaz de generar un video de retrato que presenta un movimiento natural de la cabeza y un movimiento suave de los labios. Al aprovechar las capacidades de generalización robustas del modelo de difusión, el marco AniPortrait genera animaciones que exhiben una calidad de imagen realista impresionante y un movimiento parecido a la vida. El funcionamiento del marco AniPortrait se divide en dos etapas. Primero, el marco AniPortrait extrae las representaciones intermedias 3D de las muestras de audio y las proyecta en una secuencia de puntos faciales 2D. A continuación, el marco emplea un modelo de difusión robusto acoplado con un módulo de movimiento para convertir las secuencias de puntos faciales en animaciones temporales consistentes y fotorealistas. Los resultados experimentales demuestran la superioridad y la capacidad del marco AniPortrait para generar animaciones de alta calidad con una calidad visual excepcional, diversidad de posiciones y naturalidad facial, lo que ofrece una experiencia perceptual mejorada y enriquecida. Además, el marco AniPortrait tiene un potencial notable en términos de controlabilidad y flexibilidad, y se puede aplicar de manera efectiva en áreas que incluyen la reencarnación facial, la edición de movimiento facial y más.


