Ángulo de Anderson
Matte de Imagen AI que Entiende Escenas

 Añade Unite.AI a tus fuentes preferidas en Google
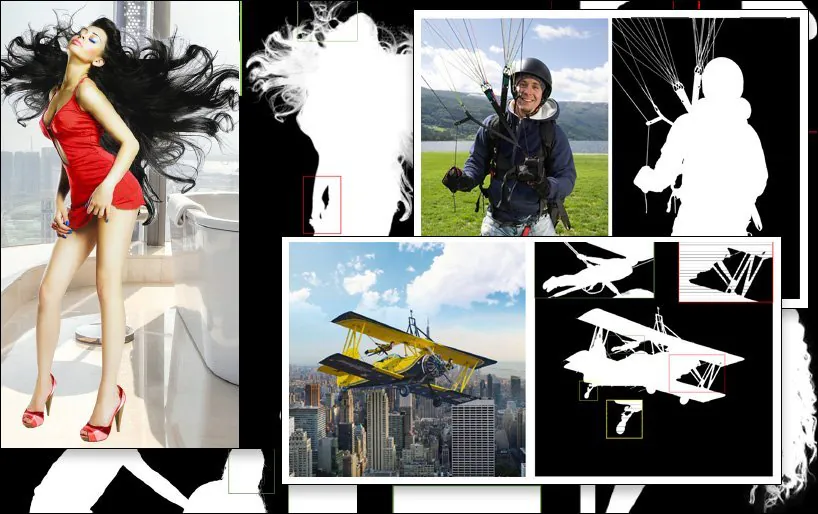
En el documental de extras que acompaña al lanzamiento en DVD de 2003 de Alien3 (1992), la leyenda de los efectos visuales Richard Edlund recordó con horror la “lucha de sumo” de la extracción fotquímica de matte que dominó el trabajo de efectos visuales entre los finales de la década de 1930 y finales de la década de 1980. Edlund describió la naturaleza de ensayo y error del proceso como “lucha de sumo”, en comparación con las técnicas digitales de pantalla azul/verde que se impusieron a principios de la década de 1990 (y él ha retomado la metáfora desde entonces).
Extraer un elemento de primer plano (como una persona o un modelo de nave espacial) de un fondo, de modo que la imagen recortada pueda compositarse en una placa de fondo, se lograba originalmente filmando el objeto de primer plano contra un fondo azul o verde uniforme.
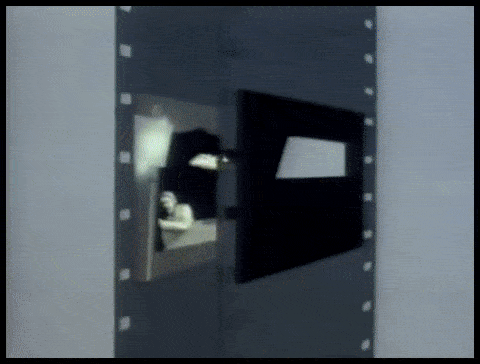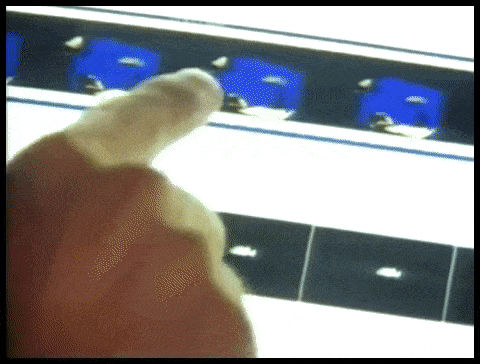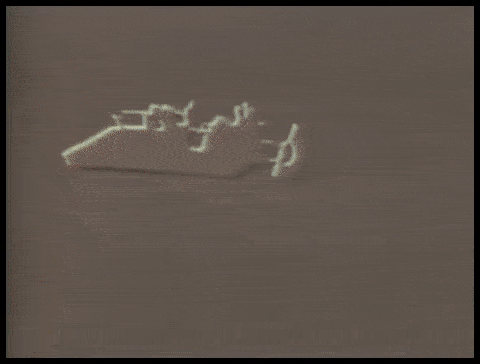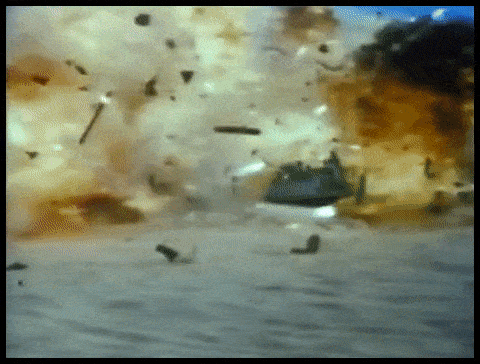
Procesos laboriosos de extracción fotquímica para una toma VFX de ILM para ‘Return of the Jedi’ (1983).
En la filmación resultante, el color del fondo se aislaba químicamente y se utilizaba como plantilla para volver a imprimir el objeto de primer plano (o la persona) en una impresora óptica como un objeto “flotante” en una celda de película transparente.
El proceso se conocía como superposición de separación de color (CSO), aunque este término acabaría asociándose más con los rudimentarios efectos de video ‘Chromakey’ en producciones televisivas de bajo presupuesto de los años 70 y 80, que se lograban con medios analógicos en lugar de químicos o digitales.

Una demostración de Color Separation Overlay en 1970 para el programa infantil británico ‘Blue Peter’. Fuente: https://www.bbc.co.uk/archive/blue_peter_noakes_CSO/zwb9vwx
En cualquier caso, ya sea para elementos de película o video, la filmación extraída podía insertarse en cualquier otra filmación.
Aunque el proceso de vapor de sodio de Disney, notablemente más caro y propietario (que utilizaba una clave amarilla, específicamente, y también fue usado para la película de terror de 1963 de Alfred Hitchcock The Birds), ofrecía mejor definición y mattes más nítidos, la extracción fotquímica seguía siendo laboriosa e poco fiable.

El proceso propietario de vapor de sodio de Disney requería fondos cercanos al extremo amarillo del espectro. Aquí, Angela Lansbury está suspendida en cables durante la producción de una secuencia cargada de VFX para ‘Bedknobs and Broomsticks’ (1971). Fuente
Más allá del Matte Digital
En la década de 1990, la revolución digital eliminó los químicos, pero no la necesidad de pantallas verdes. Ahora era posible eliminar el fondo verde (o cualquier otro color) simplemente buscando píxeles dentro de un rango de tolerancia de ese color, en software de edición de píxeles como Photoshop, y en una nueva generación de suites de composición de video que podían eliminar automáticamente los fondos coloreados. Casi de la noche a la mañana, sesenta años de la industria de impresión óptica fueron relegados a la historia.
Los últimos diez años de investigación en visión por computadora acelerada por GPU están introduciendo la extracción de mattes en una tercera era, desafiando a los investigadores a desarrollar sistemas que puedan extraer mattes de alta calidad sin necesidad de pantallas verdes. Solo en Arxiv, los artículos relacionados con innovaciones en extracción de primer plano basada en aprendizaje automático aparecen semanalmente.
Poniéndonos en la Imagen
Este foco de interés académico e industrial en la extracción con IA ya ha impactado el espacio de consumo: implementaciones crudas pero funcionales nos son familiares en forma de filtros de Zoom y Skype que pueden reemplazar los fondos de nuestras salas de estar por islas tropicales, etc., en videollamadas.
Sin embargo, los mejores mattes aún requieren una pantalla verde, como Zoom señaló el miércoles pasado.

Izquierda, un hombre frente a una pantalla verde, con el cabello bien extraído mediante la función de Fondo Virtual de Zoom. Derecha, una mujer frente a una escena doméstica normal, con el cabello extraído algorítmicamente, de forma menos precisa y con mayores requisitos de cómputo. Fuente: https://support.zoom.us/hc/en-us/articles/210707503-Changing-your-Virtual-Background-image
Una publicación adicional de la plataforma de soporte de Zoom advierte que la extracción sin pantalla verde también requiere mayor potencia de cómputo en el dispositivo de captura.
La Necesidad de Recortar
Las mejoras en calidad, portabilidad y economía de recursos para los sistemas de extracción de mattes “en entornos reales” (es decir, aislar personas sin necesidad de pantallas verdes) son relevantes para muchos más sectores y aplicaciones que solo los filtros de videoconferencia.
Para el desarrollo de conjuntos de datos, el reconocimiento facial, de cabeza completa y de cuerpo completo mejorado ofrece la posibilidad de garantizar que los elementos de fondo superfluos no se entrenen en los modelos de visión por computadora de sujetos humanos; un aislamiento más preciso mejoraría enormemente las técnicas de segmentación semántica diseñadas para distinguir y asimilar dominios (p. ej. ‘gato’, ‘persona’, ‘barco’), y mejoraría los sistemas de síntesis de imágenes basados en VAE y transformer, como el nuevo DALL-E 2 de OpenAI; y mejores algoritmos de extracción reducirían la necesidad de costoso rotoscopia manual en costosas tuberías de VFX.
De hecho, el auge de los enfoques multimodales (generalmente texto/imagen), donde un dominio como “gato” se codifica tanto como imagen como con referencias textuales asociadas, ya está incursionando en el procesamiento de imágenes. Un ejemplo reciente es la arquitectura Text2Live, que utiliza entrenamiento multimodal (texto/imagen) para crear videos de, entre innumerables posibilidades, cisnes de cristal y jirafas de vidrio.
Matte AI Consciente del Escenario
Gran parte de la investigación sobre matte automático basado en IA se ha centrado en el reconocimiento de bordes y la evaluación de agrupaciones de píxeles dentro de una imagen o fotograma de video. Sin embargo, una nueva investigación de China ofrece una cadena de extracción que mejora la delineación y la calidad del matte al aprovechar descripciones basadas en texto de una escena (un enfoque multimodal que ha ganado tracción en el sector de investigación en visión por computadora en los últimos 3‑4 años), alegando haber mejorado los métodos anteriores de varias maneras.

Un ejemplo de extracción SPG-IM (última imagen, inferior derecha), comparado con métodos previos competidores. Fuente: https://arxiv.org/pdf/2204.09276.pdf
El desafío planteado para el sub‑sector de investigación de extracción es producir flujos de trabajo que requieran un mínimo absoluto de anotación manual e intervención humana, idealmente ninguno. Además de las implicaciones de costo, los investigadores del nuevo artículo observan que las anotaciones y segmentaciones manuales realizadas por trabajadores externos de distintas culturas pueden hacer que las imágenes se etiqueten o incluso segmenten de diferentes maneras, lo que conduce a algoritmos inconsistentes e insatisfactorios.
Un ejemplo de esto es la interpretación subjetiva de lo que define un “objeto de primer plano”:

Del nuevo artículo: los métodos previos LFM y MODNet (‘GT’ significa Ground Truth, un resultado “ideal” que a menudo se logra manualmente o mediante métodos no algorítmicos), tienen diferentes y variadas interpretaciones de la definición del contenido de primer plano, mientras que el nuevo método SPG-IM delimita de manera más eficaz el “contenido cercano” mediante el contexto de la escena.
Para abordar esto, los investigadores han desarrollado una cadena de dos etapas titulada Situational Perception Guided Image Matting (SPG-IM). La arquitectura de codificador/decodificador de dos etapas comprende Situational Perception Distillation (SPD) y Situational Perception Guided Matting (SPGM).

La arquitectura SPG-IM.
Primero, SPD preentrena transformaciones de características visual‑a‑textuales, generando subtítulos apropiados a sus imágenes asociadas. Después de esto, la predicción de la máscara de primer plano se habilita al conectar la cadena a una novedosa técnica de predicción de saliencia.
Luego, SPGM genera un matte alfa estimado basado en la imagen RGB sin procesar y la máscara generada obtenida en el primer módulo.
El objetivo es la guía mediante percepción situacional, en la que el sistema tiene una comprensión contextual de lo que contiene la imagen, lo que le permite enmarcar, por ejemplo, el desafío de extraer cabello complejo de un fondo teniendo en cuenta las características conocidas de esa tarea específica.

En el ejemplo siguiente, SPG-IM comprende que los cordones son intrínsecos a un “paracaídas”, donde MODNet no logra retener ni definir esos detalles. De manera similar, arriba, la estructura completa del aparato del parque infantil se pierde arbitrariamente en MODNet.
El nuevo artículo se titula Situational Perception Guided Image Matting y proviene de investigadores del OPPO Research Institute, PicUp.ai y Xmotors.
Mattes Automatizados Inteligentes
SPG-IM también ofrece una Red de Refinamiento de Transformación Focal Adaptativa (AFT) que puede procesar los detalles locales y el contexto global por separado, facilitando “mattes inteligentes”.

Comprender el contexto de la escena, en este caso “niña con caballo”, puede potencialmente facilitar la extracción del primer plano más que los métodos anteriores.
El artículo afirma:
‘Creemos que las representaciones visuales derivadas de la tarea visual‑a‑textual, por ejemplo la generación de subtítulos de imágenes, se centran en señales semánticamente más completas entre a) objeto a objeto y b) objeto al entorno ambiental, para generar descripciones que pueden abarcar tanto la información global como los detalles locales. Además, comparado con la costosa anotación de píxeles en el matte de imágenes, las etiquetas textuales pueden recopilarse masivamente a muy bajo costo.’
La rama SPD de la arquitectura se preentrena conjuntamente con el decodificador textual basado en transformadores VirTex de la Universidad de Michigan, que aprende representaciones visuales a partir de subtítulos semánticamente densos.

VirTex entrena conjuntamente una ConvNet y Transformadores mediante pares imagen‑subtítulo, y transfiere los conocimientos obtenidos a tareas de visión posteriores como la detección de objetos. Fuente: https://arxiv.org/pdf/2006.06666.pdf
Entre otras pruebas y estudios de ablación, los investigadores evaluaron SPG-IM contra métodos de vanguardia basados en trimap como Deep Image Matting (DIM), IndexNet, Context-Aware Image Matting (CAM), Guided Contextual Attention (GCA), FBA y Semantic Image Mapping (SIM).
Otros marcos previos evaluados incluyeron enfoques sin trimap como LFM, HAttMatting y MODNet. Para una comparación justa, los métodos de prueba se adaptaron según las distintas metodologías; donde el código no estaba disponible, las técnicas del artículo se reprodujeron a partir de la arquitectura descrita.
El nuevo artículo afirma:
‘Nuestro SPG-IM supera a todos los métodos sin trimap competidores ([LFM], [HAttMatting] y [MODNet]) por un amplio margen. Mientras tanto, nuestro modelo también muestra una notable superioridad sobre los métodos basados en trimap y guiados por máscaras de última generación (SOTA) en los cuatro métricos de los conjuntos de datos públicos (es decir, Composition-1K, Distinction-646 y Human-2K), y nuestro benchmark Multi-Object-1K.’
Y continúa:
‘Se puede observar claramente que nuestro método conserva los detalles finos (p. ej., puntas de cabello, texturas transparentes y bordes) sin la guía de un trimap. Además, comparado con otros modelos sin trimap competidores, nuestro SPG-IM puede mantener una mejor completitud semántica global.’


Primera publicación el 24 de abril de 2022.