
الذكاء الاصطناعي العام وذكاء المستقبل
ما هو اختبار تورينج ولماذا يهم؟

 أضف Unite.AI إلى مصادرك المفضلة على Google
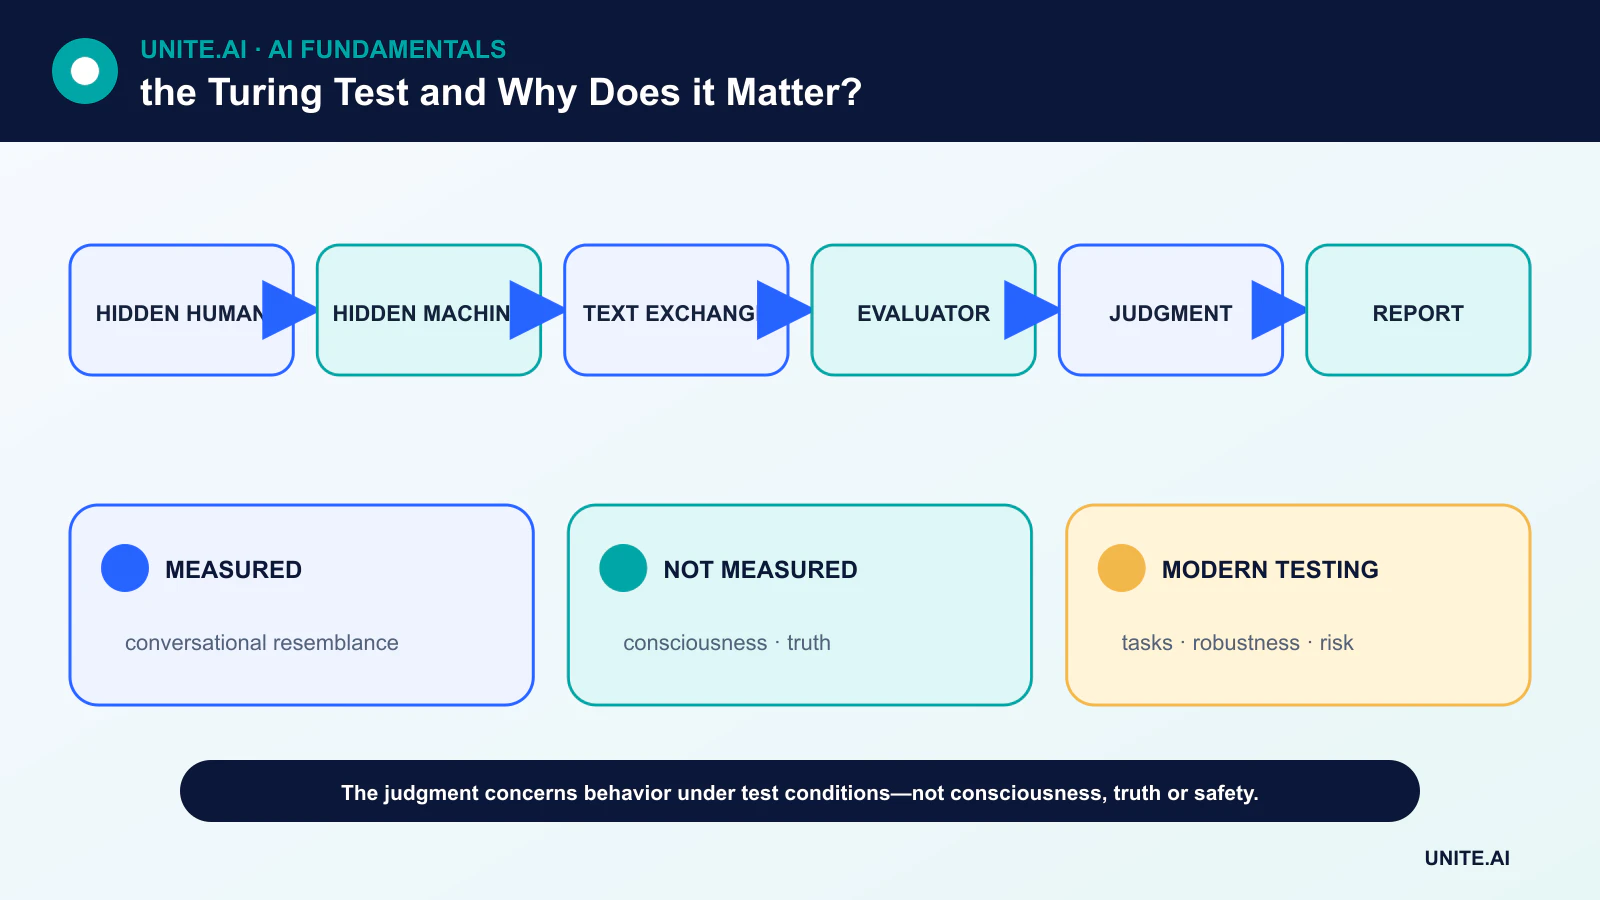
نشأ Turing test من ورقة آلان تورينج عام 1950 بعنوان “Computing Machinery and Intelligence”. بدلاً من محاولة تعريف الفكر، اقترح تورينج لعبة تقليد: محقق بشري يتبادل رسائل مكتوبة مع مشاركين غير مرئيين ويقرر أيهما إنسان وأيها آلة.
لا يزال الاختبار مؤثرًا لأنه يحول سؤالًا فلسفيًا مجردًا إلى تفاعل يمكن ملاحظته. وهو محدود أيضًا: الظهور كإنسان في محادثة لا يعني الصدق أو المعرفة أو الأمان أو الوعي أو الذكاء العام.
النقاط الأساسية
- لعبة التقليد الأصلية لتورينج هي اختبار سلوكي نصي، وليس قائمة تحقق للخصائص الإدراكية الداخلية.
- تعتمد النتائج على المقيم، والتعليمات، والمدة، وتعليمات المشاركين، وقاعدة التقييم.
- يمكن للنموذج أن يقلد الحوار البشري بينما يختلق حقائق أو يفشل في اختبارات الصمود البسيطة.
- يتطلب التقييم الحديث مقاييس مهمة، واختبارات عدائية، ومراجعة بشرية، وأدلة خاصة بالمخاطر إلى جانب الحوار.
لعبة التقليد لتورينج
في الإعداد الأصلي، كان المحقق يتواصل عن بُعد حتى لا تكشف الصوت أو المظهر هوية المشاركين. سأل تورينج ما إذا كان بإمكان آلة أن تؤدي بشكل كافٍ في اللعبة بحيث لا يستطيع المقيم تمييزها عن شخص.
هذا الإطار العملي تجنب الحاجة إلى تحديد تعريف واحد للتفكير. ولم يزعم أن كل تبادل مقنع يثبت الذكاء، ولا حدد عتبة مرور عالمية تنطبق على أي عرض لاحق للدردشة.
ما الذي يقيسه النتيجة فعليًا
يقيس التجربة عدم التمييز السلوكي تحت ظروف محددة. يمكن للمحادثات القصيرة أو القضاة غير المتمرسين أو التعليمات التي يختارها مُطوّر النظام أن تجعل المهمة أسهل. يجب على تقرير دقيق أن يكشف عن اختيار النصوص، وعدد وخلفية القضاة، والبشر المقارنون، والحد الزمني، والطريقة الإحصائية.
قد يستغل النظام التوقعات: يمكن للمراوغة، والفكاهة، والأخطاء المطبعية، والتمثيل الدوراني أن يبدو إنسانيًا دون إظهار استدلال موثوق. وعلى العكس، قد يُصنّف رد إنساني رسمي للغاية على أنه مولّد آلي.
ما لا يحدده اختبار تورينج
لا يقيس الاختبار الوعي، أو التجربة الذاتية، أو الدقة الواقعية، أو الفهم السببي، أو الوكالة الأخلاقية. ولا يكشف عن بيانات التدريب، أو بنية النموذج، أو أنماط الفشل خارج الحوار. كما أنه لا يتناول الذكاء غير اللغوي مثل التلاعب المادي.
أنظمة اللغة الحديثة مبنية على شبكات عصبية تحويلية والتعلم العميق، لكن مخرجاتها الطليقة لا تزال تُنتج من بنية إحصائية مكتسبة بدلاً من نموذج عالمي موثوق.
كيف يوسع تقييم الذكاء الاصطناعي الحديث السؤال
يستخدم التقييم المعاصر مجموعات مهام محجوزة، وضبط عدم اليقين، واختبارات الصمود، والاختبار العدائي، وفحوصات الحقيقة، ودراسات تفضيلات البشر. يمكن لمقياس تصنيف النص أن يختبر سلوكًا محددًا، بينما يمكن للتقييم القائم على السيناريو اختبار ما إذا كان النظام يتبع السياسات تحت الضغط.
لا يُلْتَقَط معيار واحد كل سيناريو نشر. قد تُرفع الدرجات بسبب تلوث الاختبار، وتشجع المعايير الثابتة على الإفراط في التخصيص. يجب تكرار التقييم مع تغير النماذج أو البيانات أو التعليمات أو الأدوات أو جمهور المستخدمين.
لماذا لا يزال الاختبار مهمًا
تنبأ اختبار تورينج بدروس أساسية في تقييم الذكاء الاصطناعي: قياس القدرة القابلة للملاحظة بدلاً من الاعتماد على ادعاءات جوهرية داخلية. كما يجبرنا على سؤال أي سلوكيات بشرية تُعَدّ دليلًا وكيف يشكّل الإعداد التجريبي الاستنتاج.
أفضل استخدام حديث له هو كخط أساس تاريخي ومفهومي. قد يكون اجتياز لعبة التقليد مثيرًا للاهتمام، لكن قرارات النشر تتطلب أدلة مرتبطة بالمهمة الفعلية، والمستخدمين المتأثرين، والأضرار المتوقعة.
ما الذي يقيسه اختبار تورينج
سألت لعبة التقليد لتورينج ما إذا كان المحقق المتواصل عبر النص يستطيع تمييز الآلة عن الإنسان بشكل موثوق. أعادت صياغة النقاش المجرد حول ما إذا كانت الآلات تفكر إلى تجربة محادثة قابلة للملاحظة. يعتمد الاختبار على المشاركين، والمدة، والبروتوكول، والمواضيع، وقاعدة الحكم؛ لا توجد درجة عالمية موحدة. يعني النجاح إنتاج ردود شبيهة بالبشر ضمن ذلك الإعداد. لا يقيس مباشرة الدقة الواقعية، أو الاستدلال، أو الوعي، أو الاستقلالية، أو الإدراك، أو التجسيد، أو الاعتمادية، أو السلوك المفيد في العالم الحقيقي.
يمكن للتقليد البشري أن يكافئ المراوغة، أو الشخصية، أو الأخطاء، أو الفكاهة، أو التلاعب. قد يخطئ القاضي في تصنيف إنسان كآلة أو يتأثر بالتوقعات، واللغة، والسياق الثقافي. تتيح المحادثات القصيرة حيلًا قد تفشل مع تفاعل مستمر. وعلى العكس، قد يفشل نظام مفيد للغاية في الرياضيات أو الترجمة أو نمذجة البروتين لأنه لا يتظاهر بأنه إنسان. لذا يقيس الاختبار قدرة اجتماعية ولغوية تشكلها المقيم، وليس ترتيبًا كاملًا للذكاء.
نماذج اللغة الحديثة وتقييم أقوى
يمكن للنماذج اللغوية الكبيرة الحفاظ على حوار طليق عبر توقع سلاسل من بيانات تدريب واسعة ثم تحسين لاحق، لكن الطلاقة دليل ضعيف على الحقيقة أو الفهم. تؤثر الأنماط المحفوظة، والوصول إلى الأدوات، والتعليم المخفي، والكمون، وإعدادات العينة على النتائج. يجب أن تكشف التقييمات المتحكم فيها عن النموذج والبروتوكول، وتمنع تسريب المعلومات، وتضم أسئلة عدائية ومجالات، وتُقَيِّم عدم اليقين والاستشهاد. لا يمكن لتجربة مختارة من محادثات ناجحة تقدير الاعتمادية عبر توزيع الاستخدام.
التقييم الحديث متعدد الأبعاد: دقة المهمة، والضبط، والصمود، والاتساق على المدى الطويل، والأمان، والتحيز، والخصوصية، والأمن، والكفاءة، ونتائج البشر. يجب أن تُكمَل الاختبارات السلوكية بأدلة عملية، واختبار عدائي، ومعايير قابلة لإعادة الإنتاج، ومراقبة في العالم الحقيقي. قد تشبع المعايير أو تدخل في بيانات التدريب، لذا تُحتاج مجموعات اختبار خاصة ومُحدَّثة. بالنسبة للأنظمة التي تتصرف، يجب تقييم أذونات الأدوات، والاسترداد، والعواقب بصورة منفصلة عن جودة الحوار.
لماذا لا يزال الاختبار مهمًا
يبقى اختبار تورينج مهمًا تاريخيًا لأنه يركز على السلوك وصعوبة تعريف الذكاء. كما يثير أسئلة مستمرة حول التشخيص البشري والخداع. يجب أن تُظهر الواجهات الوكلاء الاصطناعيين بدلاً من اعتبار الخطأ في الهوية نجاحًا، خصوصًا في السياقات ذات العواقب. استخدم الاختبار كعدسة فلسفية وتقييم محادثة واحد، وليس كشهادة على الذكاء العام أو الشخصية. السؤال الأساسي في النشر هو ما يستطيع النظام القيام به بشكل موثوق، تحت أي أدلة وحدود، ومن يتحمل المسؤولية عند الفشل.
مثال عملي: تقييم محادثة مُتحكم فيه
يقارن المقيمون بين البشر وعدة أنظمة ذكاء اصطناعي في محادثات نصية ذات مدة ثابتة، ومواضيع، ولغة، وهوية مخفية. يسجل القضاة ما إذا كانوا يعتقدون أن كل مشارك إنسان، كما يقيمون الدقة، والاتساق، والفائدة، وعدم اليقين، والتلاعب. يقدّر تعدد القضاة والمحادثات التباين، ويمنع البروتوكول مطوري النموذج من اختيار نصوص مواتية. يوفر تصنيف البشر خطًا أساسيًا لتفسير النتيجة.
النظام الذي يخدع القضاة لكنه يختلق حقائق لا يُعلن عنه كذكي عام، بينما قد يكون نموذج متخصص موضح بوضوح مفيدًا للغاية رغم فشله في التقليد. تشمل النتائج التعليمات، والنموذج، وعينة الاختبار، والوصول إلى الأدوات، وخصائص القاضي. تُصاغ التجربة كاختبار واحد للمحادثة الشبيهة بالبشر. تستخدم قرارات النشر أدلة منفصلة لصحة المهمة، والأمان، والخصوصية، والاسترداد، وتُظهر الواجهة هوية الوكيل بدلاً من تحويل الخداع إلى هدف المنتج.
دليل التنفيذ والاستعداد التشغيلي
يتطلب قرار الإنتاج أكثر من عرض ناجح. حدد المستخدمين المستهدفين، وبيئة التشغيل، والمدخلات، والمخرجات، والاعتمادات، والمالك، وعواقب كل فشل مهم. أنشئ خط أساس قابل لإعادة الإنتاج ومجموعة تقييم مُصدَّرة قبل الضبط. اختبر الحالات العادية، وظروف الحد، والمدخلات المشوهة أو المفقودة، وتحول التوزيع، وتعطل الاعتمادات، وسوء الاستخدام، والمجموعات أو البيئات الأكثر احتمالًا لتكون غير مخدومة. قِس جودة المهمة مع الضبط أو عدم اليقين، والكمون، ومعدل النقل، وتكلفة الموارد، وإمكانية الوصول، والخصوصية، والأمان. سجِّل كل تحويل وعَتَبَة حتى يتمكن مراجع مستقل من إعادة إنتاج النتيجة وتمييز الأدلة عن نموذج أولي جذاب.
قبل الإطلاق، عيّن سلطة للإصدار، والاستثناءات، والتغييرات، والعودة، والتقاعد. استخدم نشرًا متدرجًا، واحفظ نسخة احتياطية آمنة، وتحقق من المراقبة عبر إدخال فشل متعمد. يجب أن تكشف بيانات التشغيل عن جودة المدخلات، وسلوك المخرجات، وإصدار النموذج أو القاعدة، وصحة الاعتمادات، وتدخلات البشر، والنتائج المؤكدة دون جمع بيانات حساسة غير ضرورية. عيّن عتبات تنبيه ومسؤول استجابة، ثم راجع الأدلة الواقعية بعد النشر بدلًا من افتراض استمرارية الأداء غير المتصل. أعد التقييم كلما تغيرت مصادر البيانات أو المستخدمون أو النماذج أو البائعون أو السياسات أو الأجهزة أو الأهداف. يحتاج النظام المُحافظ أيضًا إلى وثائق استرداد، وتعلم من الحوادث، وإجراءات حذف واحتفاظ، ونقطة واضحة يجب فيها تعطيله أو استبداله.
الأسئلة المتكررة
هل نجح أي ذكاء اصطناعي بشكل قاطع في اختبار تورينج؟
لا توجد سلطة اختبار رسمية واحدة أو بروتوكول مقبول عالميًا. تستخدم العروض العامة قواعد مختلفة، لذا فإن ادعاءات “النجاح” غير قابلة للمقارنة مباشرة.
هل فشل الاختبار يثبت أن النظام غير ذكي؟
لا. يمكن لنظام متخصص أن يكون عالي القدرة دون أن يقلد أسلوب المحادثة البشرية.
المراجع الأساسية












