
نماذج ومنصات الذكاء الاصطناعي
Mistral 7B: معايير جديدة تتجاوز Llama 2 في مجال النماذج المفتوحة المصدر

 أضف Unite.AI إلى مصادرك المفضلة على Google

النقاط الرئيسيةنموذج ميسترال الذكاء الاصطناعي سعة 7 مليار معامل يتفوق على نموذج لاما 2 سعة 13 مليار…
عرض المزيد
- نموذج ميسترال الذكاء الاصطناعي سعة 7 مليار معامل يتفوق على نموذج لاما 2 سعة 13 مليار معامل في جميع المعايير القياسية مع كفاءة حوسبية أعلى.
- يستخدم النموذج آلية الانتباه الاستعلامي المجمع لتحقيق التوازن بين السرعة والجودة، وهو ابتكار تقني رئيسي.
- تقدم ترخيصه تحت رخصة أباتشي 2.0 مرونة نشر غير مسبوقة لأي مستخدم دون عوائق تقييدية.
أصبحت نماذج اللغة الكبيرة (LLMs) حديث الساعة مؤخرًا، بفضل أداء بعض النماذج مثل ChatGPT. عندما قدمت Meta نماذج Llama، أثار ذلك اهتمامًا جديدًا بنماذج اللغة المفتوحة المصدر. الهدف هو إنشاء نماذج اللغة المفتوحة المصدر بأسعار معقولة، والتي تكون جيدة مثل النماذج الرائدة مثل GPT-4، ولكن بدون التكلفة العالية أو التعقيد.
هذا المزيج من التكلفة والكفاءة لا يفتح فقط طرقًا جديدة للباحثين والمطورين، بل يضع أيضًا الأساس لحقبة جديدة من التطورات التكنولوجية في معالجة اللغة الطبيعية.
استقطبت الشركات الناشئة في الذكاء الاصطناعي التوليدي تمويلًا كبيرًا مؤخرًا. فقد جمعت Together مبلغ 20 مليون دولار لتطوير الذكاء الاصطناعي المفتوح المصدر، وجمعت Anthropic مبلغ 450 مليون دولار. كما حصلت Cohere على 270 مليون دولار في يونيو 2023، بالتعاون مع Google Cloud.
مقدمة إلى Mistral 7B: الحجم والتوافر

أعلنت Mistral AI، التي تتخذ من باريس مقرًا لها وشارك في تأسيسها موظفون سابقون في DeepMind التابعة لـGoogle وMeta، عن أول نموذج لغوي كبير لها: Mistral 7B. يمكن تحميل هذا النموذج بسهولة من قبل أي شخص من GitHub ومن خلال تورنت بحجم 13.4 غيغابايت.
استطاعت هذه الشركة الحصول على تمويل تأسيسي قياسي قبل إطلاق منتجاتها. يتفوق نموذج Mistral 7B، الذي يحتوي على 7 مليارات معلمة، على Llama 2 13B في جميع الاختبارات، ويتفوق على نموذج Llama 1 34B في العديد من المعايير.
مقارنةً بنماذج مثل Llama 2، يقدم Mistral 7B قدرات مماثلة أو أفضل مع عبء حسابي أقل. وقد تحقق النماذج الأساسية مثل GPT-4 قدرات أكبر، لكنها أعلى تكلفة وأقل سهولة في الاستخدام لأن الوصول إليها يتم غالبًا عبر واجهات برمجة التطبيقات.
بالنسبة إلى المهام البرمجية، يمنح Mistral 7B فرصة قوية لمنافسة CodeLlama 7B. بالإضافة إلى ذلك، يتميز Mistral 7B بحجم صغير نسبيًا، حيث يبلغ 13.4 غيغابايت، مما يسمح بتشغيله على أجهزة معيارية.
كما أظهر Mistral 7B Instruct أداءً جيدًا، حيث تم تحسينه بشكل خاص لبيانات تعليمات على Hugging Face. يتفوق على نماذج أخرى بحجم 7B في اختبار MT-Bench، ويتساوي مع نماذج الدردشة بحجم 13B.

Hugging Face Mistral 7B — مثال
اختبار الأداء
في تحليل أداء مفصل، تم قياس Mistral 7B مقابل نماذج Llama 2. كانت النتائج واضحة: يتفوق Mistral 7B بشكل كبير على Llama 2 13B في جميع الاختبارات. كما يتساوي مع أداء Llama 34B، خاصة في اختبارات البرمجة والاستدلال.
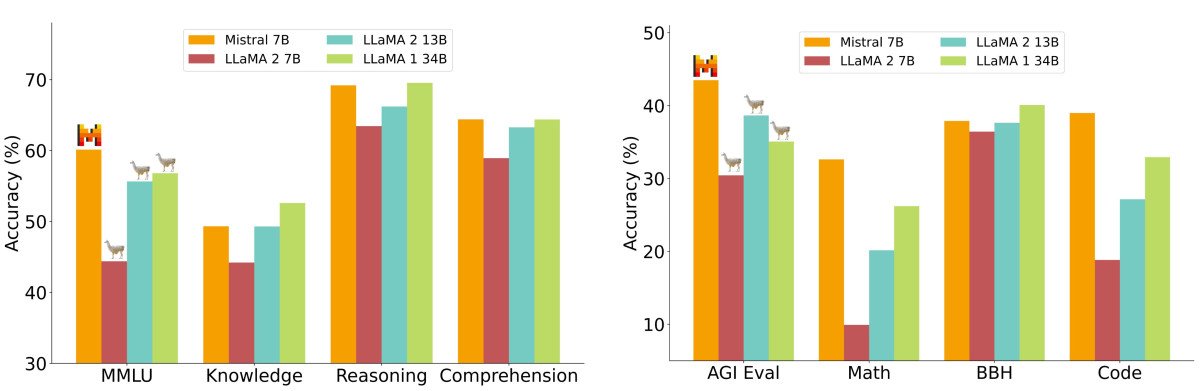
تم تنظيم الاختبارات في فئات متعددة، مثل الاستدلال بالحس السليم، والمعرفة العالمية، وفهم المقروء، والرياضيات، والبرمجة، وغيرها. كان أحد الملاحظات البارزة هو معيار التكلفة والأداء لشركة Mistral 7B، والذي يُسمى “حجم النموذج المكافئ”. في مجالات مثل الاستدلال والفهم، أظهر Mistral 7B أداءً مشابهًا لنموذج Llama 2 ثلاث مرات حجمه، مما يشير إلى توفيرات محتملة في الذاكرة وزيادة في الإنتاجية. ومع ذلك، في اختبارات المعرفة، كان Mistral 7B متساويًا مع Llama 2 13B، وهو ما يُعزى على الأرجح إلى قيود المعلمات التي تؤثر على ضغط المعرفة.
ما الذي يجعل نموذج Mistral 7B أفضل من معظم نماذج اللغة الأخرى؟
تسهيل آليات الانتباه
على الرغم من أن دقائق آليات الانتباه هي تقنية، فإن الفكرة الأساسية هي بسيطة نسبيًا. تخيل أنك تقرأ كتابًا وتبرز جمل مهمة؛ هذا مشابه لطريقة عمل آليات الانتباه في إعطاء أهمية لنقاط البيانات في التسلسل.
في سياق نماذج اللغة، تمكن هذه الآليات النموذج من التركيز على أجزاء البيانات الأكثر صلة، مما يضمن أن تكون المخرجات متسقة ودقيقة سياقيًا.
في المحولات القياسية، يتم حساب درجات الانتباه باستخدام الصيغة:

صيغة الانتباه في المحولات
تتضمن صيغة هذه الدرجات خطوة حاسمة – ضرب المصفوفتين Q وK. التحدي هنا هو أن مع نمو طول التسلسل، تتوسع كلا المصفوفتين بشكل متناسب، مما يؤدي إلى عملية حسابية مكثفة. هذا القلق من حيث القابلية للتوسيع هو أحد الأسباب الرئيسية التي تجعل المحولات القياسية بطيئة، خاصة عند التعامل مع تسلسلات طويلة.

تسرع الانتباه متعدد الاستعلامات (MQA) الأمور عن طريق استخدام مجموعة واحدة من “رؤوس المفاتيح والقيم”، ولكنها في بعض الأحيان تضحي بالجودة. الآن، قد تتساءل، لماذا لا تجمع بين سرعة MQA وجودة الانتباه المتعدد الرؤوس؟ هذا هو المكان الذي تأتي فيه آليات الانتباه المجمعة (GQA).
آليات الانتباه المجمعة (GQA)

الانتباه بالاستعلامات المجمّعة
تعتبر GQA حلًا وسطًا. بدلاً من استخدام رأس واحد أو عدة رؤوس للمفاتيح والقيم، يتم تجميعها. بهذه الطريقة، تحقق GQA أداءً قريبًا من الانتباه المتعدد الرؤوس، ولكن بسرعة MQA. بالنسبة لنماذج مثل Mistral، يعني هذا الأداء الفعال بدون التضحية الكبيرة بالجودة.
آليات الانتباه بالنافذة المتحركة (SWA)

تُستخدم طريقة النافذة المنزلقة في معالجة تسلسلات الانتباه. هذه الطريقة تستخدم نافذة انتباه ثابتة الحجم حول كل رمز في التسلسل. مع تكرار هذه النافذة في طبقات متعددة، تكتسب الطبقات العليا في النهاية منظورًا أوسع، مما يشمل المعلومات من كامل المدخلات. هذه الآلية مشابهة لحقول الاستقبال في الشبكات العصبية الالتفافية (CNNs).
من ناحية أخرى، تستخدم طريقة “النافذة المتحركة الممددة” في نموذج Longformer، والتي تشبه من الناحية المفاهيمية طريقة النافذة المتحركة، حساب بعض الأقطار فقط من المصفوفة . يؤدي هذا التغيير إلى زيادة استخدام الذاكرة بشكل خطي بدلاً من التربيعي، مما يجعلها طريقة أكثر كفاءة لتسلسلات أطول.
شفافية Mistral AI مقابل مخاوف الأمان في اللامركزية
في إعلانها، شددت Mistral AI على الشفافية بالبيان: “لا خدع، لا بيانات مملوكة”. ومع ذلك، النموذج المتاح حاليًا هو Mistral-7B-v0.1، وهو نموذج قاعدي مسبق التدريب، ويمكنه توليد استجابة لأي استفسار دون إشراف على المحتوى، مما يثير مخاوف أمان محتملة. بينما تملك نماذج مثل GPT و Llama آليات للتمييز عند الاستجابة، قد يُستغل الطبيعة اللامركزية الكاملة لنماذج اللغة الكبيرة من قبل الأفراد الضارين.
ومع ذلك، للتحول اللامركزي في النماذج اللغوية الكبيرة مزايا. بينما قد يسيء بعض الأفراد استخدامها، يمكن للأفراد استخدامها من أجل الخير الاجتماعي وجعل الذكاء متاحًا للجميع.
مرونة النشر
تتميز Mistral 7B بأنها متاحة تحت رخصة Apache 2.0. هذا يعني أنه لا توجد عوائق حقيقية لاستخدامها – سواء كنت تستخدمها لأغراض شخصية أو شركة كبيرة أو حتى كيان حكومي. كل ما تحتاجه هو نظام مناسب لتشغيلها، أو قد تحتاج إلى استثمار في الموارد السحابية.
توجد رخص أخرى، مثل رخصة MIT البسيطة و رخصة CC BY-SA-4.0 التعاونية، التي تتطلب نسب العمل إلى صاحبه وترخيص الأعمال المشتقة بشروط مماثلة، توفر رخصة Apache 2.0 أساسًا قويًا للمشاريع الكبيرة.
أفكار ختامية
يرمز صعود نماذج اللغة الكبيرة المفتوحة المصدر مثل Mistral 7B إلى تحول حاسم في صناعة الذكاء الاصطناعي، مما يجعل نماذج اللغة عالية الجودة متاحة لفئة أوسع. تَعِد مناهج Mistral AI المبتكرة، مثل الانتباه المجمّع وآليات الانتباه بالنافذة المتحركة، بتقديم أداء فعال دون المساس بالجودة.
في حين أن الطبيعة المفتوحة لنماذج اللغة مثل Mistral تطرح تحديات معينة، فإن مرونتها وترخيصها المفتوح يؤكدان على إمكانات إتاحة الذكاء الاصطناعي للجميع. مع تطور المشهد، سيكون التركيز في النهاية على موازنة قوة هذه النماذج مع الاعتبارات الأخلاقية وآليات الأمان.
ماذا يأتي بعد ذلك لمستقبل Mistral؟ كان نموذج 7B فقط البداية. يهدف الفريق إلى إطلاق نماذج أكبر قريبًا. إذا كانت هذه النماذج الجديدة تتوافق مع أداء 7B، قد يصعد Mistral بسرعة إلى مرتبة لاعب رائد في الصناعة، كل ذلك في أول عام لها.


