
مقابلات
مارلوس سي. ماتشادو، أستاذ غير متفرغ في جامعة ألبرتا، وزميل Amii وصاحب كرسي أبحاث الذكاء الاصطناعي في CIFAR – سلسلة المقابلات

 أضف Unite.AI إلى مصادرك المفضلة على Google
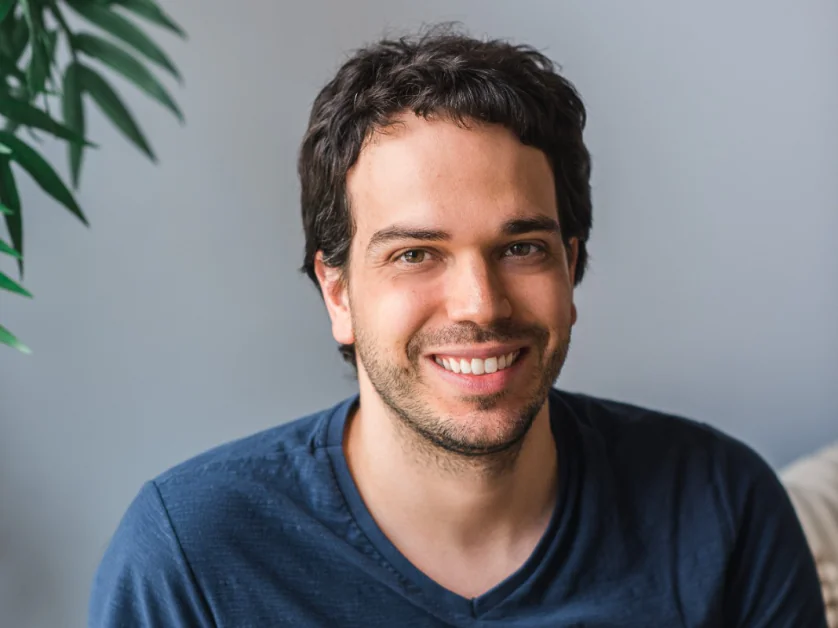
مارلوس سي. ماتشادو باحث مقيم في معهد ألبرتا للذكاء الآلي (Amii)، وأستاذ غير متفرغ في جامعة ألبرتا، وزميل في Amii حيث يشغل أيضًا كرسي أبحاث Canada CIFAR AI. تركز أبحاثه أساسًا على التعلم بالتعزيز. حصل على البكالوريوس والماجستير من UFMG في البرازيل والدكتوراه من جامعة ألبرتا، حيث نشر فكرة الاستكشاف الممتد زمنيًا عبر ما يسمى «الخيارات» (options).
عمل باحثًا في DeepMind بين 2021 و2023 وفي Google (GOOGL ) Brain بين 2019 و2021. قدم إسهامات مهمة في التعلم بالتعزيز، خصوصًا تطبيق التعلم العميق بالتعزيز للتحكم في بالونات Loon في طبقة الستراتوسفير. نُشرت أعماله في دوريات ومؤتمرات رائدة مثل Nature وJMLR وJAIR وNeurIPS وICML وICLR وAAAI، وعرضتها أيضًا BBC وBloomberg TV وThe Verge وWired.
أجرينا المقابلة في مؤتمر الذكاء الاصطناعي السنوي Upper Bound لعام 2023 في إدمونتون بألبرتا، الذي ينظمه Amii ، معهد ألبرتا للذكاء الآلي.
تركز على التعلم بالتعزيز. ما الذي يجذبك إلى هذا النوع من التعلم الآلي؟
أحب فكرة التعلم بالتفاعل. أراها طريقة طبيعية جدًا، وتشبه من بعض النواحي تعلم البشر. لا أحب إضفاء صفات بشرية على الذكاء الاصطناعي، لكن بصورة حدسية، تجرب أشياء، فتكون بعض النتائج جيدة وأخرى سيئة، وتتعلم فعل ما يؤدي إلى نتائج أفضل. ما يبهرني هو أن الوكيل يتفاعل فعلًا مع العالم، ويمكنه طرح فرضية واختبارها.
هذا يتيح اكتشاف سلوك جديد. المثال الشهير هو النقلة 37 لـAlphaGo التي يصفها الوثائقي بالإبداع. لم يسبق أن شوهدت وأدهشتنا جميعًا. لم تكن موجودة في مادة جاهزة، بل اكتُشفت بالتفاعل. رأينا شيئًا مماثلًا في مشروعي للتحليق ببالونات في الستراتوسفير.
ظهرت سلوكيات لم نفكر فيها لكنها عبقرية. التعلم بالتعزيز مناسب خصوصًا لهذه الاكتشافات لأنه تفاعلي. أحد الأسئلة الصعبة هو الافتراض البديل: ماذا لو فعلت شيئًا آخر؟ في كثير من سياقات أبحاث التعلم الآلي لا يمكنك اختبار ذلك. أما هنا فتستطيع تجربة البديل في المرة التالية التي تواجه فيها الموقف. أحب هذا الجانب التفاعلي.
وطبعًا لا أنكر جاذبية التطبيقات المثيرة. حتى النجاحات الأولى الكبيرة قبل عقود جعلت المجال جذابًا بالنسبة إلي.
ما التطبيق المبكر المفضل لديك؟
هناك مثالان مشهوران: المروحية التي تحكم فيها Stanford بالتعلم بالتعزيز، وبرنامج الطاولة TD-Gammon الذي أصبح بطلًا عالميًا في التسعينيات. خلال الدكتوراه حرصت على التدريب في IBM مع جيرالد تيساورو، الذي قاد TD-Gammon. كان ذلك رائعًا.
المضحك أنني في البداية لم أكن أفهم تمامًا ما هو التعلم بالتعزيز. عند التقدم للدراسات العليا، أردت التعلم الآلي بصورة عامة. قرأت أوصاف أبحاث أساتذة كثيرين على مواقعهم ووجدت بعضها مثيرًا. بأثر رجعي، ودون معرفة المجال، اخترت أساتذته المشهورين، لا لشهرتهم بل لأن وصف أبحاثهم جذبني. كنت أرى موقعًا جيدًا فأرغب في العمل مع صاحبه.
أي أنك اكتشفتهم بصورة طبيعية.
بالضبط. عندما أنظر إلى الماضي أجدهم الأشخاص الذين طلبت العمل معهم منذ زمن. وحتى قبل أن أعرف ما سأفعله، كنت أقرأ أوصاف أبحاث أخرى داخل المقالات وأقول إن علي قراءتها. كان الاهتمام يعيدني باستمرار إلى التعلم بالتعزيز.
في Google Brain عملت على الملاحة الذاتية للبالونات الستراتوسفيرية. لماذا ناسبت توفير الإنترنت للمناطق صعبة الوصول؟
لست خبيرًا في هذا الجانب؛ كانت فكرة Loon، التابعة لـAlphabet (GOOG ). عادة تبني هوائيًا، مثلًا في إدمونتون، يغطي دائرة نصف قطرها خمسة أو ستة كيلومترات. في وسط نيويورك قد يخدم ملايين الأشخاص. لكن لقبيلة ربما تضم 50 شخصًا في غابة الأمازون، يصعب تبرير التكلفة، فضلًا عن صعوبة الوصول.
لا يجدي اقتصاديًا استثمار ضخم في البنية التحتية بمنطقة نائية قليلة السكان. الفكرة كانت: ماذا لو كان الهوائي مرتفعًا جدًا، مثل 20 كيلومترًا؟ لا نعرف بناءه، لكن يمكن وضع بالون هناك. إذا تضاعف نصف القطر عشر مرات، تزيد المساحة مئة مرة. بالون وسط الغابة قد يخدم قبائل عدة تحتاج كل منها هوائيًا منفصلًا.
كان هذا أحد الدوافع. أتذكر أن شعار Loon لم يكن الإنترنت للمليار التالي، بل للمليار الأخير من البشر، الأصعب وصولًا. كان طموحًا جدًا.
ما مشكلات الملاحة التي حاولتم حلها؟
ليس للبالونات دفع ذاتي. تبحر كالبالونات الهوائية الساخنة: تصعد أو تهبط لتجد تيارًا في الاتجاه المطلوب ثم تتبعه. لتغيير الاتجاه تنتقل إلى ارتفاع آخر بحثًا عن ريح أخرى. لكنها ليست بالونات هواء ساخن، بل ذات حجم ثابت تطير في الستراتوسفير.
من منظور الملاحة لا يمكنها إلا الصعود أو الهبوط أو الثبات في الارتفاع، ثم إيجاد الرياح المناسبة. التحديات كثيرة. تريد البقاء بمنطقة خدمة الإنترنت والحفاظ أيضًا على الطاقة التي تنتجها الألواح الشمسية. إنها مسألة تحسين متعددة الأهداف: الموقع المناسب وكفاءة الطاقة.
تعرف الرياح عند موقعك، لكن لا تعرفها على ارتفاع 500 متر فوقك. هذه قابلية رصد جزئية. توجد توقعات، لكن اتجاه الرياح قد يخطئ حتى 90 درجة. المشكلة عالية الأبعاد: مئات طبقات الرياح وسرعتها واتجاهها ونمذجتها والثقة في التوقع وعدم اليقين.
يصعب استيعابها وحتى توضيح مدى صعوبتها. لا ترى كل الأبعاد على الشاشة. عليك مراعاة الرياح وتوقيت آخر قياس والطاقة والوقت من اليوم والموقع المطلوب معًا. إنها عوامل كثيرة.
ماذا يدرس نظام التعلم الآلي؟ أنماط الرياح والحرارة فقط؟
كان لدينا نموذج رياح بالتعلم الآلي، لكنه لم يكن تعلمًا بالتعزيز. بنت Loon النموذج من بيانات تاريخية لارتفاعات مختلفة قبل مشاركة Google Brain. لم أشارك شخصيًا في ذلك الجزء. وكان عليه أيضًا استيفاء القيم بين الارتفاعات.
قد تعرف الريح قبل عامين عند ارتفاع معين، لكن لا تعرفها أعلى بعشرة أمتار. أضيفت عملية غاوسية، ونُشرت أبحاث عن جودة النمذجة. من منظور التعلم بالتعزيز، كان لدينا محاكي جيد لديناميكا البالون ومحاكي الرياح هذا. كنا نفترض أننا في 2010. لدينا بيانات عالمية تقريبية لذلك العام، ونضيف النموذج والعملية الغاوسية لاستكمال قيم الرياح، ثم يمكن إدخال ضوضاء وتغييرات أخرى.
ديناميكا البالون والرياح وافتراض العودة إلى الماضي وفرت لنا محاكيًا.
كأنه توأم رقمي في الماضي.
بالضبط. صممنا دالة مكافأة للبقاء قرب الهدف مع قدر من كفاءة الطاقة. تعلم البالون بالتفاعل مع هذا العالم. أمكن ذلك باستخدام الماضي، لأننا لا نعرف نمذجة الطقس والرياح بالكامل بطريقة أخرى. فتعلمنا الملاحة: أصعد أم أهبط أم أبقى؟ بالنظر إلى كل ما حولي، الهدف النهائي هو توفير الإنترنت للمنطقة.
ما تحديات تطبيق التعلم بالتعزيز في الواقع مقارنة بالألعاب؟
هناك تحديات عدة. الفرق ليس بالضرورة بين الألعاب والواقع، بل بين البحث الأساسي والتطبيقي. يمكن إجراء بحث تطبيقي للعبة ستصل إلى ملايين المستخدمين أيضًا. من أهم التحديات الهندسة. نستخدم الألعاب لأنها تتضمن خصائص تهمنا ضمن قيود أوضح، فنبحث ونتحقق من التعلم في بيئة محدودة نفهمها أفضل.
ليس ضروريًا أن تختلف الأبحاث جذريًا، لكن الواقع يضيف تحديات مثل السلامة. كان علينا ضمان ألا يفعل البالون شيئًا أحمق، وألا يتعلم الوكيل سلوكًا غير متوقع له عواقب سيئة. كان ذلك من أكبر مخاوفنا. في اللعبة تكون أسوأ نتيجة عادة الخسارة.
وهناك المنظومة التقنية للمنتج كله. كباحث منفرد، يسهل التجريب في لعبة. أما المنتج فلا يسمح لك بفعل ما تشاء؛ يجب فهم بقية النظام. يختلف حجم الفريق أيضًا. ضمت Loon عشرات وربما مئات الأشخاص. تعاملنا مع عدد قليل، لكن كانت هناك غرفة تحكم تتواصل مع العاملين في الطيران.
إذن توجد أطراف أكثر. وبجانب الهندسة والسلامة، لا تصح كثير من افتراضات الخوارزميات في الواقع وعليك معالجة ذلك. العالم أقل تساهلًا من لعبة محدودة للغاية.
أحب هذا المثال: أخذنا المعطيات وعملنا أسبوعًا أو أسبوعين ثم عدنا لمهندسي Loon نقول إننا حللنا المشكلة بدقة 100%. ابتسموا بشك وقالوا إنه مستحيل، لأن الرياح اللازمة لا توجد أحيانًا.
اكتشفنا أن الخوارزمية تعلمت نقل البالون إلى مركز المنطقة ثم الصعود حتى ينفجر. يسقط ويظل داخل المنطقة إلى الأبد. بالتأكيد ليس هذا المطلوب. حدث ذلك بالمحاكاة؛ وكان أحد التصحيحات منع البالون من تجاوز الارتفاع الذي ينفجر عنده.
يسهل إغفال هذه القيود والتفاعلات الحقيقية حين تعمل في الألعاب فقط. في الواقع للأفعال عواقب يجب إدراكها. هذا من أهم الصعوبات.
كما أن دورات التجارب أطول كثيرًا. في اللعبة أضغط التشغيل وأحصل على نتائج خلال أسبوع في أسوأ الأحوال. لكن اختبار البالونات في الستراتوسفير كان ما أسميه «اختبار A/B للستراتوسفير». بعد الوثوق بالحل، نحتاج إلى إثبات تفوقه إحصائيًا. أظن أننا طيرنا 13 بالونًا فوق المحيط الهادئ أكثر من شهر للتحقق. هذا المدى الزمني يعطي فرصًا أقل للتجريب.
بخلاف الألعاب، لا يمكن تشغيل مليون نسخة من التجربة نفسها بالتوازي.
نعم. في التدريب استخدمنا المحاكاة، رغم أنها أبطأ بكثير من الألعاب، وعالجنا ذلك هندسيًا. الوضع مختلف في العالم الحقيقي.
ما أبحاثك الحالية؟
أنا في جامعة ألبرتا ولدي مجموعة بحثية فيها طلاب كثيرون، يتيحون لي تنويع أبحاثي. ما يثير حماسي خصوصًا هو التعلم المستمر. عادة نحسب باستخدام محاكي أو بيانات وندرب نموذجًا وننشره ونأمل أن يعمل جيدًا. كثيرًا ما يكون ذلك مناسبًا تمامًا. لكن أحيانًا يكون العالم أعقد من أن يستوعب أي نموذج كل تفاصيله مهما كبر، وعندها يجب التكيف.
أحد مشاريعنا في محطة معالجة مياه. كيف تدعم خوارزميات التعلم بالتعزيز قرارات البشر أو تتحكم ذاتيًا بالمعالجة؟ لدينا بيانات، لكن جودة المياه قد تتغير خلال ساعات. حتى إن دربت يوميًا على بيانات الأمس، فقد يصبح النموذج غير صالح بعد ساعات لأن توزيع البيانات يتغير وليس ثابتًا. ربما يوجد حريق غابات في أعلى المجرى أو يبدأ ذوبان الثلج. لاستيعاب كل شيء يجب نمذجة العالم بأسره.
لا أحد يفعل ذلك، ولا البشر. نتكيف ونتعلم عندما لا تعود الطريقة القديمة تعمل. تطبيقات حقيقية كثيرة تحتاج إلى تعلم دائم، لكننا غالبًا نتخيل حسابًا كبيرًا ثم نموذجًا منشورًا ونموذجًا جديدًا بعد أيام أو أسابيع. لا تناسب هذه المدة كل مشكلة.
السؤال هو كيف نتعلم بلا توقف ونتحسن ونتكيف؟ إنه صعب جدًا. لدينا أبحاث فيه، والأساليب الحالية لا تكفي. حتى أفضل الحلول تتدهور سريعًا إن واصلت التعلم بدل إيقاف التدريب ونشر نموذج ثابت. بعد نجاحات النماذج الثابتة، التي سنواصل استخدامها، يمثل التعلم المستمر إحدى جبهات البحث.
التعلم بالتعزيز مناسب لأن خوارزميات كثيرة تعالج البيانات عند وصولها. لذلك تلائم التعلم المستمر طبيعيًا، دون أن يعني أنها تفعله بالفعل أو تجيده. توجد أسئلة بحثية مثيرة كثيرة.
ما التطبيقات المستقبلية للتعلم المستمر التي تثير حماسك أكثر؟
هذا سؤال المليار دولار لأنني أبحث عن تلك التطبيقات. طرح الأسئلة الصحيحة أكثر من نصف العمل البحثي. أحب أن تقودني المشكلات: لدينا مثلًا خمسة بالونات في الستراتوسفير، كيف نحل الأمر؟ وفي الطريق نحقق تقدمًا علميًا. أعمل مع آدم وايت ومارثا وايت في مشروع معالجة المياه الذي يقودانه. يثير حماسي لأن المشكلة صعبة حتى في وصفها بالكلمات؛ لا تنطبق عليها بسهولة نجاحات تقنيات اللغة الحالية.
تتغير عكارة المياه وحرارتها كثيرًا وعلى فترات زمنية مختلفة، فلا مفر من التعلم المستمر. أثره الاجتماعي ضخم: يصعب تصور شيء أهم من توفير مياه الشرب. في مناطق قليلة السكان مثل شمال كندا قد لا يوجد حتى مشغل للمحطة. ليس الهدف بالضرورة استبداله، بل تمكين ما لا نستطيع فعله بسبب نقص الموظفين أو القدرة.
إنه تحد بحثي صعب جدًا ذو أثر اجتماعي محتمل كبير. ليس لدينا محاكي ولا موارد للحصول عليه، فيجب استخدام البيانات بأفضل شكل والتعلم مع وصولها. مجال آخر لم أعمل فيه كثيرًا هو تبريد المباني، ويرتبط بالطقس وتغير المناخ. كيف نقرر التبريد؟ هنا اليوم مئات الأشخاص، بخلاف الأسبوع الماضي. هل نستخدم السياسة نفسها؟ غالبًا لدينا منظم حرارة فقط. يمكننا التكيف بذكاء أكبر، بما في ذلك اختلاف أعداد الناس بين الغرف.
هناك فرص كثيرة لتحسين الأساليب الحالية في أنظمة التحكم عالية الأبعاد التي يصعب استيعابها ذهنيًا.
في بعض الأماكن يأتي ما يصل إلى 75% من استهلاك الكهرباء من المكيفات، لذا فهذا منطقي جدًا.
بالضبط. توجد بالفعل منتجات منزلية تستخدم التعلم الآلي وتتعلم من العملاء. ويمكن اتباع نهج أدق في المباني الكبيرة. فلوريدا والبرازيل وأماكن كثيرة تحتاج ذلك. تبريد مراكز البيانات مثال آخر بدأت بعض الشركات العمل عليه. يبدو كخيال علمي تقريبًا، لكن التعلم والتكيف المستمرين حسب الحاجة قد يؤثران كثيرًا في مسائل التحكم عالية الأبعاد.
كما أظهرنا في مشروع البالونات، يمكن للتعلم بالتعزيز، خصوصًا العميق، تعلم قرارات من الحساسات أعقد بكثير مما يصممه البشر. قد يختار الإنسان منحنى استجابة خطيًا أو تربيعيًا، لكن الشبكة العصبية تتعلم العلاقات غير الخطية كلها وتعطي قرارات أدق وأحيانًا فعالة جدًا.
شكرًا على المقابلة الرائعة. يمكن لمن يريد المزيد زيارة الموارد التالية:


