
نماذج ومنصات الذكاء الاصطناعي
LoRA وQLoRA وQA-LoRA: تكييف كفؤ للنماذج اللغوية الكبيرة بتحليل المصفوفات منخفض الرتبة

 أضف Unite.AI إلى مصادرك المفضلة على Google

النقاط الرئيسيةتقلل لورا المعلمات القابلة للتدريب عن طريق تجميد الأوزان الأساسية وإضافة مصفوفات صغيرة…
عرض المزيد
- تقلل لورا المعلمات القابلة للتدريب عن طريق تجميد الأوزان الأساسية وإضافة مصفوفات صغيرة قابلة للتكيف.
- تدمج كيو-لورا تقنية التكميم 4-بت مع لورا لتقليل متطلبات ذاكرة وحدة معالجة الرسومات بشكل كبير.
- تجعل هذه الطرق ضبط النماذج ذات المليارات من المعلمات ممكناً على الأجهزة القياسية.
النماذج اللغوية الكبيرة (LLM) قد حظيت بمكانة فريدة في فهم اللغة البشرية وتوليد النصوص الشبيهة باللغة البشرية. يمكن إرجاع قوة النماذج اللغوية الكبيرة إلى حجمها الهائل، حيث غالباً ما تحتوي على مليارات المعلمات. ومع ذلك، فإن هذا الحجم الهائل يؤدي إلى تحديات، خاصة عند تعديل النموذج للمهام أو المجالات المحددة. الطرق التقليدية لإدارة النماذج اللغوية الكبيرة، مثل تعديل جميع المعلمات، تفرض كلفة حسابية ومالية كبيرة تعوق استخدامها الواسع في التطبيقات الواقعية.
في مقال سابق، قد تناولنا تعديل النماذج اللغوية الكبيرة لتلائم المتطلبات المحددة. وقد استكشفنا مختلف أساليب التعديل، مثل التعديل القائم على الإرشادات، التعديل الفردي للمهام، والتعديل الكفء للمعلمات (PEFT). كان التركيز الرئيسي على هيكل Transformer، الذي يُعتبر العمود الفقري للنماذج اللغة الكبيرة، والتحديات التي تطرحها الحوسبة والتخزين.

https://huggingface.co/blog/hf-bitsandbytes-integration
الصوره السابقة تمثل حجم النماذج اللغوية الكبيرة المختلفة، مرتبة حسب عدد المعلمات. ومن الجدير بالذكر أن PaLM و BLOOM هما من بين النماذج اللغوية الكبيرة.
في هذا العام، تم تحقيق تقدم يؤدي إلى نماذج أكبر. ومع ذلك، فإن تعديل هذه النماذج الهائلة على الأنظمة العادية يعتبر غير ممكن بدون تقنيات تحسين خاصة.
دخلت Low-Rank Adaptation (LoRA) التي تم تقديمها من قبل Microsoft (MSFT ) في هذه الورقة البحثية، بهدف التغلب على هذه التحديات وجعل النماذج اللغوية الكبيرة أكثر سهولة ومتكيفة.
الجوهر في LoRA يكمن في نهجه لتعديل النموذج دون الحاجة إلى إعادة تدريب النموذج بأكمله. على عكس التعديل التقليدي، حيث يتم تعديل جميع المعلمات، LoRA يتبنى نهجًا أكثر ذكاء. يتم تجميد معلمات النموذج المسبقة وتُضاف مصفوفات تحليل منخفضة الرتبة قابلة للتدريب في كل طبقة من هيكل Transformer. هذا النهج يقلل بشكل كبير من عدد المعلمات القابلة للتعديل، مما يجعل عملية التعديل أكثر كفاءة.
تطور استراتيجيات تعديل LLM
عند النظر إلى رحلة تعديل LLM، يمكننا تحديد العديد من الاستراتيجيات التي استخدمها المتخصصون على مر السنين. في البداية، كان التركيز على تعديل النماذج المسبقة، وهي استراتيجية تتطلب تغيير شامل للمعلمات. ومع نمو النماذج في الحجم والتعقيد، زادت الحاجة إلى استراتيجيات أكثر كفاءة.
الاستراتيجية التالية التي اكتسبت شعبية كانت تعديل الفرعي، وهو نسخة أكثر تقييدًا من سابقه. هنا، يتم تعديل فقط جزء من معلمات النموذج، مما يقلل من الحمل الحاسوبي إلى حد ما. ومع ذلك، فإن تعديل الفرعي لا يزال غير قادر على مواكبة معدل نمو حجم LLM.
مع استكشاف المتخصصين لطرق أكثر كفاءة، ظهر تعديل كامل كنهج صارم ومجزي.
مقدمة إلى LoRA
رتبة المصفوفة هي عدد صفوفها أو أعمدتها المستقلة خطيًا. توضيح بشأن المصدر الإنجليزي: لا يكفي أن تكون الصفوف أو الأعمدة مختلفة؛ المعيار هو الاستقلال الخطي.
- مصفوفة رتبة كاملة: رتبتها تساوي العدد الأقل بين صفوفها وأعمدتها.
- مصفوفة رتبة منخفضة: رتبتها أقل بكثير من كل من عدد صفوفها وأعمدتها، مما يؤدي إلى التقاط عدد أقل من السمات.
الآن، النماذج الكبيرة تملك فهمًا واسعًا لمجالها، مثل اللغة في نماذج اللغة. ومع ذلك، فإن تعديلها لمهام محددة غالبًا ما يتطلب فقط تسليط الضوء على جزء صغير من هذه الفهم. هنا يأتي LoRA. يُقترح أن مصفوفة تعديل الأوزان يمكن أن تكون مصفوفة رتبة منخفضة، مما يؤدي إلى التقاط عدد أقل من السمات.
LoRA يحدد بشكل ذكي رتبة مصفوفة التحديث بتمثيلها بحاصل ضرب مصفوفتين أصغر. وهكذا، بدلاً من تغيير المصفوفة الكاملة، يتم تغيير جزء منها فقط، مما يجعل مهمة التعديل أكثر كفاءة.
تطبيق LoRA على Transformer
LoRA يساعد في تقليل الحمل التدريبي في الشبكات العصبية عن طريق التركيز على مصفوفات الأوزان المحددة. في هيكل Transformer، هناك مصفوفات أوزان مرتبطة بآلية الانتباه الذاتي، وهي Wq و Wk و Wv و Wo، بالإضافة إلى مصفوفتين أخريين في وحدة MLP.

هيكل Transformer

رؤوس الانتباه في Transformer
الشرح الرياضي لـLoRA
لنستعرض الأساس الرياضي لـLoRA:
- مصفوفة الأوزان المسبقة التدريب :
- نبدأ بمصفوفة أوزان مسبقة التدريب بأبعاد . أي إن عدد صفوف المصفوفة هو وعدد أعمدتها هو .
- التحليل منخفض الرتبة:
- بدلًا من التحديث المباشر للمصفوفة الكاملة ، الذي قد يكون مكلفًا حسابيًا، تُستخدم طريقة تحليل منخفض الرتبة.
- التحديث بالنسبة إلى يمكن تمثيله بحاصل ضرب مصفوفتين: و .
- أبعادها
- أبعادها
- النقطة الأساسية هي أن الرتبة أصغر بكثير من كل من و ، مما يتيح تمثيلًا أكثر كفاءة حسابيًا.
- التدريب:
- خلال التدريب، تبقى دون تغيير. وهذا ما يُسمى تجميد الأوزان.
- في المقابل، فإن و هما المعلمتان القابلتان للتدريب، أي إن التعديلات تُجرى على المصفوفتين و لتحسين أداء النموذج.
- الضرب والجمع:
- كل من والتحديث (وهو حاصل ضرب و ) يُضربان في المدخل نفسه، الذي نرمز إليه بـ .
- ثم تُجمع نواتج عمليتي الضرب.
- تُلخّص هذه العملية بالمعادلة: حيث تمثل المخرج النهائي بعد تطبيق التحديثات على المدخل .
تتيح هذه الطريقة تحديث مصفوفة أوزان كبيرة بكفاءة أكبر عبر تمثيل التحديثات بتحليل منخفض الرتبة، مما يفيد كفاءة الحساب واستخدام الذاكرة.
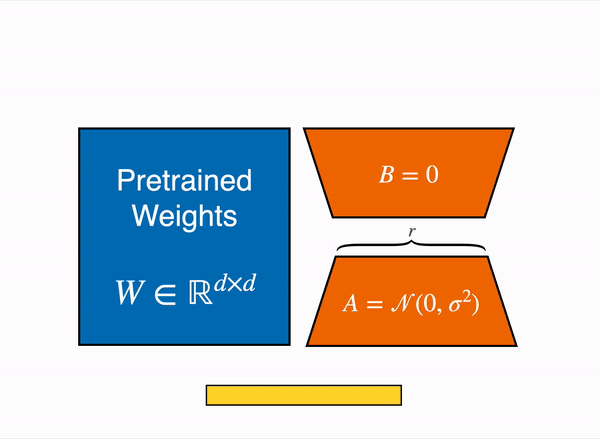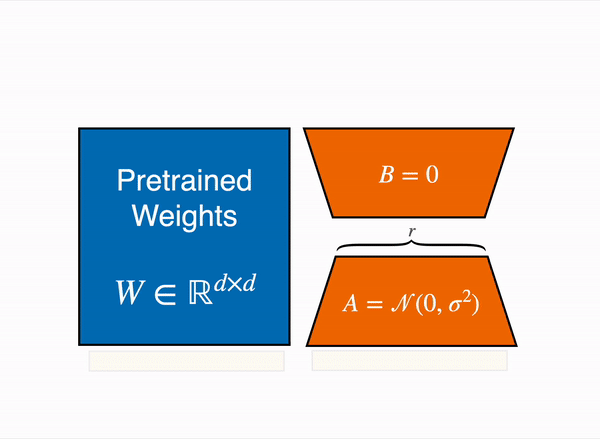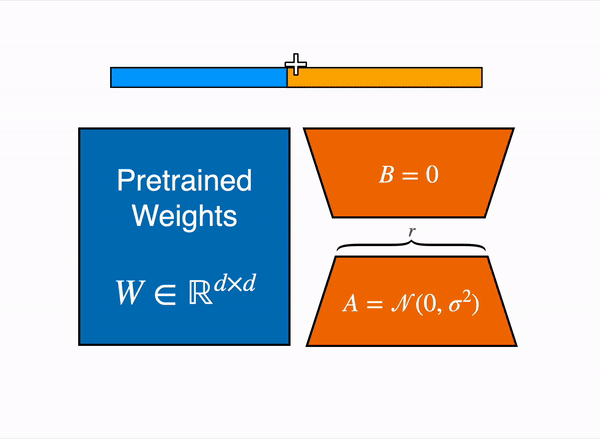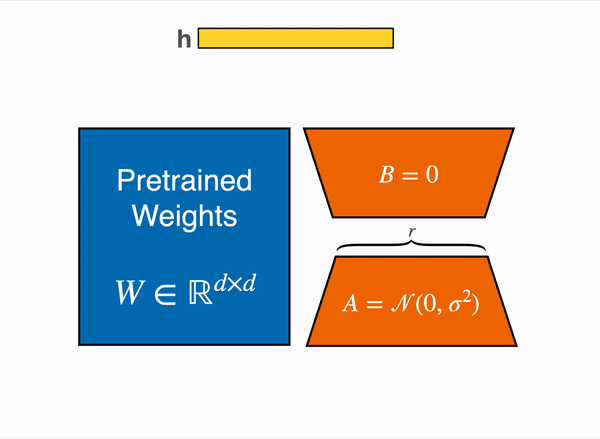
LORA
التهيئة والتحجيم:
تؤثر طريقة تهيئة المعلمات في كفاءة التعلم وفعاليته. هنا ننظر إلى تحديث مصفوفة الأوزان باستخدام و :
- تهيئة المصفوفتين و :
- المصفوفة : تُهيّأ بقيم غاوسية عشوائية، أي من توزيع طبيعي. الهدف هو كسر التناظر: عندما تبدأ عصبونات الطبقة نفسها بأوزان مختلفة، يمكنها تعلم ميزات مختلفة.
- المصفوفة : تُهيّأ بالأصفار، ولذلك يبدأ التحديث بصفر عند بدء التدريب، فلا يتغير سلوك النموذج فجأة، بل يتكيف تدريجيًا بينما تتعلم قيمًا مناسبة خلال التدريب.
- تحجيم خرج التحديث :
- بعد حساب التحديث ، يُضرب خرجه في العامل حيث إن ثابتة. يتيح التحجيم التحكم في مقدار التحديثات.
- تزداد أهمية التحجيم عندما تتغير الرتبة . فمثلًا عند زيادة الرتبة لتحسين الدقة مقابل كلفة حسابية أكبر، يساعد التحجيم على تجنب الحاجة إلى تعديل كثير من المعلمات الفائقة الأخرى ويمنح النموذج قدرًا من الاستقرار.
الأثر العملي لـLoRA
تستخدم أوساط الذكاء الاصطناعي LoRA أيضًا لتكييف نماذج الصور مع أساليب فنية محددة، كما في مثال أسلوب Greg Rutkowski. توضيح بشأن المصدر الإنجليزي: المثال المرتبط يخص نموذج الصور SDXL، لا نموذجًا لغويًا كبيرًا.
توضح ورقة LoRA باستخدام GPT-3 ذي 175 مليار معلمة أن الاحتفاظ بنسخ مضبوطة مستقلّة، لكل منها هذا العدد من المعلمات، مكلف جدًا. في المثال المذكور يقل عدد المعلمات القابلة للتدريب بعامل 10,000، وتنخفض متطلبات ذاكرة GPU إلى الثلث.

أثر LoRA في الضبط الدقيق لـGPT-3
تساعد LoRA على جعل النماذج اللغوية أكثر إتاحة، وتربط التقدم النظري بالتطبيقات العملية عبر تخفيف عوائق الحساب وتوفير تكييف أكثر كفاءة للنموذج، بما يدعم اعتمادها ونشرها في تطبيقات العالم الحقيقي.
QLoRA (مكمّمة)
في حين أن LoRA تقلل من احتياجات التخزين، لا تزال تتطلب كمبيوترًا قويًا لتحميل النموذج للتدريب. هنا يأتي QLoRA، أو Quantized LoRA، الذي يجمع بين LoRA والتكميم لنهج أكثر ذكاء.

التكميم
معلمات الأوزان عادةً ما يتم تخزينها في تنسيق 32 بت (FP32)، مما يعني أن كل عنصر في المصفوفة يأخذ 32 بت من المساحة. تخيل لو كنت قادرًا على ضغط نفس المعلومات في 8 بت أو حتى 4 بت. هذه هي الفكرة الأساسية وراء QLoRA. يربط التكميم قيمًا مستمرة بعدد أقل من القيم المنفصلة المحدودة، وفي النماذج اللغوية يحوّل الأوزان من أنواع بيانات عالية الدقة إلى أنواع أقل دقة.

التكميم في النماذج اللغوية الكبيرة
هنا يأتي QLoRA:
- التكميم الأولي: يُكمّم النموذج اللغوي الكبير إلى 4 بت، مما يقلل بشكل كبير من بصمة التخزين.
- تدريب LoRA: ثم تُدرّب محوّلات LoRA بدقة حسابية أعلى. يذكر المقال الإنجليزي FP32، بينما تستخدم ورقة QLoRA الأصلية عادة BF16 للحساب ولمعلمات المحوّلات.
توضيح بشأن المصدر: يصف المقال الإنجليزي إعادة الأوزان إلى FP32، بينما تميّز QLoRA الأصلية بين تخزين الأوزان الأساسية المجمّدة بأربعة بتات والحساب عادة بدقة BF16. تُفك كمّية التنسورات المطلوبة للحساب، وتُحسب تدرجات الأوزان لمحوّلات LoRA فقط؛ فلا تُعاد عملية تدريب جميع الأوزان الأساسية.
تُستخدم LoRA عمليًا عبر مكتبة PEFT من Hugging Face. ويمكن استخدام QLoRA عبر مكتبتَي bitsandbytes وPEFT، فيما تسهّل مكتبة TRL الضبط الدقيق الخاضع للإشراف مع دعم LoRA. توفر هذه الأدوات أساسًا لضبط نموذج مسبق التدريب، مثل توليد أوصاف منتجات مقنعة ومتماسكة وفق تعليمات تصف خصائصها.
يشير المقال الإنجليزي بعد ذلك إلى صعوبات التحويل ودمج المحوّلات بعد QLoRA. ولا يعني ذلك أن كل أسلوب نشر يتطلب تخزين جميع الأوزان دائمًا بدقة عالية. تقترح QA-LoRA عمليات على مجموعات من الأوزان تجمع بين التكميم والتكيّف منخفض الرتبة، وتسمح بدمج الأوزان النهائية في نموذج مكمّم مع الحفاظ على كفاءة العملية وفعالية النموذج للمهمة.
الختام
في هذه المقالة، تناولنا التحديات التي تطرحها النماذج اللغوية الكبيرة بسبب حجمها الهائل. وقد استكشفنا ممارسات التعديل التقليدية ومتطلباتها الحسابية والمالية. جوهر LoRA يكمن في قدرته على تعديل النماذج المسبقة دون إعادة تدريب جميع أوزانها الأساسية، مما يقلل من المعلمات القابلة للتعديل ويجعل عملية التعديل أكثر كفاءة.
كما تناولنا QLoRA، وهو مزيج من LoRA والتكميم، الذي يقلل من بصمة التخزين للنموذج مع الحفاظ على الدقة الأساسية للتدريب. بهذه التقنيات المتقدمة، أصبح المتخصصون الآن مجهزين بمكتبات قوية، مما يسهل تبني وتنفيذ النماذج اللغوية الكبيرة في مجموعة واسعة من السيناريوهات الواقعية.

المصفوفة
تتمثل هذه الاستراتيجيات في تحقيق التوازن بين جعل النماذج اللغوية الكبيرة قابلة للتكيف لمهام محددة وضمان أن عمليات التعديل والتنفيذ ليست متطلبة بشكل مفرط من حيث الحوسبة وموارد التخزين.


