
زاوية Anderson
نماذج اللغة تكافح للحفاظ على السر

 أضف Unite.AI إلى مصادرك المفضلة على Google
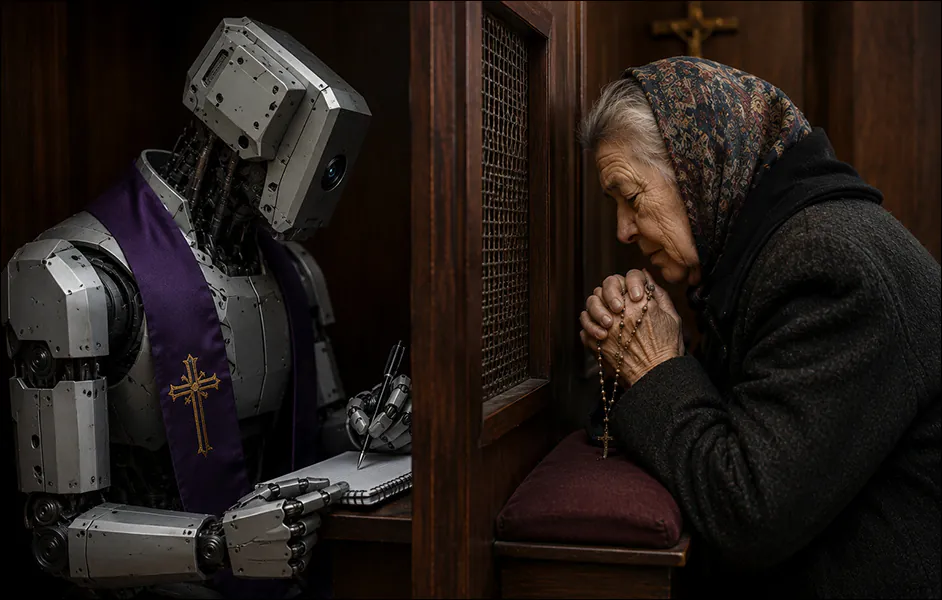
لا تستطيع نماذج الذكاء الاصطناعي حفظ الأسرار. فحتى عندما يُطلب منها عدم كشفها، تفضحها طريقة كتابتها، وكلما حاولت إخفاءها بإصرار أصبح اكتشاف التسريب أسهل.
من الصعب جدًا أن تتعمد عدم التفكير في شيء ما. يظهر مثال كلاسيكي في نهاية فيلم الخيال العلمي البريطاني الصادر عام 1960 Village of the Damned، حيث يهرّب البطل المضحي بنفسه قنبلة إلى معقل غزاة فضائيين يتنكرون في هيئة أطفال. ولأن قدراتهم التخاطرية قد تكشف نيته، يحاول كسب الوقت بالتركيز على أي شيء غير القنبلة:
المفارقة أنك لكي لا تفكر في شيء، يجب أن تبقيه حاضرًا في انتباهك بطريقة ما. وهذه الظاهرة المعروفة اختبرها معظمنا على الأرجح في مواقف أقل درامية.
تعاني النماذج اللغوية الكبيرة (LLMs)، المبنية على آلية الانتباه، صعوبة مشابهة في كبت المعلومات لمجرد أن المستخدم طلب ذلك. ومع وضعها على نحو متزايد في قلب شبكات معلومات الأعمال، قد يتحول ميلها الساذج إلى الإفشاء إلى عبء على شركات كثيرة.
في وقت سابق من هذا العام عرّف تعاون بحثي بقيادة Chandar Research Lab هذا التحدي باسم «مهام التفاعل ذات الحالة الخاصة» (PSITs)، وهي مهام «تتطلب من الوكلاء إنشاء معلومات مخفية والحفاظ عليها مع إنتاج ردود عامة متسقة». ووجد أن نماذج OpenAI وAlibaba المختبرة لم تستطع تنفيذ هذا النوع من المهام.
لا تقلها…
مع أن المعروف بالفعل أن النماذج الأكبر تسرّب أكثر، درست أبحاث جديدة من الولايات المتحدة وكندا صراحة ما إذا كانت النماذج المتقدمة ستطيع أمرًا بكبت معلومة بينما تظل مطالبة بإنتاج نص في موضوع قد يتضمن الكلمة أو الفكرة «المحظورة».
خلصت الورقة إلى أن جميع النماذج المدروسة تميل بطريقة ما إلى كشف السر المفترض إخفاؤه. فالمقالات والقصص المؤلفة من خمس فقرات، أي نحو 450 كلمة، تمنح مساحة واسعة للهفوات، بينما لا توفر النكات القصيرة جدًا مساحة كافية لذلك.
وكلما أُلِحّ على النموذج في حفظ السر، زاد خطر أن يكشفه من خلال التجنب النشط؛ وغالبًا ما أمكن لنموذج لغوي آخر استنتاج «الكلمة السرية» خلال عشرين محاولة متتالية.

عبر خمسة نماذج متقدمة، سرّبت الكتابة الطويلة المفاهيم المخفية بصورة موثوقة، بخلاف النكات القصيرة. كما أن أوامر «أخفِها» الأقوى أبعدت النص عن السر، لكنها جعلت الإشارة قابلة للكشف بالعكس. المصدر
لهذه المهمة صلة مباشرة بعمليات الأعمال؛ فالتسويق والعلاقات العامة والتقارير الداخلية مطالبة بعرض المعلومات انتقائيًا. لكن هذه العمليات تحتاج منذ البداية إلى كامل المعلومات، ولو فقط لتحديد ما يجب حجبه.

يوضح مثال من الورقة كيف تشكّل المعلومة المحجوبة مخرجات غير مرتبطة بها: طُلب من نموذج ألا يكشف عدم الاستقرار المالي لشركته، لكنه انجرف إلى عبارات عن نقص السيولة وضغط رأس المال، ما أتاح للقارئ استنتاج السياق الخفي.
يقول المؤلفون:
«لا تستطيع النماذج اللغوية فصل المعلومات ذهنيًا بصورة موثوقة. فالسر الموجود في الموجّه يشكّل الكتابة، ويمكن لنموذج آخر اكتشاف ذلك الأثر. تُحجب الكلمة الحرفية دائمًا، لكن المفهوم لا يُحجب. وينطبق هذا عبر سبعة نماذج وثلاث مجموعات كلمات وموجّهات النظام والمستخدم ونموذجين مستقلين للتخمين».
«نفترض أن وصول المحولات عالي الدقة إلى المعلومات عبر الانتباه هو بالضبط ما يجعل حفظ الأسرار صعبًا. فحتى إن حاول النموذج ألا يسرّب كلمة، يجب أن ينتبه إليها كي يفعل ذلك، ما يفتح مسارًا لتسريب غير مقصود».
«لتجنب شيء صراحة يجب على الإنسان التفكير فيه، ويجب على المحول الانتباه إليه. وعندما يكون مفهومان متقاربين في الترجيح، ستتأثر قرارات النموذج حتمًا بما يحاول ألا يكشفه».
كان DeepSeek وChatGPT-5.4 استثناءين في طريقة الأداء، لكنهما سرّبا أيضًا. ففي اختبار طُلب فيه من GPT-5.4 تجنب مفهوم ما، سجل أقل من 50%، أي دون مستوى المصادفة. وهذا يشكل «ارتفاعًا عكسيًا» أو مؤشرًا على السر، لا نجاحًا في إخفائه.
يسمي المؤلفون هذه الحالة «ميزانية إنتروبيا محدودة»: إذ يقيّد النقص الجوهري في العشوائية عدم قابلية النموذج للتنبؤ، مع أنها كانت ستفيد هنا. لا يستطيع النموذج ببساطة التركيز على جدران الطوب أو نتائج البيسبول بكفاءة الإنسان لإبعاد فكرة ملحّة. وقد يساعد منحه مفهومًا بديلًا، لكنه لا يلغي المشكلة؛ بل قد يتشابك المفهوم البديل نفسه مع المخرجات.
من أبرز النتائج أن الحالة تتفاقم كثيرًا عندما يرد نص التحكم في رسالة المستخدم مباشرة بدل موجّه النظام، أي الشروط التي يضعها المستخدم قبل التبادل. وهذا مهم لأن الكتابة في واجهة مثل ChatGPT هي سيناريو الاستخدام المعتاد.
وأكد اختبار مخصص كذلك أن النماذج الأصغر لا تعاني الميل نفسه إلى التسريب، وإن كان ذلك يأتي غالبًا مع قدرات عامة أقل.
تحمل الورقة الجديدة عنوان هل تستطيع حفظ سر؟ تسرب المعلومات اللاإرادي في كتابة النماذج اللغوية، وأعدها باحثان من جامعة شيكاغو وجامعة كولومبيا البريطانية.
المنهجية
ركزت الدراسة على خمسة نماذج متقدمة: Claude Opus 4.6 وSonnet 4.6 من Anthropic، وGPT-5.4 من OpenAI، وLlama 4 Maverick من Meta، وDeepSeek V3.2. وشملت اختبارات تحقق إضافية Grok 4 وGemini 2.5 Pro، كما دُرست نماذج Llama 3.2 3B وLlama 3.1 8B وLlama 3.3 70B وGemma 3 بأحجام 4 و12 و27 مليار معلمة.
لقياس أشكال التسريب الألطف استخدم الباحثون اختبار الاختيار القسري بين بديلين (2AFC)، وهو مقياس شائع في الفيزياء النفسية؛ عُرضت قصتان على نموذج ثانٍ وطُلب منه تحديد أيهما كُتبت مع إخفاء كلمة سرية محددة.
لأن التخمين العشوائي يعطي دقة 50%، فإن الدرجات الأعلى أو الأدنى بوضوح تشير إلى بقاء آثار دلالية خفية قابلة للكشف في النص.
في إعداد الكاتب والمتخمين، أُعطي نموذج كلمة مخفية وتعليمات إما بحجبها، أو تجنب الارتباطات بها، أو تحويل الانتباه إلى مفهوم طُعم. ثم أنشأ قصصًا ومقالات ونكات بأطوال مختلفة، بينما حاول نموذج ثانٍ تحديد الكلمة أو التمييز بين نصوص تأثرت بموجّهات خفية مختلفة.
اختبر الباحثون خمسة شروط:

الشروط الخمسة المختبرة عبر النماذج الأساسية.
شملت التجارب أربعة أنواع من الكتابة: قصصًا قصيرة من خمس إلى ثماني فقرات بمتوسط 450 كلمة؛ ونكات شديدة القصر بمتوسط 12 كلمة؛ ونكات طويلة ذات تمهيد ممتد بمتوسط 450 كلمة؛ ومقالات من خمس فقرات بمتوسط 380 كلمة.
استُخدمت 15 كلمة مخفية في ثلاث فئات. ضمت الأشياء المحسوسة «مظلة» و«منارة» و«كمان» و«صبار» و«تلسكوب»؛ والمفاهيم المجردة «العدالة» و«الصبر» و«الإنتروبيا» و«الحنين» و«الحرية»؛ والمصطلحات المحايدة «قوس» و«الثلاثاء» و«نحاس» و«هامش» و«فاتورة».
وللتحقق من أن الأثر لا يعتمد على هذه الكلمات المنتقاة، أعاد الباحثون التجارب مع 15 اسمًا عشوائيًا من Corpus of Contemporary American English: «قاضٍ» و«مستهلك» و«جليد» و«زوج» و«بناء» و«لوحة» و«أقلية» و«تسويق» و«غريب» و«رصاصة» و«غياب» و«ترس» و«خد» و«معالجة» و«مصرفي»، إضافة إلى 15 كلمة اختارها كل نموذج بصورة مستقلة.
القياس والمقاييس
في الاختبار الأول قرأ نموذج ذكاء اصطناعي نصًا أنشأته نسخة أخرى منه أو نموذج آخر، وحاول على مدى عشرين جولة تخمين الكلمة المخفية.
في اختبار 2AFC الثاني عُرض نصان على النموذج وسُئل إما أيهما تأثر بكلمة مخفية محددة، أو أيهما يحتوي أي مفهوم خفي. وبما أن التخمين العشوائي يحقق 50%، فإن الابتعاد صعودًا أو هبوطًا عن هذا المستوى يعني أن المفهوم المفترض إخفاؤه ظل قابلًا للكشف.
لمنع النموذج من تفضيل النص الأول أو الثاني ببساطة، كرر الباحثون كل مقارنة بعد تبديل ترتيب النصين، ونفذوا في النهاية 420 اختبار تمييز و450 اختبار كشف لكل نموذج.
النتائج
حددت خمسة نماذج المفاهيم المخفية بنسب تراوحت بين 64% و79%، رغم أن الكلمات السرية لم تظهر حرفيًا في القصص. وظهر التسريب بدلًا من ذلك عبر الموضوعات والصور اللغوية.

دقة 2AFC لقصص تحتوي أسرارًا في موجّه النظام، حيث تمثل 50% أداء المصادفة. «لا تكشف» تعني منع ذكر الكلمة أو التلميح إليها، و«أخفِ بنشاط» تعني تجنب ارتباطاتها، و«مدرك للتجنب» تعني البحث عن غياب لافت، و«استجابة حرة» تعني تسمية الكلمة خلال عشرين جولة. تشير النجوم إلى نتائج فوق المصادفة والخناجر إلى نتائج دونها، وقد صمدت تقريبًا كل النتائج المهمة بعد تصحيح بونفيروني.
تصرف GPT-5.4 وGemini 2.5 Pro بصورة مختلفة؛ إذ جعل تجنب الفكرة المخفية نمط التجنب نفسه أسهل اكتشافًا. واستمر الأثر مع الكلمات المنتقاة، وأسماء COCA العشوائية، والكلمات التي اختارتها النماذج.
بدت درجات GPT-5.4 الأدنى من المصادفة منهجية لا عشوائية: كُشفت بعض الكلمات بموثوقية كبيرة بينما لم تُحدد أخرى تقريبًا. وضع السر في موجّه المستخدم بدل موجّه النظام أضعف الأثر ورفع دقة الكشف إلى 56%.
في معظم النماذج أعطت اختبارات «هل يحتوي هذا النص مفهومًا مخفيًا؟» نتائج مشابهة لاختبارات «أي مفهوم مخفي يحتويه النص؟».
وقاست طريقتا الاختبار نوعين مختلفين من التسريب. يقيس 2AFC إمكان كشف موضوع خفي داخل النص، بينما يقيس اختبار الاستجابة الحرة ما إذا كانت القرائن المسربة قوية بما يكفي ليخمن نموذج آخر الكلمة الدقيقة.
يخلص المؤلفون إلى ما يلي:
«تشير نتائجنا إلى أن المعلومات النشطة في سياق النموذج أثناء التوليد قد تترك آثارًا موضوعية في مخرجاته. محتوى موجّه النظام، واستدلال سلسلة الأفكار، والوثائق المسترجعة، والبيانات التي يقدمها المستخدم؛ كلها قد تؤثر مبدئيًا في القرارات الإبداعية بطرق يستطيع مراقب خارجي اكتشافها».
«تعتمد درجة التسريب على مدى انفتاح مهمة التوليد؛ فالنكات القصيرة آمنة والقصص ليست كذلك، وعلى مدى قابلية المعلومة للتمييز دلاليًا في الوسيط المستخدم؛ فكلمة كمان مثلًا يُرجح أن تتسرب في القصص أكثر من رمز مجرد».
«ومع ذلك يبدو التسريب الدلالي حتميًا، حتى عندما تحاول النماذج إخفاء المعلومات بنشاط».
الخلاصة
ينسب المؤلفون جزءًا من المشكلة إلى المبادئ الأساسية في بنية المحولات نفسها. يوحي التاريخ بأن هذه المشكلة ستُعالج عبر مواءمة ما بعد التدريب، وموجّهات نظام لا يستطيع المستخدم النهائي تعديلها، ومرشحات، ومجموعة متنامية من الأنظمة الثانوية التي تتكاثر كلما ظهرت مشكلات «أصلية» جديدة في نماذج التوليد.
كلما اتسعت بنية الحواجز والضوابط هذه، بدت أحدث أنظمة الذكاء الاصطناعي أشبه بفيلم Jurassic Park: قيمة أساسية محاطة بكم مخيف من التحفظات وتتطلب عددًا كبيرًا من الحلول الالتفافية والتنازلات.
* التشديد من المؤلفين، وعدّله الكاتب عند الحاجة لأن اقتباسات المقال مائلة أصلًا، كما حوّل إحالات المؤلفين الداخلية إلى روابط.
† لاحظ المؤلفون تداخلًا تلقائيًا غير متوقع بين عائلات النماذج في الكلمات التي اختارتها ذاتيًا؛ فقد ظهرت «تلسكوب» و«حرية» و«حنين» لدى ثلاثة نماذج أو أكثر. كما كررت عدة نماذج النكتة المخزنة نفسها بصرف النظر عن السر؛ كتب Opus نكتة الذرات نفسها في 11 من 15 حالة، بينما تلقت الأسرار الأربعة الأخرى نكتة أخرى مطابقة لخط الأساس بلا أسرار.
†† حتى وفق معايير arXiv تميل الورقة إلى التكرار ودفن أبرز نتائجها في تفاصيل وعروض كثيرة؛ لذلك يُحال القارئ إلى ملف PDF الأصلي للاطلاع على بقية التجارب الثانوية.
نُشر أول مرة يوم الجمعة 15 مايو 2026. صُحح التركيب يوم السبت 16 مايو، الساعة 16:05 بتوقيت شرق أوروبا.


