
نماذج ومنصات الذكاء الاصطناعي
EchoSpeech: ثورة في التواصل مع تقنية التعرف على الكلام الصامت

 أضف Unite.AI إلى مصادرك المفضلة على Google
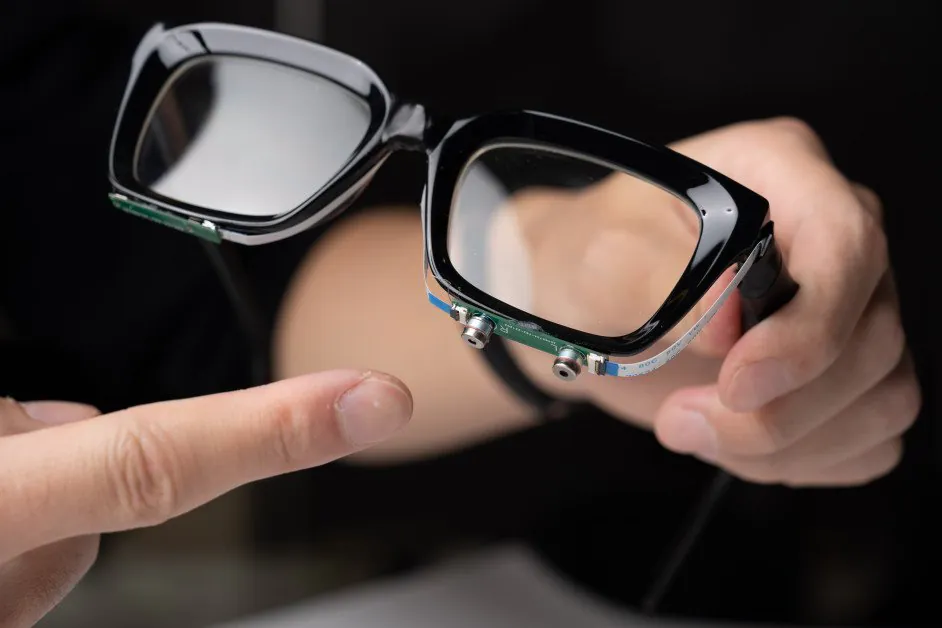
النقاط الرئيسيةيعيد EchoSpeech الصوت للمرضى الذين لا يستطيعون إصدار الصوت.
عرض المزيد
- يعيد EchoSpeech الصوت للمرضى الذين لا يستطيعون إصدار الصوت.
- تزيل الاستشعار الصوتي خطر الخصوصية المرتبط بكاميرات الفيديو القابلة للارتداء.
- تحافظ المعالجة على الجهاز على بيانات الكلام الحساسة تحت سيطرة المستخدم.
طوّر باحثون في جامعة كورنيل EchoSpeech، وهي واجهة للتعرف على الكلام الصامت تستخدم الاستشعار الصوتي والذكاء الاصطناعي للتعرف باستمرار على ما يصل إلى 31 أمرًا غير منطوق، استنادًا إلى حركات الشفتين والفم. ويمكن تشغيل هذه الواجهة القابلة للارتداء والمنخفضة الاستهلاك للطاقة على هاتف ذكي، ولا تتطلب سوى بضع دقائق من بيانات تدريب المستخدم للتعرف على الأوامر.
رودونغ زانغ، وهو طالب دكتوراه في علوم المعلومات، هو المؤلف الرئيسي لـ “EchoSpeech: Continuous Silent Speech Recognition on Minimally-obtrusive Eyewear Powered by Acoustic Sensing،” والذي سوف يتم تقديمه في مؤتمر العوامل البشرية في أنظمة الحوسبة (CHI) التابع لجمعية آلات الحوسبة هذا الشهر في هامبورغ، ألمانيا.
“لأشخاص لا يستطيعون النطق، يمكن أن تكون هذه التقنية الصامتة مُدخلاً ممتازًا لنظام تركيب صوتي. يمكن أن تُرجع الأصوات للمرضى”، قال زانغ، مشيرًا إلى التطبيقات المحتملة للتكنولوجيا مع التطويرات الإضافية.
التطبيقات العملية والفوائد الخاصة بالخصوصية
في شكله الحالي، يمكن استخدام EchoSpeech للتواصل مع الآخرين عبر هاتف ذكي في البيئات التي يكون فيها الكلام غير ملائم أو غير مناسب، مثل المطاعم الصاخبة أو المكتبات الهادئة. يمكن أيضًا ربط واجهة الكلام الصامت بقلم رقمي واستخدامها مع برنامج التصميم مثل CAD، مما يقلل بشكل كبير من الحاجة إلى لوحة مفاتيح وفأرة.
تتمتع نظارات EchoSpeech بميكروفونات ومكبرات صوت أصغر من ممحاة القلم، وتعمل كنظام سونار مدعوم بالذكاء الاصطناعي قابل للارتداء، وإرسال واستقبال الموجات الصوتية عبر الوجه واكتشاف حركات الفم. ثم تحلل خوارزمية تعلم عميق أنماط الصدى هذه في الوقت الفعلي بدقة تقارب 95%.
“نحن ننتقل إلى وضع السونار على الجسم”، قال تشينغ زانغ، أستاذ مساعد في علوم المعلومات ومدير مختبر واجهات الحاسوب الذكية للتفاعلات المستقبلية (SciFi) في جامعة كورنيل.
تعتمد تقنيات التعرف على الكلام الصامت الحالية بشكل عام على مجموعة محدودة من الأوامر المحددة مسبقًا وتتطلب من المستخدم مواجهة أو ارتداء كاميرا. وأوضح تشينغ زانغ أن هذا ليس عمليًا ولا ممكنًا وأيضًا يثير مخاوف كبيرة تتعلق بالخصوصية للمستخدم والذين يتفاعلون معهم.
تُزيل تقنية الاستشعار الصوتي في EchoSpeech الحاجة إلى كاميرات فيديو قابلة للارتداء. بالإضافة إلى ذلك، نظرًا لأن بيانات الصوت أصغر من بيانات الصورة أو الفيديو، فإنها تتطلب عرض نطاق ترددي أقل لمعالجتها ويمكن نقلها إلى هاتف ذكي عبر البلوتوث في الوقت الفعلي، وفقًا لفرنسوا غيمبرتيير، أستاذ في علوم المعلومات.
“و لأن البيانات يتم معالجتها محليًا على هاتفك الذكي بدلاً من تحميلها إلى السحابة”، قال، “فإن المعلومات الحساسة المتعلقة بالخصوصية لا تترك أبدًا سيطرتك”.


