
نماذج ومنصات الذكاء الاصطناعي
ذكرى أول عام لتشات جبت: إعادة تشكيل مستقبل التفاعل مع الذكاء الاصطناعي

 أضف Unite.AI إلى مصادرك المفضلة على Google

النقاط الرئيسيةأعاد اعتماد ChatGPT السريع ووصوله إلى 1.7 مليار زيارة شهرياً تشكيل تفاعل الجمهور مع…
عرض المزيد
- أعاد اعتماد ChatGPT السريع ووصوله إلى 1.7 مليار زيارة شهرياً تشكيل تفاعل الجمهور مع الذكاء الاصطناعي.
- نماذج الذكاء الاصطناعي المفتوحة المصدر مثل Llama-2 تنافس الآن النماذج المملوكة في المعايير الرئيسية.
- تشير قدرة النموذج المزعوم Q* في الرياضيات إلى قفزة نحو قدرة الذكاء الاصطناعي على التفكير المنطقي.
عندما ننظر إلى ذكرى أول عام لتشات جبت، يبدو واضحًا أن هذه الأداة قد غيرت المشهد بشكل كبير. تم إطلاق تشات جبت في نهاية عام 2022، وتميزت بتصميمها السهل الاستخدام والنمط المحادثي الذي جعل التفاعل مع الذكاء الاصطناعي يشبه المحادثة مع شخص أكثر من الآلة. جذب هذا النهج الجديد الانتباه العام بسرعة. في غضون خمسة أيام فقط بعد إطلاقها، جذبت تشات جبت مليون مستخدم. بحلول بداية عام 2023، ارتفع هذا الرقم إلى حوالي 100 مليون مستخدم شهريًا، وبحلول أكتوبر، سجلت المنصة حوالي 1.7 مليار زيارة في جميع أنحاء العالم. هذه الأرقام تتحدث عن شعبية الأداة وفائدتها.
على مدار العام الماضي، وجد المستخدمون طرقًا إبداعية لاستخدام تشات جبت، من المهام البسيطة مثل كتابة البريد الإلكتروني وتحديث السيرة الذاتية إلى بدء أعمال ناجحة. ولكن الأمر لا يتعلق فقط بكيفية استخدام الناس لها؛ فقد نمت التكنولوجيا نفسها وتحسنت. في البداية، كانت تشات جبت خدمة مجانية تقدم استجابات نصية مفصلة. الآن، هناك تشات جبت بلس، الذي يتضمن تشات جبت-4. هذا الإصدار المحدّث مدرب على المزيد من البيانات، ويقدم أقل عدد من الإجابات الخاطئة، ويفهم التعليمات المعقدة بشكل أفضل.
أحد أكبر التحديثات هو أن تشات جبت يمكنها الآن التفاعل بطرق متعددة – يمكنها الاستماع والتحدث ومعالجة الصور. هذا يعني أنك يمكنك التحدث معها من خلال تطبيق الهاتف المحمول وعرض الصور عليها للحصول على استجابات. هذه التغييرات فتحت إمكانيات جديدة للذكاء الاصطناعي وغيّرت كيف ننظر إلى دور الذكاء الاصطناعي في حياتنا.
من بدايتها كتجربة تقنية إلى وضعها الحالي كلاعب رئيسي في عالم التكنولوجيا، رحلة تشات جبت مثيرة للإعجاب. في البداية، تم النظر إليها على أنها وسيلة لاختبار وتحسين التكنولوجيا من خلال الحصول على تعليقات من العامة. ولكنها سرعان ما أصبحت جزءًا أساسيًا من مشهد الذكاء الاصطناعي. هذا النجاح يظهر مدى فعالية الضبط الدقيق للنماذج اللغوية الكبيرة (LLM) باستخدام التعلم الإشرافي وآراء البشر. ونتيجة لذلك، يمكن لتشات جبت التعامل مع مجموعة واسعة من الأسئلة والمهام.
سباق تطوير أنظمة الذكاء الاصطناعي الأكثر قدرة وتنوعًا أدى إلى انتشار النماذج المفتوحة والمملوكة. لفهم قدراتها العامة، يتطلب الأمر مقاييس شاملة عبر طيف واسع من المهام. هذا القسم يبحث في هذه المقاييس، ويشرح كيف تقف النماذج المختلفة، بما في ذلك تشات جبت، في مواجهة بعضها البعض.
تقييم LLMs: المقاييس
- MT-Bench: يختبر هذا المعيار القدرة على المحادثات متعددة الجولات واتباع التعليمات عبر ثمانية مجالات: الكتابة، والتمثيل، واستخراج المعلومات، والاستدلال، والرياضيات، والبرمجة، والمعارف في العلوم والتكنولوجيا والهندسة والرياضيات (STEM)، والعلوم الإنسانية والاجتماعية. يتم استخدام نماذج LLMs الأقوى مثل GPT-4 كمقييمين.
- AlpacaEval: يستند هذا المقاييس إلى مجموعة تقييم AlpacaFarm، ويقوم بتقييم النماذج باستخدام استجابات من نماذج LLMs متقدمة مثل GPT-4 وClaude، ويتابع معدل الفوز للنماذج المرشحة.
- لوحة ترتيب LLMs المفتوحة: باستخدام هارنيس تقييم النماذج اللغة، تقييم هذه اللوحة النماذج LLMs على سبعة مقاييس رئيسية، بما في ذلك تحديات الاستدلال واختبارات المعرفة العامة، في كل من الإعدادات دون أمثلة (zero-shot) وبأمثلة قليلة (few-shot).
- BIG-bench: يغطي هذا المقاييس التعاوني أكثر من 200 مهمة لغة جديدة، ويشمل مجموعة متنوعة من الموضوعات واللغات. يهدف إلى اختبار قدرات النماذج LLMs وتوقع قدراتها المستقبلية.
- ChatEval: إطار مناقشة متعدد الوكلاء يسمح للفرق بالمناقشة والتقويم التلقائي لجودة الاستجابات من نماذج مختلفة حول أسئلة مفتوحة ومهام توليد اللغة الطبيعية التقليدية.
الأداء المقارن
فيما يتعلق بالمقاييس العامة، أظهرت النماذج LLMs المفتوحة تقدمًا ملحوظًا. على سبيل المثال، Llama-2-70B حقق نتائج مثيرة للإعجاب، خاصة بعد ضبطه ببيانات التعليمات. وقد تميز متغيره Llama-2-chat-70B في AlpacaEval بمعدل فوز بلغ 92.66%، متجاوزًا GPT-3.5-turbo، بينما ظل GPT-4 في الصدارة بمعدل فوز بلغ 95.28%. وأظهر أداءً مماثلًا من قبل Zephyr-7B، وهو نموذج أصغر، والذي أظهر قدرات قابلة للمقارنة مع نماذج لغوية كبيرة أكبر حجمًا ذات 70 مليار معامل، خاصة في AlpacaEval وMT-Bench.
WizardLM-70B، الذي تم تحسينه مع مجموعة متنوعة من بيانات التعليمات، سجل أعلى درجة بين النماذج LLMs المفتوحة على MT-Bench. ومع ذلك، كان لا يزال متأخرًا عن GPT-3.5-turbo وGPT-4.
دخول مثير للاهتمام، GodziLLa2-70B، حقق درجة تنافسية على لوحة ترتيب LLMs المفتوحة، مما يظهر إمكانات النماذج التجريبية التي تجمع بين مجموعات بيانات متنوعة. وبالمثل، Yi-34B، الذي تم تطويره من الصفر، برز بنتائج قابلة للمقارنة مع GPT-3.5-turbo، ولم يتأخر إلا قليلًا عن GPT-4.
أما UltraLlama، الذي جرى ضبطه باستخدام بيانات متنوعة وعالية الجودة، فقد عادل GPT-3.5-turbo في المعايير المقترحة، بل وتجاوزه في مجالي المعرفة العامة والمعرفة المهنية.
توسيع النطاق: صعود النماذج LLMs العملاقة
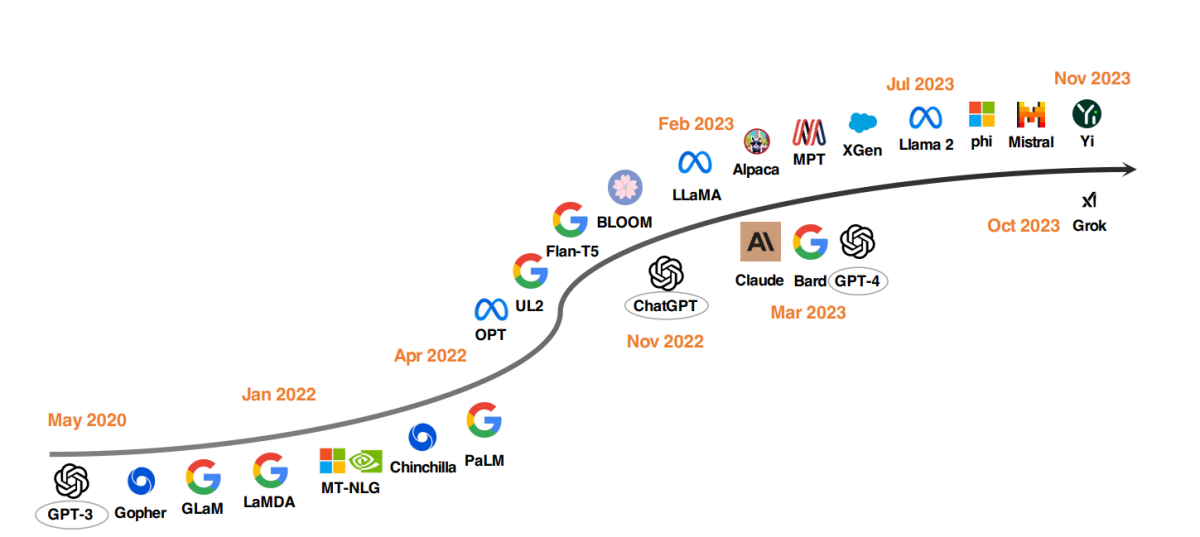
أفضل نماذج LLM منذ عام 2020
اتجاه ملحوظ في تطوير LLMs هو زيادة معاملات النموذج. قد مددت نماذج مثل Gopher وGLaM وLaMDA وMT-NLG وPaLM الحدود، مما أدى إلى نماذج تصل إلى 540 مليار معامل. أظهرت هذه النماذج قدرات استثنائية، ولكن طبيعتها المغلقة حدّت من تطبيقها على نطاق أوسع. هذا الحد أثار اهتمامًا بتطوير نماذج LLMs مفتوحة المصدر، وهو اتجاه يكتسب زخمًا.
بالتوازي مع زيادة أحجام النماذج، بحث العلماء استراتيجيات بديلة تركز على تحسين التدريب المسبق للنماذج الأصغر بدلًا من تكبيرها فحسب. ومن الأمثلة Chinchilla وUL2، اللذان أظهرا أن الحجم الأكبر ليس أفضل دائمًا، وأن الاستراتيجيات الأذكى قد تحقق نتائج فعالة أيضًا. كما حظي ضبط النماذج اللغوية باستخدام التعليمات باهتمام كبير، وأسهمت مشاريع مثل FLAN وT0 وFlan-T5 في هذا المجال.
مُحفز تشات جبت
مثّل إطلاق OpenAI لـتشات جبت نقطة تحول في أبحاث معالجة اللغة الطبيعية. للتنافس مع OpenAI، أطلقت شركات مثل Google (GOOGL ) وAnthropic نماذجها الخاصة، Bard وClaude، على التوالي. بينما تظهر هذه النماذج أداءً قابلاً للمقارنة مع تشات جبت في العديد من المهام، لا تزال متأخرة عن أحدث نموذج من OpenAI، GPT-4. يُعزى نجاح هذه النماذج بشكل رئيسي إلى تقنية التعلم المعزز من التغذية الراجعة البشرية (RLHF)، وهي تقنية تلقى تركيزًا بحثيًا متزايدًا لتحسينها.
شائعات وتكهنات حول Q\* (نجم Q) من OpenAI
التقارير الحديثة تشير إلى أن الباحثين في OpenAI قد حققوا تقدمًا كبيرًا في الذكاء الاصطناعي من خلال تطوير نموذج جديد يسمى Q\* (يُلفظ Q نجم). يُزعم أن Q\* لديها القدرة على أداء حسابات على مستوى المدرسة الابتدائية، وهو إنجاز أثار مناقشات بين الخبراء حول إمكاناته كخطوة نحو الذكاء الاصطناعي العام (AGI). على الرغم من أن OpenAI لم تعلق على هذه التقارير، إلا أن القدرات المزعومة ل Q\* أثارت حماسة وتكهنات كبيرة على وسائل التواصل الاجتماعي وبين محبي الذكاء الاصطناعي.
تطوير Q\* ملحوظ لأن النماذج الحالية مثل تشات جبت وGPT-4، على الرغم من قدراتها على بعض المهام الرياضية، ليست قادرة على التعامل معها بثبات. يكمن التحدي في أن النماذج لا تحتاج إلى التعرف على الأنماط فحسب، كما تفعل حاليًا من خلال التعلم العميق وبنى المحوّلات (Transformers)، بل تحتاج أيضًا إلى الاستدلال وفهم المفاهيم المجردة. الرياضيات، كونه معيارًا للتفكير، تتطلب من الذكاء الاصطناعي التخطيط والتنفيذ الخطوات المتعددة، مما يظهر فهمًا عميقًا للمفاهيم المجردة. هذه القدرة ستمثل قفزة كبيرة في قدرات الذكاء الاصطناعي، وربما تمتد إلى ما وراء الرياضيات إلى مهام معقدة أخرى.
ومع ذلك، يحذر الخبراء من المبالغة في تقدير هذا التطور. فالنظام الذي يحل مسائل الرياضيات بصورة موثوقة سيكون إنجازًا مهمًا، لكنه لا يعني بالضرورة ظهور ذكاء اصطناعي فائق أو ذكاء اصطناعي عام. وقد ركزت الأبحاث القائمة، بما فيها جهود OpenAI، على مسائل أولية، مع درجات متفاوتة من النجاح في المهام الأكثر تعقيدًا.
وتتسع التطبيقات المحتملة لتطورات مثل Q* من التدريس المخصص إلى المساعدة في البحث العلمي والهندسة. لكن من المهم ضبط التوقعات والإقرار بالقيود ومخاوف السلامة. وتظل المخاوف من المخاطر الوجودية للذكاء الاصطناعي، وهي من الشواغل الأساسية لدى OpenAI، مهمة، خصوصًا مع ازدياد تفاعل هذه الأنظمة مع العالم الحقيقي.
حركة LLMs المفتوحة المصدر
لدعم البحث في نماذج LLMs المفتوحة المصدر، أصدرت Meta سلسلة نماذج Llama، مما أدى إلى موجة جديدة من التطورات القائمة على Llama. تشمل هذه النماذج مثل Alpaca وVicuna وLima وWizardLM، والتي تم تحسينها مع بيانات التعليمات. كما أن البحث يتفرع إلى تعزيز قدرات الوكيل والاستدلال المنطقي ونمذجة السياق الطويل داخل إطار Llama.
كذلك يتزايد الاتجاه إلى تطوير نماذج لغوية كبيرة قوية من الصفر، مثل MPT وFalcon وXGen وPhi وBaichuan وMistral وGrok وYi. وتعكس هذه الجهود التزامًا بإتاحة قدرات النماذج المغلقة على نطاق أوسع، وجعل أدوات الذكاء الاصطناعي المتقدمة أكثر سهولة في الوصول وأكثر كفاءة.
تأثير تشات جبت والنماذج المفتوحة المصدر على الرعاية الصحية
نحن ننظر إلى مستقبل حيث تساعد النماذج LLMs في كتابة الملاحظات السريرية وملء الاستمارات للتعويضات ودعم الأطباء في التشخيص وتخطيط العلاج. لقد لفتت هذه التطورات انتباه كلاً من العمالقة التكنولوجية ومؤسسات الرعاية الصحية.
مناقشات Microsoft مع Epic، وهي شركة رائدة في برامج سجلات الصحة الإلكترونية، تشير إلى دمج النماذج LLMs في الرعاية الصحية. هناك مبادرات قيد التنفيذ في UC San Diego Health وStanford University Medical Center. وبالمثل، شراكات Google مع Mayo Clinic وإطلاق Amazon Web Services لخدمة HealthScribe للتوثيق السريري بالذكاء الاصطناعي تحدد خطوات كبيرة في هذا الاتجاه.
ومع ذلك، تثير هذه التطورات السريعة مخاوف حول تسليم السيطرة على الطب للشركات. طبيعة النماذج LLMs المملوكة تجعل من الصعب تقييمها. تعديلها أو إيقافها لأسباب ربحية يمكن أن يضعف رعاية المرضى والخصوصية والأمان.
الاحتياج الملح هو لمقاربة مفتوحة وشاملة لتطوير النماذج LLMs في الرعاية الصحية. يجب على مؤسسات الرعاية الصحية والباحثين والأطباء والمرضى التعاون على المستوى العالمي لبناء نماذج LLMs مفتوحة المصدر للرعاية الصحية. هذا النهج، مشابه لاتحاد التريليون معامل (Trillion Parameter Consortium)، سيمكن من تجميع الموارد الحاسوبية والمالية والخبرات.





