
أساسيات الذكاء الاصطناعي
ما هو التعرف على الكلام الحواري (CSR)؟

 أضف Unite.AI إلى مصادرك المفضلة على Google
يمتد التعرف على الكلام الحواري (CSR) إلى ما وراء التعرف التلقائي على الكلام التقليدي عبر استخدام سياق الحوار، وإشارات تبادل الأدوار، ومعلومات المتحدث، ومعالجة منخفضة الكمون. الهدف هو دعم تفاعل حي حيث تكون الكلمات، والتوقيت، والمقاطعات، والحوارات السابقة كلها ذات أهمية.
يُعد CSR علامة تجارية ومنتجًا بحثيًا ناشئًا، وليس فئة نماذج موحدة واحدة. يجمع النظام القوي بين التعرف التلقائي على الكلام المتدفق مع تحديد نقاط النهاية، ومعالجة المتحدثين، ونمذجة اللغة السياقية، وحالة الحوار، وسياسة الاستجابة، ثم يقيم التجربة من البداية إلى النهاية.
النقاط الرئيسية
- التعرف المتدفق يصدر فرضيات مؤقتة ويُعيد تعديلها مع وصول المزيد من الصوت.
- تحديد نقاط النهاية وتنبؤ الأدوار منفصلان عن دقة النسخ.
- تاريخ المحادثة والكلمات المفتاحية يمكن أن يحسّنوا التعرف لكنه أيضًا قد يكرّر الأخطاء السابقة.
- قيّم الكمون، المقاطعات، المتحدثين، اللهجات، الضوضاء، الخصوصية، وإكمال المهمة — وليس معدل خطأ الكلمات وحده.
من التعرف التلقائي إلى الحوار الحي
يقوم الـ ASR التقليدي بتحويل الصوت إلى نص. يجب على النظام الحواري أن يقرر متى يستمع، ومتى يكتمل الدور، وما إذا كان الكلام موجهًا إلى النظام، وكيفية الاستعادة عندما يكون النص أو الاستجابة خاطئة.
تعالج النماذج المتدفقة الإطارات تدريجيًا وتنتج نصوصًا جزئية. يُحسّن الكمون المنخفض الاستجابة، لكن الالتزام المبكر قد يزيد من المراجعات أو الأخطاء. تحتاج التطبيقات إلى سياسة لتحديد النص المستقر مقابل النص المؤقت.
تبادل الأدوار، التداخل، والمتحدثون
مدة الصمت وحدها إشارة ضعيفة لنقطة النهاية. يمكن لإكمال الكلمات، والتنغيم، والتوقيت، ونظرة العين، وحالة الحوار أن تساعد في التنبؤ ما إذا كان الشخص يحتفظ بالدور أو يتركه. يسمح الإدخال الفوري (Barge‑in) للمستخدم بمقاطعة الكلام المُصنّع دون فقدان السياق.
تظل الأصوات المتداخلة وتحديد المتحدثين (diarization) صعبة. ينبغي للأنظمة الحفاظ على عدم اليقين بشأن المتحدث، وتجنب نسب العبارة إلى الشخص الخطأ، وتوفير مسار تصحيح — خصوصًا للسجلات المستخدمة في الرعاية الصحية أو المالية أو الأعمال القانونية.
التعرف السياقي
يمكن للدورات السابقة توضيح الأسماء والإشارات؛ كما يمكن لقوائم الكلمات المفتاحية توجيه التعرف نحو مصطلحات المجال. قد تُشفر نماذج الكلام واللغة السياق الصوتي والنصي في إطار مشترك من التحفيز أو الانتباه.
يمكن للسياق أيضًا تعزيز نسخة سابقة خاطئة أو تسريب معلومات بين الجلسات. حدِّد السجل إلى الغرض الحالي، وافصل البيانات الوصفية الموثوقة عن كلام المستخدم، واستخدم سياق transformer مع قواعد صريحة للاحتفاظ والوصول.
التقييم والنشر المسؤول
قُم بالإبلاغ عن معدل خطأ الكلمات المتدفقة، وكمون أول رمز (first-token) والإنهاء، ومعدل المراجعات، وأخطاء نقاط النهاية، ونجاح الإدخال الفوري، ونسب attribution المتحدث، وإكمال المهمة. اختبر الميكروفونات الحقيقية، والضوضاء، واللهجات، وتبديل اللغات، والإعاقات، والكلام المشحون عاطفيًا.
يمكن لبيانات الصوت أن تُعرّف أو تكشف معلومات حساسة. طبق موافقة المستخدم، وتقليل البيانات، والتشفير، وحدود الاحتفاظ، والمراجعة البشرية. اربط الردود المولدة بضوابط أمان chatbot، لأن النسخ الدقيق لا يجعل الاستجابة صحيحة أو مخوَّلة.
من الإدخال الصوتي إلى حالة الحوار
يقوم نظام الكلام الحواري بالتقاط الصوت، وتطبيق تكييف الإشارة، واكتشاف الكلام، والتعرف على الكلمات أو الوحدات الدلالية، وتحديد المتحدثين عند الحاجة، وتحديث حالة الحوار. تُنتج الأنظمة المتدفقة فرضيات جزئية قبل انتهاء النطق. يمكن أن تتغير هذه الفرضيات، لذا يجب على المكوّنات اللاحقة التمييز بين النتائج المؤقتة والنهائية.
تحدد كشف نشاط الصوت وتحديد نقاط النهاية متى يبدأ الكلام ومتى ينتهي المستخدم. تفشل حدود الصمت الثابتة مع المتحدثين البطيئين، والضوضاء الخلفية، وفترات التفكير. يمكن لنماذج تبادل الأدوار استخدام الكلمات، والتنغيم، ونظرة العين، وسياق الحوار، لكن يجب موازنة الاستجابة السريعة مع قطع المتحدث.
تُجيب عملية تحديد المتحدث (diarization) عن سؤال من تحدث ومتى؛ وتقدّر تقنية التعرف على المتحدث الهوية؛ وتفصل تقنية فصل المصدر الأصوات المتداخلة. هذه مهام مختلفة ذات مخاطر مختلفة. في الاجتماعات والرعاية الصحية وخدمة العملاء، قد يكون نسب الكلمات الصحيحة إلى الشخص الصحيح مهمًا بقدر معدل خطأ الكلمات في النسخ.
السياق، التداخل، العاطفة، واستعادة التفاعل
يُحلّ السياق الحواري الضمائر، والإغلاقات، والتصحيحات، ومصطلحات المجال، والإشارات إلى الأدوار السابقة. يمكن للنظام دمج الأدلة الصوتية مع تاريخ الحوار والمعرفة المسترجعة، لكن السياق السابق قد يُحرف التعرف نحو توقع غير صحيح. احفظ الأدلة الصوتية ومستوى الثقة حتى لا يطيح السياق بالشكوك بصمت.
يتضمن الحوار الطبيعي القنوات الخلفية، والمقاطعات، والبدايات الخاطئة، والضحك، وتبديل اللغات، والكلام المتزامن. يحتاج الوكيل المتجاوب إلى معالجة الإدخال الفوري: إيقاف أو خفض مخرجاته، التقاط الكلام الجديد للمستخدم، تحديد ما إذا كانت المقاطعة تغير النية، والاستعادة دون تكرار أو فقدان إجراء.
يمكن للتنغيم والإشارات شبه اللغوية أن تدل على التشديد أو عدم اليقين، لكن استنتاج العاطفة أو الصحة أو النية من الصوت عرضة للأخطاء وتعتمد على الثقافة. استخدم هذه التقديرات بحذر، وكشفها عند الحاجة، ولا تتخذ قرارات هامة بناءً على تصنيف عاطفي غير موثوق.
التقييم، الخصوصية، وتصميم الإنتاج
يظل معدل خطأ الكلمات مفيدًا، لكن تقييم الحوار يجب أن يقيس أيضًا نسب attribution المتحدث، ودقة الكيانات، ونجاح المهمة الدلالية، واستقرار الفرضيات الجزئية، وكمون نقطة النهاية، ونجاح المقاطعة، والاستعادة، ومعدل تصحيح المستخدم. قسّم حسب اللهجة، واللغة، والجهاز، والضوضاء، والتداخل، وأسلوب الكلام، وظروف الشبكة.
تحتاج بنية البث المتدفقة إلى مخازن محدودة، وضغط عكسي، وإعادة اتصال، وأرقام تسلسلية، وإنهاء صريح. حافظ على ميزانيات الكمون للنموذج والحوار منفصلة، وتعقّب كل مرحلة، واختبر الشبكات المتدهورة. عندما يطلق النظام إجراءات، أكّد النية ذات الأثر العالي واجعل عمليات إعادة المحاولة متطابقة لتجنب تكرار المعاملات بسبب الصوت المتكرر أو إعادة الاتصال.
يحتوي الكلام على هوية، ومحتوى، وبيئة، ومعلومات المتفرجين. قلل من الاحتفاظ، وشفّر النقل والتخزين، وتحكم في الوصول، وحدد الحذف، وفرق بين الصوت والنصوص المستخرجة والتمثيلات. قدم مؤشرات تسجيل مرئية وبدائل عندما لا يتوفر موافقة. يمكن للنموذج المحلي تقليل النقل لكنه لا يزال يتطلب إذنًا وضوابط دورة الحياة.
مثال عملي: وكيل صوتي يتعامل مع المقاطعة والتصحيح
يقول المتصل: ‘احجز يوم الثلاثاء — لا، الأربعاء بعد الظهر’، بينما يبدأ الوكيل بالاستجابة بعد كلمة ‘الثلاثاء’. يُصدر التعرف المتدفق نصوصًا جزئية متغيرة، وتكشف نقطة النهاية عن استمرار الكلام، ويتوقف الإخراج بفضل الإدخال الفوري. تُعلم حالة الحوار أن التاريخ السابق قد تم استبداله بدلاً من إنشاء طلبين. يركز تأكيد الكيان على التاريخ والوقت المصححين، بينما يحتفظ النظام بالثقة والأدلة للتفسير النهائي.
تفصل البنية التقاط الصوت، واكتشاف الكلام، والتعرف المتدفق، ومعالجة المتحدث، وسياسة الحوار، وتنفيذ الأداة، والتوليف. تمنع أرقام التسلسل والإنهاء النتائج الجزئية المتأخرة من الكتابة فوق النص النهائي. تقبل أداة الحجز طلبًا منسقًا، وتتحقق من التفويض والتوافر، وتستخدم مفتاحًا للتماثل (idempotency). يُقرأ الحجز المتبع ويُؤكد قبل التنفيذ؛ ولا يمكن لإعادة الاتصال أن تكرره بصمت.
يجمع الاختبار بين دقة الكلمات والكيانات مع كمون نقطة النهاية، ونجاح المقاطعة، ومعالجة التصحيح، ونسب attribution المتحدث، وإكمال المهمة، ومعدل تكرار الإجراءات. تغطي السيناريوهات الضوضاء، والتداخل، واللهجات، وتبديل اللغات، والكلام البطيء، والأجهزة المساعدة، والشبكات الضعيفة، والهجمات الاصطناعية. يُقلل الاحتفاظ بالصوت ويُفصح عنه، وتُعالج بيانات المتفرجين صراحة، ويمكن للمستخدمين التحول إلى النص أو إلى إنسان. تُقاس الذكاء الحواري بالاستعادة الآمنة والنتيجة، وليس بدقة النسخ وحدها.
قائمة التحقق العملية للتنفيذ
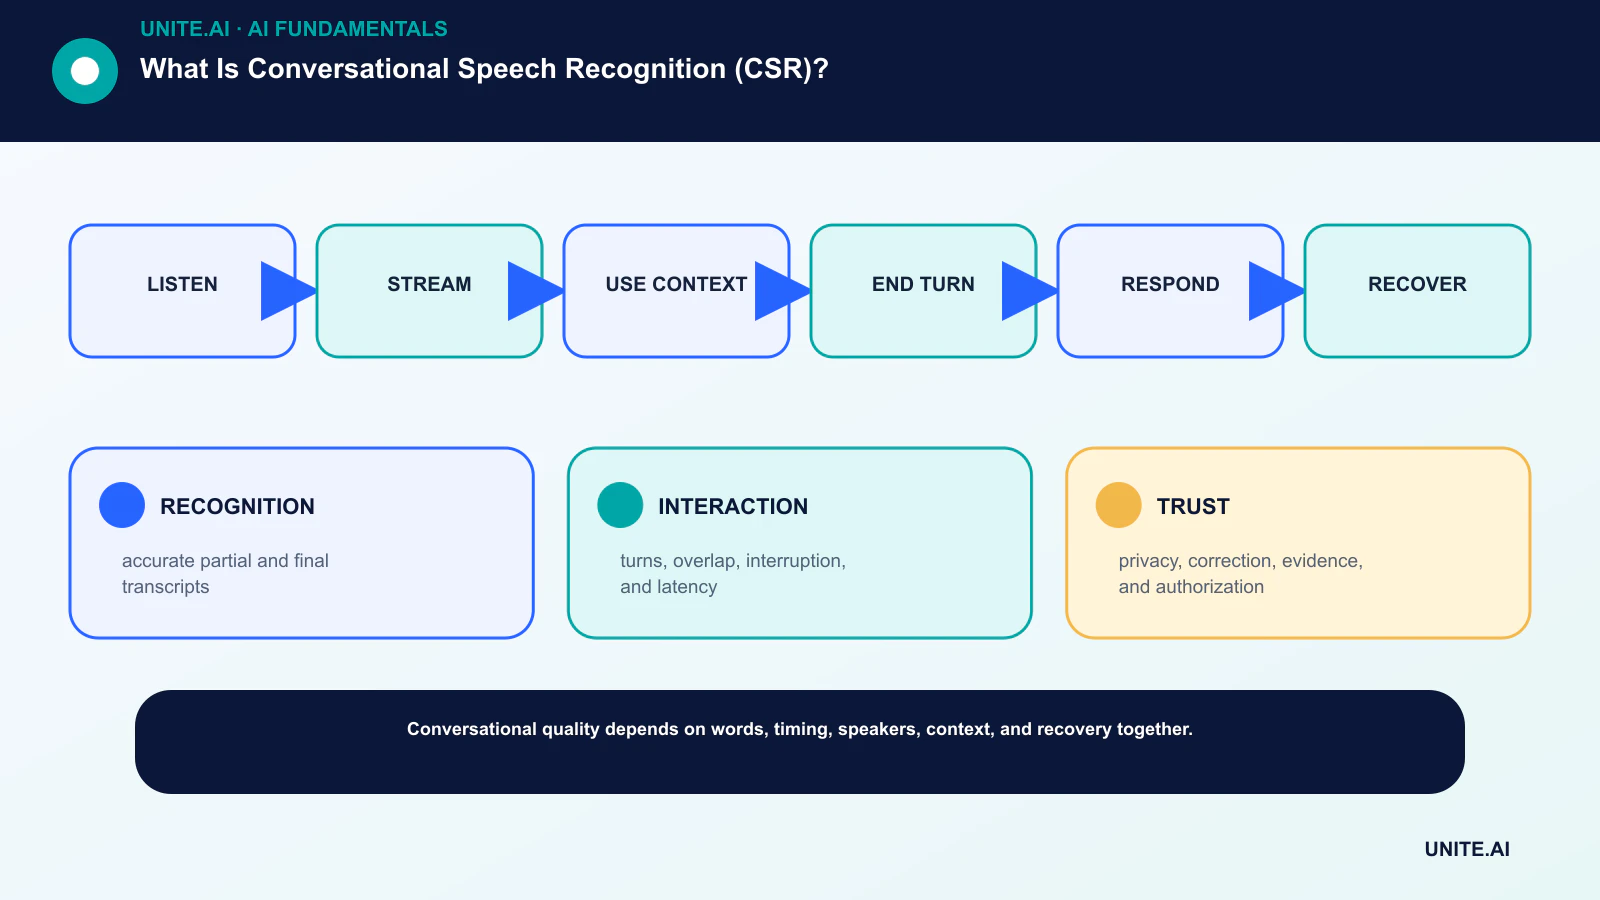
حوّل الفكرة إلى سير عمل محدود وقابل للاختبار: استمع → تدفق → استخدم السياق → أنهِ الدور → استجب → استعد. عيّن مالكًا مسؤولًا، وثّق البيانات والاعتمادات، وضع أساسًا بسيطًا، حدد معايير القبول والإيقاف، اختبر حالات الفشل النموذجية، وعَرِّف المراقبة والعودة للنسخة السابقة والمراجعة قبل توسيع النطاق. سجِّل الإصدارات والافتراضات حتى يتمكن فريق آخر من إعادة إنتاج النتيجة وفهم ما تغير.
قبل الإطلاق، أجرِ مراجعة جاهزية موثقة مع الأشخاص الذين يبنون، ويشغلون، ويؤمنون، ويتأثرون بالنظام. اختبر الحالات العادية، وظروف الحدّ، وأعطال الاعتمادات، وسوء الاستخدام؛ احفظ الأدلة والمخاطر غير المحلولة. عرّف من يمكنه الموافقة على الإصدار، وتغيير عتبة، وتجاوز مخرجات، أو إيقاف التشغيل. أعد النظر في القرار بعد وصول بيانات العالم الحقيقي، لأن تجربة ناجحة تقنياً لا تضمن أداءً موثوقًا على نطاق أوسع.
- التعرّف: نصوص جزئية ونهائية دقيقة.
- التفاعل: الأدوار، التداخل، المقاطعة، والكمون.
- الثقة: الخصوصية، التصحيح، الأدلة، والتفويض.
الأسئلة المتكررة
هل CSR مختلف عن ASR؟
ASR هو مكوّن تحويل الكلام إلى نص. يستخدم CSR الـ ASR بالإضافة إلى سياق الحوار، والتوقيت، ومعالجة المتحدث ونقطة النهاية، وسياسات التفاعل للمحادثة الحية.
هل معدل خطأ الكلمات الأقل يضمن وكيل صوتي أفضل؟
لا. قد ينسخ النظام بدقة لكنه قد يقاطع المستخدمين، أو يرد ببطء، أو يخطئ في نسب المتحدثين، أو يتخذ الإجراء الخاطئ. يلزم مقاييس تفاعل شاملة من الطرف إلى الطرف.
المراجع الأساسية












