
Yapay zeka temelleri
NPU Nedir? Sinir İşleme Birimleri Açıklaması

 Unite.AI sitesini Google'daki tercih ettiğiniz kaynaklara ekleyin
Bir sinir işleme birimi (NPU), yaygın sinir ağı işlemlerini verimli bir şekilde yürütmek üzere tasarlanmış özel bir hızlandırıcıdır. Telefonlarda, bilgisayarlarda, araçlarda, kameralarda ve gömülü sistemlerde, desteklenen AI iş yüklerini daha az enerjiyle çalıştırabilir veya CPU ve GPU’yu diğer görevler için serbest bırakabilir.
NPU, tek bir evrensel mimariden ziyade geniş bir endüstri terimidir. Performans, desteklenen operatörler, sayısal formatlar, bellek, derleyici ve çalışma zamanı, termal sınırlar ve bir uygulamanın ne kadarının hızlandırıcıda kalabildiğine bağlıdır.
Temel Çıkarımlar
- NPUs, yüksek veri yeniden kullanımını ve düşük güç tüketimini sağlayan matris, vektör ve tensör işlemlerine odaklanır.
- Maksimum TOPS, uçtan uca bir uygulama ölçütü değildir ve belirli bir hassasiyet ya da seyrekliği varsayabilir.
- Bir model, desteklenmeyen işlemler için dönüşüm, kantitleştirme, grafik bölümlendirme ve geri dönüşüm (fallback) gerektirebilir.
- Gerçek iş yükü üzerinde gecikme, verim, enerji, bellek, kalite, gizlilik ve taşınabilirliği karşılaştırın.
CPU, GPU ve NPU rolleri
CPU’lar genel kontrol akışı ve geniş uyumlulukta üstün performans gösterir. GPU’lar programlanabilir paralel verim ve büyük bir yazılım ekosistemi sunar. NPU’lar tekrarlanan tensör işlemlerinde uzmanlaşır ve yerel bellek, çarpma‑toplama dizileri ve çıkarım (inference) için optimize edilmiş veri akışı içerebilir.
Heterojen sistemler, farklı bölümleri en uygun yerlere göre zamanlar. Bu, kenar AI için önemlidir; burada sürekli güç ve yanıt süresi, veri merkezi tepe veriminden daha önemli olabilir.
Model derleme ve yürütme
Bir çerçeve grafiği ara bir temsile dönüştürülür, optimize edilir, uygun olduğunda kantitleştirilir ve desteklenen operatörler için derlenir. Çalışma zamanı, desteklenmeyen katmanların CPU veya GPU’da yürütülmesi için grafiği bölümlendirebilir.
İşlemciler arasındaki veri transferleri, hızlandırıcı kazançlarını ortadan kaldırabilir. Statik şekiller, düzen, hassasiyet, toplu işleme ve bellek yeniden kullanımı performansı etkiler. Derlenmiş artefakti test edin; çünkü derin öğrenme modeli kalitesi dönüşümden sonra değişebilir.
TOPS ve verimlilik iddialarını anlayın
TOPS, tanımlı varsayımlar altında saniyede trilyonlarca işlem raporlar. Satıcılar çarpma ve toplama işlemlerini ayrı sayabilir, düşük bitli tam sayı hassasiyeti kullanabilir veya seyrekliği varsayabilir. Daha yüksek bir sayı, belirli bir model için daha düşük gecikme garantilemez.
Soğuk ve sıcak başlangıç, sorgu başına gecikme, verim, enerji, en yüksek bellek, termal kısıtlama, desteklenen bağlam veya görüntü boyutu ve hızlandırılan grafik oranını ölçün. Eşdeğer doğruluk ve yazılım sürümlerini kullanın.
Cihaz içi AI tavizleri
Yerel yürütme, ağ bağımlılığını azaltabilir ve ham girdileri cihazda tutabilir, ancak indirilen modeller, günlükler, yedeklemeler ve bulut geri dönüşleri hâlâ veri akışları oluşturur. Güvenli model teslimi ve platform güncellemeleri hâlâ gereklidir.
NPU’lar, TinyML-yanı iş yükleri dahil olmak üzere görsel, ses, dil ve sensör uygulamalarını destekleyebilir. Geliştiriciler, sorunsuz bir geri dönüş (fallback) tasarlamalı ve işleme cihaz dışına çıktığında bunu bildirmelidir.
NPU mimarisi ve desteklenen işlemler
Bir NPU, çarpma‑toplama birimlerinin dizileri, yerel bellek, veri akışı zamanlaması ve özel sayısal formatlar kullanarak tensör işlemlerini hızlandırır. Ağırlık ve aktivasyonları hesaplamaya yakın tutmak pahalı veri hareketini azaltır. Gerçek cihazlar, operatör desteği, bellek hiyerarşisi, hassasiyet, seyreklik, programlanabilirlik ve işin CPU ve GPU ile nasıl paylaşıldığı konusunda farklılık gösterir.
Maksimum performans genellikle TOPS cinsinden reklam edilir, ancak TOPS hassasiyet, kullanım oranı, bellek sınırları, operatör kapsamı veya uçtan uca gecikmeyi belirtmez. Aynı başlık sayısına sahip iki işlemci aynı modelde farklı performans gösterebilir. Derlenmiş modeli, gerçekçi toplu ve dizi boyutlarını, ön işleme, transferleri ve güç modunu benchmark edin.
NPU’lar, görsel, ses, gürültü azaltma, arka plan efektleri ve kompakt dil modelleri gibi desteklenen sinir iş yükleri için etkilidir. Desteklenmeyen operatörler CPU veya GPU’ya geri dönebilir, bu da transferler ve öngörülemeyen gecikmeler oluşturur. Tüm grafiğin hızlandırıcıyı kullandığını varsaymak yerine, konumlandırmayı doğrulamak için derleyici raporlarını ve çalışma zamanı izlerini inceleyin.
Model dönüştürme, kantitleştirme ve dağıtım
Dağıtım genellikle bir eğitim çerçevesinden dışa aktarım, grafik optimizasyonu, kantitleştirme, satıcı derlemesi ve çalışma zamanı entegrasyonuna geçer. Statik şekiller ve yaygın operatörler hızlandırılması en kolay olanlardır. Dinamik kontrol akışı, özel çekirdekler, büyük ara tensörler ve desteklenmeyen normalizasyon ya da dikkat desenleri grafik değişiklikleri veya hibrit yürütme gerektirebilir.
Tam sayı ve daha düşük hassasiyetli formatlar model boyutunu, bant genişliğini, enerjiyi ve gecikmeyi azaltır, ancak kalibrasyon verileri gerçek girdileri temsil etmelidir. Kalite hassas olduğunda, eğitim sonrası kantitleştirme ile kantitleme‑bilinçli eğitimi karşılaştırın. Ortalama doğruluk, nadir veya güvenlik açısından kritik durumlarda bozulmayı gizleyebileceği için sınıf bazında ve en kötü durum davranışını değerlendirin.
Cihaz içi çıkarım, veri transferini sınırlayarak gecikmeyi, çevrim dışı çalışmayı ve gizliliği iyileştirir, ancak cihaz hâlâ güvenli modellere, izin‑bilinçli veri erişimine ve güncelleme mekanizmalarına ihtiyaç duyar. Model dosyalarını gerektiği yerde koruyun, güncellemeleri imzalayın, bulut geri dönüşünü açıklayın ve telemetrinin, yerel mimarinin azaltmayı amaçladığı gizlilik açığının yeniden ortaya çıkmasına neden olmadığından emin olun.
Performans değerlendirmesi ve sistem‑seviyesi tavizler
Soğuk başlangıç ve kararlı durum gecikmesi, verim, çıkarım başına enerji, bellek, termal davranış, doğruluk ve pil etkisini ölçün. Uzun testler, kısa benchmarkların kaçırdığı kısıtlamaları ortaya çıkarır. Yeniden boyutlandırma, tokenleştirme, kod çözme veya veri kopyaları gibi ön ve son işleme adımlarını dahil edin; çünkü bunlar, aksi takdirde hızlı bir hızlandırıcıyı bile domine edebilir.
Zamanlama bir sistem sorunudur. CPU uygulama mantığını yönetir, GPU desteklenmeyen katmanları render edebilir veya çalıştırabilir ve NPU uyumlu grafikleri yürütür. Aynı anda çalışan kamera, ses, ekran ve AI iş yükleri bellek bant genişliği ve güç için rekabet eder. Satıcı aracında izole bir model yerine tam kullanıcı senaryosunu test edin.
Taşınabilirlik, derleyiciler ve çalışma zamanları arasında sınırlı kalır. Çalıştığı yerlerde standart model temsillerini tercih edin, satıcı‑özel kodu arabirimlerin arkasına izole edin, referans çıktıları koruyun ve cihaz test kapsamını sürdürün. Donanımı, doğrulanmış iş yükleri, yazılım desteği, güncelleme ufku ve toplam sistem maliyeti temelinde seçin; tek bir hızlandırıcı özelliklerine göre değil.
Uygulamalı örnek: bir NPU dizüstü bilgisayara görsel model dağıtma
Bir ekip, arka plan efektleri için bir segmentasyon modeli eğitir, bunu desteklenen bir değişim formatına dışa aktarır, desteklenmeyen operatörleri değiştirir ve temsilci kamera, aydınlatma, cilt tonları, kıyafet ve arka planlarla tam sayı kantitleştirmesini kalibre eder. Satıcı derleyicisi, hangi düğümlerin NPU’da çalıştığını ve hangilerinin geri döndüğünü raporlar. Ekip, herhangi bir geri dönüş geçişini sistem maliyeti olarak değerlendirir; çünkü tensör transferleri hızlı bir tekil çekirdeği bile domine edebilir.
Benchmarking, gerçek bir video görüşmesi sırasında kamera ön işleme, model yürütme, birleştirme, bellek, soğuk başlangıç, kararlı durum gecikmesi, kare stabilitesi, güç ve termal kısıtlamayı ölçer. Sonuçlar, aynı çıktı kalitesinde CPU ve GPU yollarıyla karşılaştırılır. Uygulama, sürücü güncellemesinden sonra hızlandırıcının var olduğunu ya da aynı grafiği desteklediğini varsaymak yerine yetenek algılaması ve test edilmiş bir geri dönüş (fallback) kullanır.
Sürüm testi, cihaz modelleri, işletim sistemi ve sürücü sürümleri, eşzamanlı iş yükleri, pil modları ve hatalı girdileri kapsar. Model paketleri imzalanır ve sürümlendirilir; telemetri, gereksiz video toplamayarak performans ve hataları kaydeder. Ürün, işleme ne zaman cihazda kaldığını ve ne zaman bulut özelliklerinin kullanıldığını açıklar. NPU, izole bir TOPS ya da çekirdek benchmarkı elde etmek yerine gerçekçi kısıtlamalar altında tam deneyimi iyileştirerek yerini kazanır.
Pratik uygulama kontrol listesi
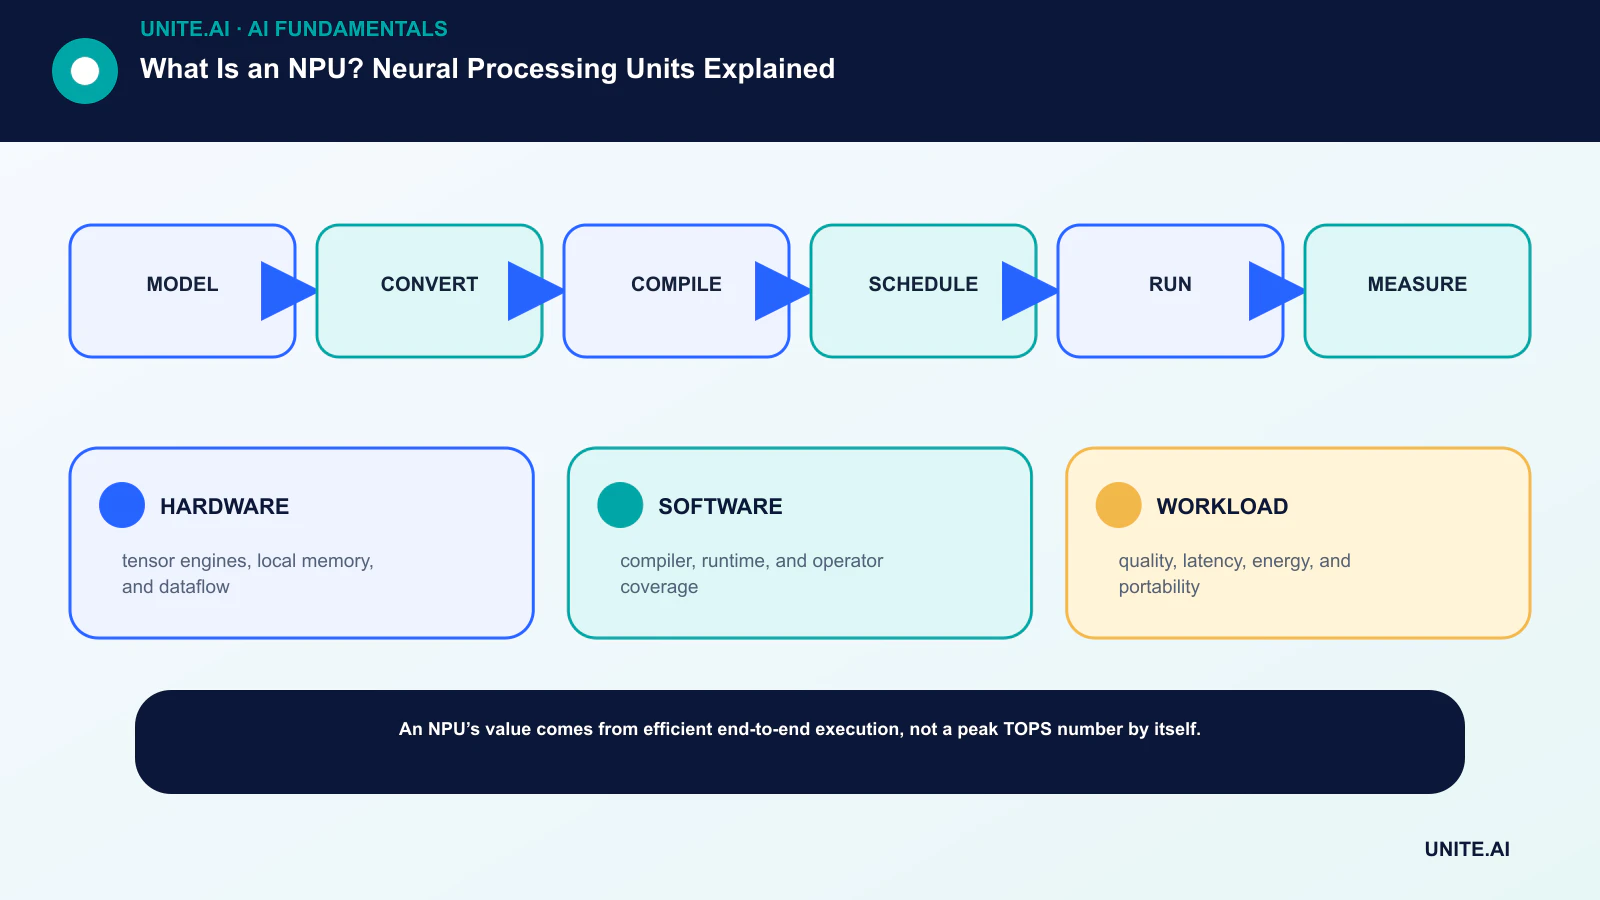
Kavramı sınırlı, test edilebilir bir iş akışına dönüştürün: model → dönüştür → derle → zamanla → çalıştır → ölç. Sorumlu bir sahibi belirleyin, verileri ve bağımlılıkları belgeleyin, basit bir temel çizgi oluşturun, kabul ve durdurma kriterlerini belirleyin, temsilci hataları test edin ve kapsamı genişletmeden önce izleme, geri alma ve inceleme tanımlayın. Başka bir ekibin sonucu yeniden üretebilmesi ve neyin değiştiğini anlayabilmesi için sürümleri ve varsayımları kaydedin.
Başlamadan önce, sistemi inşa eden, işleten, güvence altına alan ve etkileneni kapsayan kişilerle belgelenmiş bir hazırlık incelemesi yürütün. Normal durumları, sınır koşullarını, bağımlılık hatalarını ve kötü kullanımları test edin; kanıtları ve çözülemeyen riskleri koruyun. Kimin sürümü onaylayabileceğini, bir eşik değerini değiştirebileceğini, bir çıktıyı geçersiz kılabileceğini veya operasyonu durdurabileceğini tanımlayın. Gerçek dünya verileri geldiğinde kararı yeniden gözden geçirin; çünkü teknik olarak başarılı bir pilot, daha geniş ölçekte güvenilir performans garantilemez.
- HARDWARE: tensör motorları, yerel bellek ve veri akışı.
- SOFTWARE: derleyici, çalışma zamanı ve operatör kapsamı.
- WORKLOAD: kalite, gecikme, enerji ve taşınabilirlik.
Sıkça sorulan sorular
Bir NPU, bir GPU’dan daha hızlı mı?
Bu, modele, hassasiyete, operatör desteğine, toplu iş boyutuna, güç sınırına ve yazılıma bağlıdır. Bir NPU, desteklenen cihaz içi bir iş yükü için daha verimli olabilirken, bir GPU başka ortamlarda daha hızlı ya da daha esnek olabilir.
Bir NPU tüm AI verilerini gizli tutar mı?
Hayır. Yerel işleme olanak tanır, ancak uygulama hâlâ verileri veya çıktıları bulut hizmetlerine gönderebilir. Gizlilik, tam mimari ve politika bağlıdır.
Temel referanslar












