
En İyiler
En İyi 10 Yapay Zekâ Web Kazıma Aracı (Kasım 2026)

 Unite.AI sitesini Google'daki tercih ettiğiniz kaynaklara ekleyin
Unite.AI, incelediğimiz ürünlerin bağlantılarını kullandığınızda ücret alabilir. Bu, editoryal değerlendirmelerimizi etkilemez. Bağlı kuruluş açıklamamızı okuyun.
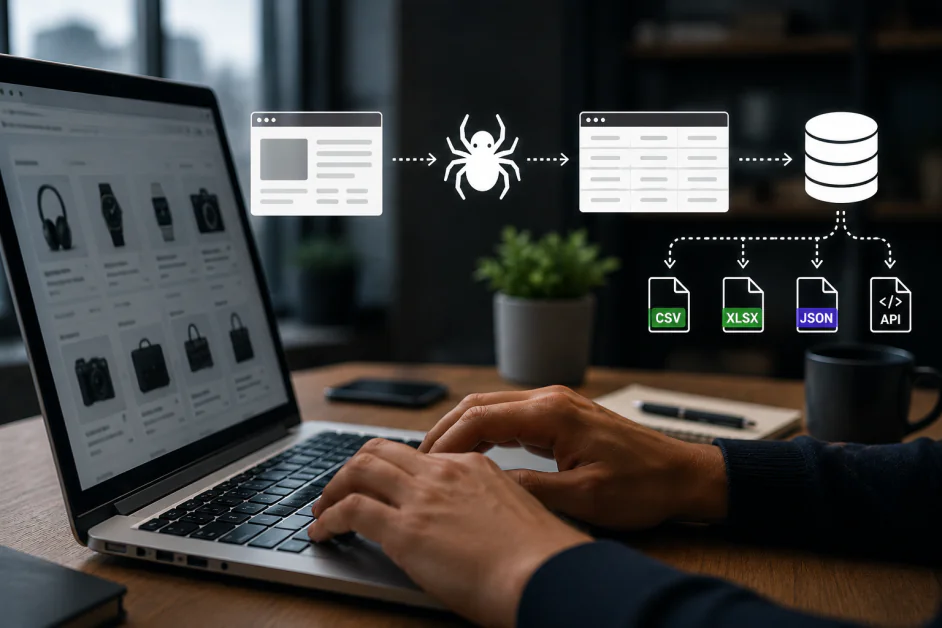
Öne çıkan noktalarKazıma aracını, tüm toplamayı tek bir sorun olarak ele almak yerine yükleme sonrası işe…
Daha fazla göster
- Kazıma aracını, tüm toplamayı tek bir sorun olarak ele almak yerine yükleme sonrası işe göre eşleştirin.
- İş akışı sahipliğini hem kaynak siteleri hem de gerekli çıktıyı anlayan kişilere atayın.
- Rendering ve proxy'ler toplamları şişirdiği için manşet istek sayıları yerine kullanılabilir kayıtlar için bütçe ayırın.
En iyi yapay zekâ web kazıma aracı, bir sayfa yüklendikten sonra ne yapmak istediğinize bağlıdır. Bir araştırma asistanı, okunabilir içeriğe ve kaynak bağlantılarına ihtiyaç duyar. Pazar istihbaratı sistemi, büyük ölçekte tutarlı kayıtlara ihtiyaç duyar. Etkileşimli bir ajan, birkaç adımda ilerleyebilen ve oturumunu açık tutabilen bir tarayıcıya ihtiyaç duyabilir.
Bu rehberde kurumsal veri toplama platformları, içerik API’leri, kod gerektirmeyen kazıma araçları, arama verisi hizmetleri ve yönetilen tarayıcılar dâhil, bu işlere yönelik on aracı ele alıyoruz. Her ürünün bilgileri nasıl topladığını, iş akışını kimin sürdürebileceğini ve bir prototip düzenli olarak tekrarlanan bir sürece dönüştüğünde önem kazanan ödünleşimleri değerlendiriyoruz.
Ekibimiz bu rehberdeki tüm çözümleri bağımsız olarak değerlendirdi; her birinin yeteneklerini, uygulamadaki güçlü yönlerini, sınırlamalarını ve sıralamamızda yansıtılan kullanım senaryolarına uygunluğunu inceledi.
En İyi Yapay Zekâ Web Kazıma Araçlarının Karşılaştırması
| Yapay Zekâ Aracı | En Uygun Olduğu Alan | Öne Çıkan Güçlü Yönleri |
|---|---|---|
| Bright Data | Kurumsal düzeyde veri toplama ve çeşitli veri akışları | Scraper API’leri, Browser API, Scraper Studio, veri kümeleri, proxy’ler |
| Firecrawl | Yapay zekâ uygulamalarına yönelik web içeriği | Arama, kazıma, haritalama, tarama, Markdown, JSON, etkileşim, MCP |
| Apify | Yeniden kullanılabilir kazıma işleri ve bulut orkestrasyonu | Actors, Crawlee, zamanlamalar, depolama, proxy’ler, API’ler, MCP |
| Browse AI | Kod gerektirmeyen veri toplama ve değişiklik izleme | Yapay zekâ destekli kurulum, robotlar, uyarılar, zamanlamalar, entegrasyonlar |
| SearchAPI | Yapılandırılmış arama sonuçları ve yerelleştirilmiş araştırma | Google, Haritalar, alışveriş, video, yapay zekâ destekli arama arayüzleri, JSON |
| Octoparse | Tekrarlanabilir bulut yürütme olanağı sunan görsel kazıma | Şablonlar, AI Assistant, otomatik algılama, bulutta çalıştırma, dışa aktarma |
| Browserless | Puppeteer ve Playwright için yönetilen tarayıcılar | Barındırılan tarayıcılar, kalıcı oturumlar, REST API’leri, MCP |
| ScrapingBee | Uygulama API’si üzerinden yönetilen veri çıkarma | Yapay zekâ destekli veri çıkarma, CSS/XPath, Markdown, JS senaryoları, MCP |
| Oxylabs | Zorlu herkese açık web sitelerinden yönetilen veri alma | Web API /Scrape, sayfa işleme, yapılandırılmış çıktı, MCP |
| Diffbot | Otomatik veri çıkarma ve varlık istihbaratı | Extract, standart şemalar, Crawl, Knowledge Graph |
Yapay Zekâ Web Kazıma Aracı Nasıl Seçilir?
Aracı yapacağınız işe göre seçin
Bir yapay zekâ bilgi tabanı için okunabilir metne, yapılandırılmış çıktıya ve kaynak URL’lerinin korunmasına öncelik verin. Tekrarlanabilir iş araştırmalarında görsel bir robot ve değişiklik uyarıları, programlama arayüzünden daha önemli olabilir. Etkileşimli bir ajan için oturum sürekliliğini ve tarayıcı denetimini göz önünde bulundurun. Arama sonucu API’leri farklı bir sorunu çözer: arama verilerini sağlarlar; bağlantı verilen sayfaları toplamak ise ayrı bir adımdır.
İş akışının sorumluluğunu kimin üstleneceğine karar verin
Kod gerektirmeyen bir platform, analistin veri çıkarma adımlarını doğrudan düzenlemesine olanak tanır. API, geliştiricilere veri toplamayı bir uygulamaya entegre etmek için kullanabilecekleri yalın bir arayüz sunar. Bulut tabanlı bir iş platformu zamanlama ve depolama özellikleri eklerken yönetilen bir tarayıcı, otomasyon mantığının daha büyük bölümünü ekibinize bırakır. Doğru seçim, bakım sorumluluğunu hem kaynak web sitelerini hem de gerekli çıktıyı anlayan kişilere verir.
Öne çıkan istek sayılarına değil, işe yarar kayıtlara göre bütçe ayırın
Tamamlanan bir işin maliyetini ihtiyaç duyduğunuz alanlarla karşılaştırın. Sayfa işleme, premium proxy’ler, tarayıcı kullanım süresi, yapay zekâ destekli veri çıkarma, depolama ve yeniden denemeler toplam maliyeti değiştirebilir. Ücretsiz kredi, tarayıcı birimi ve arama isteği farklı ölçütlerdir. Tekrarlanan işlerde başarılı yanıtların yanı sıra eksiksizlik, yinelenen kayıtlar, güncellik ve kullanılabilir kayıt başına maliyeti de takip edin.
En İyi 10 Yapay Zekâ Web Kazıma Aracı
1. Bright Data
Bright Data, tek bir platform üzerinden web verisi edinmek için birden fazla yönteme ihtiyaç duyan kuruluşlara yönelik genel önerimizdir. Ürün yelpazesinde kullanıma hazır Scraper API’leri, önceden toplanmış veri kümeleri, Scraper Studio, Web Unlocker ve proxy hizmetleri bulunur. Örneğin bir e-ticaret istihbaratı ekibi, tanınmış perakendeciler için yapılandırılmış veri akışlarından yararlanırken uzmanlaşmış bir pazaryeri için özel bir veri toplama sistemi kurabilir. Bu kapsam genişliği, veri programı tek bir web sitesinin veya departmanın ötesine geçtiğinde Bright Data’yı özellikle kullanışlı kılar.
Etkileşimli sayfalar için Browser API, geliştiricilerin Puppeteer, Playwright veya Selenium ile kontrol edebileceği tarayıcılar barındırır. Tarayıcıları çalıştırmayı proxy yönetimi ve CAPTCHA işlemleriyle bir araya getirirken Chrome DevTools desteği de mühendislerin sorunlu bir oturumu incelemesine yardımcı olur. Bu özellik, istenen bilgiye ulaşmadan önce gezinme veya sayfayla etkileşim kurmayı gerektiren iş akışlarında, mevcut bir veri kümesini yalnızca indirmeye kıyasla büyük kolaylık sağlar.
Temel ödünleşim, ürün seçimi ve maliyet yönetimidir. Tarayıcı trafiği, kazıma sonuçları ve veri kümesi satın alımları farklı iş yüklerini temsil eder; bu nedenle tek bir genel fiyat, platformun tamamını yansıtamaz. Bright Data, veri toplama kalitesinden, hedef kapsamından ve harcamalardan sorumlu bir kişinin bulunduğu ekipler için uygundur. Kapsamı dar bir proje, daha basit bir veri çıkarma API’siyle üretime daha hızlı geçebilir.
Avantajlar ve dezavantajlar
- Tek bir platformda geniş veri toplama seçenekleri
- Barındırılan tarayıcılar, yaygın otomasyon kütüphanelerini destekler
- Hazır API’ler ve veri kümeleri kurulumu hızlandırır
- Farklı ürünler için ayrı maliyet planlaması gerekir
- Özel işlem hatlarının sorumluluğunu yine mühendislik ekibi üstlenmelidir
2. Firecrawl
Firecrawl, web içeriğini bir yapay zekâ uygulaması için kullanışlı bağlama dönüştürmek isteyen geliştiriciler için ilk tercihimiz. Arama, kazıma, site haritalama ve tarama araçları, bir sayfayı keşfetmekten web sitesinin içeriğini toplamaya kadar gereken adımları kapsar. Markdown ve yapılandırılmış JSON da veriler alındıktan sonra yapılması gereken temizleme işlemlerini azaltır. Böylece bir araştırma asistanı veya bilgi tabanı ürünü, ham HTML’deki gezinme menülerini kaldırmaya daha az, soruları yanıtlamaya ise daha fazla zaman ayırabilir.
Firecrawl’ın mevcut Interact özelliği, platformun kapsamını canlı tarayıcı işlemlerini de içerecek şekilde genişletiyor. Ajanlar, eylemleri doğal dille tarif edebilir veya tarayıcı kodu çalıştırabilir, çağrılar arasında durumu koruyabilir ve kimlik doğrulaması yapılmış profilleri yeniden kullanabilir. Bu, veri çıkarılmadan önce tıklama, filtreleme veya oturum açma gerektiren sayfalar için önemli bir katkıdır. MCP ve komut satırı erişimi de Firecrawl’ı yalnızca geleneksel bir uygulama API’si olmaktan çıkarıp ajan geliştirme iş akışlarında kullanışlı hâle getiriyor.
Firecrawl, içerik ediniminin öncelikli sorun olduğu ve depolama ile erişim katmanlarının uygulama tarafından zaten yönetildiği durumlarda en iyi sonucu verir. Ekiplerin tarama sınırlarını belirlemesi, kaynak URL’lerini koruması ve eksik bir alanla boş bir alanı birbirinden ayırt etmesi yine gerekir. Açık kaynak kodu farklı bir dağıtım seçeneği sunsa da ekipler, barındırılan ve kendi yönettikleri sürümlerin aynı olduğunu varsaymak yerine seçtikleri dağıtımın belirli özelliklerini ve işletim gereksinimlerini değerlendirmelidir.
Avantajlar ve dezavantajlar
- Markdown ve JSON, yapay zekâ işlem hatları için uygundur
- Interact, durum bilgisini koruyan tarayıcı görevlerini destekler
- API, MCP ve CLI erişimi
- Alınan içeriğin yine de doğrulanması gerekir
- Kendi yönetilen dağıtımlar operasyonel çalışma gerektirir
3. Apify
Apify, yeniden kullanılabilir kazıma araçları ve bunları çalıştırabilecekleri bir platform arayan ekipler için burada en güçlü seçenektir. Pazaryeri, girdi alan, bulutta çalışan ve sonuç döndüren paketlenmiş programlar olan Actors’ı dağıtır. Hazır Actors yaygın veri toplama görevlerini hızlandırabilirken özel Actors, geliştiricilere kendi veri çıkarma mantıklarını koruma olanağı verir. Böylece Apify, bir deneme çalışmasını tekrarlanabilir bir üretim işine dönüştürmek için kullanışlı bir köprü görevi görür.
Platform; zamanlama, sonuçların depolanması, proxy erişimi, izleme ve entegrasyonlar gibi önemli operasyonel ihtiyaçları da karşılar. Geliştiriciler ayrıca Apify’ın açık kaynaklı tarama ve tarayıcı otomasyonu kütüphanesi Crawlee ile uygulama geliştirebilir. Apify’ın MCP sunucusu, Actors’ı yapay zekâ ajanlarının kullanımına açar. Böylece aynı paketlenmiş araç; her arayüz için ayrı bir kazıyıcı geliştirmek gerekmeden bir uygulamada, zamanlanmış bir işlem hattında veya asistanda kullanılabilir.
Actor seçimi, platform seçimi kadar dikkat gerektirir. Farklı yayıncıların sunduğu seçenekler fiyatlandırma, bakım, girdi seçenekleri ve çıktı kalitesi bakımından değişebilir. Bir işlemin başarıyla tamamlanması, beklenen tüm kayıtların toplandığı anlamına gelmez. Apify; işin şemasından sorumlu olan, değişiklikleri izleyen ve seçilen Actor ile altyapı kullanımının maliyetini bütçelendiren birinin bulunduğu durumlarda en cazip seçenektir. Tek bir sayfadan manuel veri çıkarmak için genellikle bu kadar kapsamlı bir düzenlemeye ihtiyaç yoktur.
Avantajlar ve dezavantajlar
- Hazır ve özel Actors aynı platformda kullanılabilir
- Zamanlama, depolama ve izleme, işlerin tekrarlanabilir biçimde yürütülmesini destekler
- MCP, Actors’ı ajan iş akışlarına taşır
- Actors’ın bakımı ve kalitesi değişkenlik gösterir
- Kullanım ve Actor ücretleri bütçelendirilmelidir
4. Browse AI
Browse AI, bir yazılım projesi geliştirmeden düzenli olarak web verisi toplamak isteyen işletme kullanıcılarına önerimizdir. Mevcut kurulum, sağlanan bir sayfayı okuyabilir, bir veri yapısı önerebilir ve kullanıcının alanları inceleyip düzenlemesine olanak tanır. Tekrarlanabilir veri çıkarma için robot eğitimi hâlâ merkezi önemdedir. Bu yaklaşım; ürün listelerini, dizin kayıtlarını veya rakip bilgilerini alışıldık tablolarda toplayan operasyon ve pazarlama ekipleri için pratiktir.
İzleme, özellikle güçlü olduğu alanlardan biridir. Robotlar sayfaları belirli aralıklarla kontrol edebilir, eklenen veya değişen öğeleri belirleyebilir ve nelerin değiştiğini açıklayan uyarılar gönderebilir. İş akışları, farklı sayfalardaki veri toplamayı birbirine bağlayabilir; API, webhook ve e-tablo entegrasyonları da sonuçların ekibin hâlihazırda kullandığı araçlara aktarılmasını sağlar. Böylece fiyat izleme iş akışı, manuel tarayıcı kontrolleri dizisi olmaktan çıkıp sürekli işleyen bir iş sürecine dönüşebilir.
Kullanım kolaylığı, verilerin açık biçimde tanımlanması gereğini ortadan kaldırmaz. Kullanıcılar hangi değişikliklerin uyarı gerektirdiğine karar vermeli; sayfalandırmanın, oturum açma adımlarının ve boş sonuçların doğru işlendiğini doğrulamalıdır. Büyük çaplı yeniden tasarımlar yine de müdahale gerektirebilir. Browse AI, bir iş ekibinin çıkarılan satırları inceleyip robotun bakımını yapabildiği durumlarda en iyi sonucu verir; tarayıcı mantığını sıkı sürüm kontrolüyle yönetmesi gereken geliştiriciler kod tabanlı bir hizmeti tercih edebilir.
Artıları ve Eksileri
- Yapay zekâ destekli alan kurulumu, kullanmaya başlamanın önündeki engelleri azaltır
- Zamanlanmış izleme, önemli değişiklikleri öne çıkarır
- E-tablo, API ve webhook bağlantıları
- Sitedeki büyük değişiklikler yeniden eğitim gerektirebilir
- Karmaşık mantık, dikkatli iş akışı tasarımı gerektirir
5. SearchAPI
SearchAPI, arama sonuçlarını yapılandırılmış veri olarak toplamak için uzmanlık alanına yönelik önerimizdir. Google API’si, değişen sonuç sayfaları için bir ayrıştırıcının bakımını yapma gereğini ortadan kaldırarak sonuç bağlantılarını ve arama özelliklerini JSON biçiminde sunabilir. Daha geniş kataloğunda Haritalar, alışveriş, haberler, videolar ve desteklenen yapay zekâ arama deneyimleri gibi kaynaklar yer alır. Keşif ve arama görünürlüğünün başka bir web sitesini taramaya giden bir ara adım değil, doğrudan veri ürünü olduğu durumlarda özellikle kullanışlıdır.
Yerelleştirme, bu kullanım amacına uygunluğun önemli bir parçasıdır. Konum, ülke, dil ve cihaz parametreleri, ekiplerin bir pazarı belirli bir arama bağlamında incelemesine olanak tanır. Bir SEO uygulaması, belirli bir şehirdeki bir sorguyu izleyebilir; bir araştırma asistanı da ilgili kaynakları bulup daha sonra erişmek üzere döndürülen bağlantıları saklayabilir. Arama ürünleri arasında kullanılabilir parametreler ve sonuç alanları farklılık gösterdiğinden, her motora özgü belgeler önem taşır.
SearchAPI, iş akışının gerçekten ihtiyaç duyduğu arama motorları ve alanlar için seçilmelidir. Arama sonucu, bağlantı verilen sayfanın tüm içeriğini sunmaz; ayrıca daha zengin sonuç görünümlerinin tümü aynı şemayı izlemez. Ekipler istek hacmini hesaba katmalı, aktarım hızı gereksinimlerini doğrulamalı ve eksik sonuç bölümlerini uygun şekilde ele almalıdır. İsteğe bağlı web sitesi verilerini çıkarmak veya etkileşimli bir tarayıcı oturumu yürütmek için bu kılavuzdaki başka bir araç daha iyi bir başlangıç noktasıdır.
Artıları ve Eksileri
- Yapılandırılmış sonuçlar, SERP ayrıştırıcısının bakımını gereksiz kılar
- Arama motorları ve ilişkili motorlardan oluşan geniş katalog
- Ayrıntılı yerelleştirme denetimleri
- Arama sonuçları, hedef sayfadaki verilerin çıkarılmasının yerini tutmaz
- Alanlar ve parametreler arama motoruna göre değişir
6. Octoparse
Octoparse, AI Copilot’ını ve insanın sürece dahil olduğu otomasyonu tanıtıyor. Video: Octoparse.
Octoparse, görsel bir arayüzde veri kazıyıcı tasarlayıp bunu tekrar tekrar çalıştırmak isteyen analistler için uygundur. Mevcut platformu hazır şablonlar, AI Assistant kurulumu ve masaüstü uygulamasında sayfaların otomatik algılanması özelliklerini sunar. Kullanıcılar, tarayıcı koduyla sıfırdan başlamak yerine ortaya çıkan görevi geliştirebilir. Bu esneklik; sayfalar arasındaki gezinme sırasının her sayfadaki alanlar kadar önemli olduğu ürün kataloglarını, dizinleri veya listeleri toplamak için yararlıdır.
Bulut üzerinde yürütme, kişisel bir bilgisayarı sürekli açık tutmaya gerek kalmadan hazırlanmış bir görevi yinelenen bir veri toplama sürecine dönüştürür. Zamanlama, paralel çalışma, IP rotasyonu ve dışa aktarma bağlantıları, daha büyük işlerin masaüstü prototipinin ötesine taşınmasına yardımcı olur. Görsel yaklaşım, kaynak web sitelerini ve veri gereksinimlerini bilen ancak özel bir tarayıcı otomasyon hizmetinin bakımını yapmak istemeyen ekiplere özellikle cazip gelir.
Octoparse, görevlerin dikkatle tasarlanmasını gerektirir. Sayfalandırma, sonsuz kaydırma, form adımları ve yinelenen kayıtlar, görünüşte başarılı bir çalıştırmanın anlamını değiştirebilir. Bulut kullanım hakları ve plan özellikleri, hedeflenen zamanlama ve hacimle uyumlu olmalıdır. Bir ekip, hızlı ve tek tıklamalı bir aracın sunduğundan daha fazla denetimle veri çıkarma adımlarını yönetmek istiyorsa ve kaynak sayfalar değiştiğinde görevi güncelleyebilecek belirli bir sorumlusu varsa Octoparse’ı öneririz.
Artıları ve Eksileri
- Şablonlar ve yapay zekâ desteği kurulumu kolaylaştırır
- Görsel düzenleme, ayrıntılı veri çıkarma görevlerini destekler
- Bulut üzerinde çalıştırma, zamanlanmış veri toplamayı destekler
- Karmaşık siteler görevlerin iyileştirilmesini gerektirir
- Bulut özellikleri seçilen plana bağlıdır
7. Browserless
Browserless, tarayıcıyı kontrol etmek isterken barındırma ve ölçeklendirme işlerini yönetilen bir hizmete bırakmayı tercih eden geliştiricilere önerimizdir. Mevcut Puppeteer veya Playwright betikleri uzak tarayıcılara bağlanabilir; bu da çalışan otomasyon koduna sahip projeler için Browserless’ı cazip bir seçenek hâline getirir. Bu özellik, özellikle veri toplama süreci birden fazla etkileşim içerdiğinde, JavaScript kullanımının yoğun olduğu bir arayüz söz konusu olduğunda veya oturumun tek bir basit isteğin ötesinde sürdürülmesi gerektiğinde kullanışlıdır.
Hizmet ayrıca web kazıma, ekran görüntüleri, PDF’ler ve özel tarayıcı işlevleri için REST API’leri sunar. Barındırılan MCP sunucusu, tarayıcı araçlarını AI ajanlarının kullanımına açarken oturum özellikleri ve kimliği doğrulanmış profiller, süreklilik gerektiren iş akışlarını destekler. Bu nedenle Browserless, hem özel bir veri toplayıcı geliştiren geliştiriciler hem de gerçek bir tarayıcı üzerinden gezinip bilgi toplaması gereken ajanlar için uygundur.
Satın alma kararında göz önünde bulundurulması gereken temel nokta, tarayıcı kullanımının nasıl ücretlendirildiğidir. Ücretsiz plan şu anda ayda 1.000 birim ve aynı anda kullanılabilen iki tarayıcı içerir; bu, 1.000 kazıma işleminin garanti edildiği anlamına gelmez. Tarayıcıda geçirilen süre birim tüketir; proxy trafiği ve başarıyla çözülen CAPTCHA’lar için ek ücret alınır. Oturum sınırları plana göre değişir. Veri çıkarma mantığının oluşturulması ve çıktıların denetlenmesi ekiplerin sorumluluğunda olmaya devam eder. Bu nedenle Browserless, görsel bir robot oluşturucudan çok tarayıcı kontrolünün önemli olduğu durumlarda en cazip seçenektir.
Artıları ve Eksileri
- Puppeteer ve Playwright ile alışılmış iş akışlarını korur
- REST API’leri web kazımayı ve sayfa dışa aktarımlarını kapsar
- Oturum özellikleri ve MCP, etkileşimli ajanlar için uygundur
- Tarayıcıda geçirilen süre ve eklentiler birim tüketimini etkiler
- Özel veri çıkarma işlemleri yine uygulama mantığı gerektirir
8. ScrapingBee
ScrapingBee, uzun süre çalışan bir tarayıcıyı doğrudan kontrol etmek yerine yönetilen bir kazıma isteği kullanmak isteyen geliştiriciler için güçlü bir seçenektir. API’si sayfa getirme ve JavaScript ile sayfa oluşturma özelliklerini proxy yönetimiyle bir araya getirir; veri çıkarma işlemi ise CSS veya XPath kurallarıyla ya da AI talimatlarıyla yapılabilir. Bu birleşim, kendi tarayıcı altyapısını işletmek istemeyen ancak birden fazla web sitesinden yapılandırılmış kayıtlar toplaması gereken projeler için kullanışlıdır.
Veriler toplanmadan önce JavaScript senaryoları tıklama, kaydırma ve yazma işlemleri yapabilir veya bekleyebilir. Markdown çıktısı, AI içerik iş akışlarını destekler; ekran görüntüleri ise oluşturulmuş sayfanın yakalanmasına yardımcı olur. Mevcut ürün ayrıca CLI ve MCP erişiminin yanı sıra belirli hedefler için özel API’ler de sunar. Geliştiriciler, kararlı alanlar için açıkça tanımlanmış veri çıkarma kurallarını; sayfa yapısı veya soru daha az öngörülebilir olduğundaysa doğal dilde veri çıkarmayı kullanabilir.
Barındırılan bir tarayıcı platformundan temel farkı pratiktir: ScrapingBee isteğe ve döndürülen sonuca odaklanırken daha geniş iş akışının yönetimi özel uygulamaya aittir. Birden fazla sayfanın eşgüdümü, yinelenen kayıtların ayıklanması, yenileme takvimleri ve kayıtların doğrulanması için yine bir çözüm gerekir. Kredi tüketimi, sayfa oluşturma ve proxy seçenekleri dâhil olmak üzere kullanılan özelliklere göre değişir. Basit bir HTTP arayüzüne önem veren ve veri hatlarının iş akışı düzenlemesini kendi kodlarında tutmak isteyen uygulama ekiplerine ScrapingBee’yi öneriyoruz.
Artıları ve Eksileri
- Seçici kuralları ve AI ile veri çıkarma esneklik sunar
- Sayfa oluşturma ve senaryolar etkileşimli sayfaları işler
- Markdown, CLI ve MCP, AI iş akışlarını destekler
- Gelişmiş istek seçenekleri kredi tüketimini artırır
- Birden fazla sayfayı kapsayan işler yine iş akışı düzenlemesi gerektirir
9. Oxylabs
Oxylabs, erişilmesi zor herkese açık web sitelerine yönetilen erişim ve daha yüksek veri toplama hacimlerine geçiş olanağı isteyen ekipler için güçlü bir seçenektir. Mevcut Web API’si, web verilerini getirmek ve yapılandırmak için JavaScript ile sayfa oluşturma ve erişim yönetimi özelliklerini hizmete entegre eden bir /Scrape çözümü sunar. Ürün portföyünde ayrıca /Search ve tarayıcı altyapısı da bulunur; böylece ekipler keşif, veri çıkarma veya etkileşimle başlayan göreve göre farklı yöntemler kullanabilir.
Hedefe özel seçenekler, yaygın arama ve e-ticaret kaynaklarından yararlı alanların alınmasını sağlar. MCP ve ajan becerileri üzerinden kurulan bağlantılar da veri toplamayı AI iş akışlarına taşır. Oxylabs, Classic Web Scraper API’sine ilişkin belgeleri de ayrıca yayımlamaya devam ediyor. Bu ayrım, mevcut entegrasyonlar açısından önemlidir: Classic API’yi kullanan bir ekip, yeni Web API’sine ait bir örneğin aynı şekilde kullanılabileceğini varsaymak yerine ilgili API’nin belgelerine başvurmalıdır.
Oxylabs, hedef sitelere erişmenin zorluğu, işlem hacmi veya erişim altyapısını sürdürmenin maliyeti yönetilen bir platformu gerekli kıldığında en mantıklı seçenektir. Uygulamanın yine de istenen şemayı, verilerin ne kadar süre güncel kalacağını ve eksik kayıtların nasıl işleneceğini belirlemesi gerekir. Kullanıma geçmeden önce seçilen API neslini, hedef seçeneklerini ve kullanım modelini gerçek işin gereksinimleriyle uyumlu hâle getirin. Küçük ölçekli, elle yapılan veri çıkarma işlemleri için görsel bir kazıyıcı daha uygun olabilir.
Artıları ve Eksileri
- Yönetilen işleme ve erişim altyapısı
- Hedefe özel yapılandırılmış veri çıkarma seçenekleri
- Güncel Web API’si ajan entegrasyonlarını destekliyor
- Klasik ve güncel API’ler için ayrı kurulum gerekiyor
- Çıktı kalitesinin yine de uygulama düzeyinde kontrol edilmesi gerekiyor
10. Diffbot
Bir sayfanın düzenini yeniden oluşturmaktan çok, içerdiği bilgileri anlamanın önemli olduğu durumlarda tercihimiz Diffbot. Extract, sayfaları sınıflandırmak ve standart şemalar aracılığıyla yapılandırılmış JSON çıktısı oluşturmak için bilgisayarlı görü ve doğal dil işleme teknolojilerinden yararlanıyor. Birden çok kaynaktan makale veya ürün toplayan ekipler için bu, sayfaları karşılaştırılabilir kayıtlara dönüştürmek üzere her siteye özel yazılması gereken ayrıştırma kodu miktarını azaltabilir.
Diffbot’un Knowledge Graph özelliği, bununla bağlantılı ancak ayrı bir ihtiyaca çözüm sunuyor: kamuya açık web’den önceden derlenmiş kuruluşlar, kişiler ve makaleler gibi varlıklarla çalışmaya. Kayıtlar, birden fazla kaynaktan gelen bilgileri bir araya getirebilir ve varlıkları anlamlı ilişkilerle birbirine bağlayabilir. Bu özellik, tek bir sayfada görünen alanların ötesinde bağlama ihtiyaç duyan zenginleştirme, şirket araştırması ve istihbarat uygulamalarında Diffbot’u kullanışlı kılıyor.
Buradaki ödünleşim, Diffbot’un veri modeliyle uyum sağlama gerekliliği. Sayfa türleri ve alanları işe uygun olduğunda standartlaştırılmış veri çıkarımı değerlidir; ancak alışılmadık bir alan veya özelleşmiş bir etkileşim için başka bir yaklaşım gerekebilir. Ekipler, seçtikleri URL’lerden veri çıkarmayı mevcut bir bilgi grafiğinde sorgulama yapmaktan ayırmalı, ardından kapsamı ve kaynakların güncelliğini buna göre değerlendirmelidir. Diffbot, yalnızca birkaç satırı elektronik tabloya kopyalamak isteyen kullanıcılardan çok, normalleştirilmiş bilgi ürünleri geliştiren teknik ekiplere uygundur.
Artıları ve Eksileri
- Otomatik sınıflandırma, ayrıştırıcı geliştirme işini azaltır
- Standart şemalar, benzer sayfalardaki verileri normalleştirmeye yardımcı olur
- Knowledge Graph, varlıklar hakkında ek bağlam sağlar
- Standart alanlar, uzmanlık gerektiren ihtiyaçları karşılamayabilir
- Veri çıkarımı ve grafiğe erişim farklı iş akışlarına hizmet eder
Sıkça Sorulan Sorular
Bir web kazıma aracını yapay zekâ destekli yapan nedir?
Yapay zekâ; alanları belirlemeye, sayfa içeriğini yorumlamaya, veri çıkarma adımları oluşturmaya veya tarayıcı işlemlerini yönetmeye yardımcı olabilir. Bazı araçlar yapay zekâyı kurulum sırasında, bazılarıysa her veri çıkarma işleminde kullanır. Bir hizmet, her istek için dil modeli kullanmadan temiz içerik sağlayarak da yapay zekâ uygulamalarını destekleyebilir. Etikete güvenmek yerine, veri toplama sorununuzu çözen özelliği seçin.
Web kazıma ile tarayıcı otomasyonu arasındaki fark nedir?
Web kazıma bilgi toplar. Tarayıcı otomasyonuysa menüleri açma, arama yapma veya çok adımlı bir iş akışında ilerleme gibi sayfa işlemlerini gerçekleştirir. Bu iki yöntem çoğu zaman birlikte çalışır: Otomatik tarayıcı ilgili sayfa durumuna ulaşır, ardından veri çıkarma adımı gerekli alanları toplar. Bu etkileşimler gerekmiyorsa doğrudan API isteği yapmak genellikle daha basittir.
Teknik uzmanlığı olmayan bir ekip için hangi araçlar daha uygundur?
Düzenli aralıklarla basit veri toplama ve değişiklikleri izleme için ilk önerimiz Browse AI. Ekip, görev adımları üzerinde daha fazla görsel denetim istiyorsa Octoparse güçlü bir alternatiftir. Her iki araçtan da en iyi verim, birinin ortaya çıkan kayıtları gözden geçirmesi ve kaynak web sitesinin ne zaman değiştiğini anlamasıyla alınır.
Bir yapay zekâ veya RAG işlem hattı, kazıma sonucunda elde edilen hangi bilgileri saklamalıdır?
Kaynak URL’sini, veri toplama zamanını, sayfa başlığını ve uygulamanın ihtiyaç duyduğu metni ya da yapılandırılmış alanları saklayın. Markdown, okunabilir belge yapısını koruyabilir; JSON ise tanımlanmış kayıtları destekler. Yinelenen içeriği kaldırın ve gezinme metinlerini ana içerikle karıştırmayın. Kaynağın köken bilgilerini saklamak, sonraki yanıtların izini sürmeyi ve verileri yenilemeyi kolaylaştırır.
Yönetilen bir tarayıcı kullanmaya ne zaman değer?
Veri toplamak için JavaScript çalıştırmak, birden fazla etkileşimde bulunmak veya oturum sürekliliğini korumak gerekiyorsa ve ekibiniz tarayıcı süreçlerini barındırmak istemiyorsa yönetilen tarayıcı kullanışlıdır. Browserless, mevcut Puppeteer veya Playwright kodları için amaca yönelik bir seçenektir. Tek bir statik sayfa için daha basit bir getirme veya veri çıkarma API’si daha az kaynak kullanabilir.
1.000 ücretsiz birim, 1.000 kazıma işlemiyle aynı şey midir?
Hayır. Birim ve kredi kullanımı her sağlayıcının kendi kurallarına tabidir. Browserless, tarayıcı bağlantılarını en fazla 30 saniyelik dilimler hâlinde ücretlendirir; proxy trafiği ve CAPTCHA çözme işlemleri de ek birim tüketir. Diğer hizmetler istek seçeneklerine, kayıt sayısına veya işlem gücü kullanımına göre ücret alır. Farklı ücretsiz planlardaki hakları eşdeğer saymak yerine iş akışının tamamı için gereken miktarı hesaplayın.
Yapay zekâ ile elde edilen veri çıkarma sonuçları incelenmeden güvenilir kabul edilebilir mi?
Geçerli bir JSON yanıtında bile bir kayıt eksik olabilir veya bir alan yanlış yorumlanabilir. Zorunlu alanları tanımlayın, türleri ve aralıkları kontrol edin, örnek kaynak sayfaları inceleyin ve kayıt sayılarındaki değişiklikleri izleyin. Düzenli tekrarlanan işler için açık hata ve boş sonuç durumları, her yanıtı eksiksiz bir veri kümesi saymaktan daha yararlıdır.
Yapay Zekâ Destekli Web Kazıma Araçlarına Dair Son Düşünceler
Bright Data, geniş kapsamlı bir web verisi programı için genel tercihimiz; Firecrawl ise web sayfalarını yapay zekâya hazır içeriğe dönüştürmeye başlamak için en iyi seçenek. Yeniden kullanılabilir araçlar, zamanlanmış işler ve bulut operasyonları projenizin merkezindeyse Apify‘ı tercih edin.
İşletme ekipleri için Browse AI, düzenli izlemeyi kolaylaştırırken Octoparse, daha kapsamlı veri çıkarma görevlerini görsel olarak iyileştirme olanağı sunuyor. Gerekli çıktı yapılandırılmış arama verileriyse uzmanlaşmış seçenek SearchAPI.
Browserless, tanıdık otomasyon kütüphaneleriyle yönetilen tarayıcı çalıştırma olanağı arayan geliştiriciler için öne çıkıyor. Yönetilen bir veri çıkarma isteği uygulamaya daha iyi uyuyorsa ScrapingBee güçlü bir alternatif. Oxylabs, kapsamlı halka açık web verisi toplamaya uygunken Diffbot, standartlaştırılmış veri çıkarımı ve varlık zekâsıyla öne çıkıyor.
Uzun vadede en iyi seçenek, ekibinizin sürdürebileceği bir iş akışıyla gereken bilgileri sunandır. Veri toplama yöntemini göreve uygun seçin, kaynak bağlamını koruyun ve değeri istenen sayfa sayısına göre değil, kullanılabilir çıktıya göre değerlendirin.




