
ベスト
優れた機械学習アルゴリズム10選

 Unite.AI を Google の優先ソースに追加
私たちがGPUアクセラレーションマシンラーニングの時代を生きている中で、最新の研究論文では頻繁に(そして目立つように)数十年、場合によっては70年前に開発されたアルゴリズムが登場しています。
一部の人々は、これらの古い方法の多くが「マシンラーニング」ではなく「統計分析」のカテゴリに入るという議論を唱えるかもしれません。彼らは、マシンラーニングの分野の始まりを1957年に、ペルセプトロンの発明にまで遡るかもしれません。
これらの古いアルゴリズムが最新のトレンドやマシンラーニングの分野での注目すべき発展をどの程度サポートし、絡み合っているかという点で、これは議論の余地がある主張です。したがって、最新の革新や注目すべき発展の基盤となっている「クラシック」の構成要素と、新しいエントリをいくつか見てみましょう。
1:トランスフォーマー
2017年、Google Researchは共同研究を主導し、その成果として論文 Attention Is All You Needを発表しました。この研究では、注意メカニズムを、エンコーダ/デコーダや再帰型ネットワークモデルの補助的な構成要素から、それ自体が中心となる変革的技術へと引き上げる新しいアーキテクチャが概説されました。
このアプローチは、トランスフォーマーと呼ばれ、自然言語処理(NLP)において革命的な方法論となりました。トランスフォーマーは、オートレグレッシブ言語モデルおよびAIの象徴GPT-3を含む多くの例を動かします。

トランスフォーマーは、シーケンストランスダクション、または「変換」と呼ばれる問題を優雅に解決しました。これは、入力シーケンスを出力シーケンスに処理することに関係しています。トランスフォーマーは、バッチではなく連続的にデータを受け取り、管理します。これにより、RNNアーキテクチャでは取得できない「記憶の持続性」が可能になります。トランスフォーマーの詳細な概要については、参考記事を参照してください。
CUDA時代に機械学習研究の主流になり始めていた再帰型ニューラルネットワーク(RNN)とは異なり、Transformerアーキテクチャは容易に並列化でき、RNNよりもはるかに大規模なデータ群を効率的に扱う道を開きました。
一般的な使用
トランスフォーマーは、2020年にOpenAIのGPT-3がリリースされたときに、一般の人々の想像力を掴みました。GPT-3は、当時としては記録的な1,750億個のパラメータを持っていました。この驚くべき成果は後に他のプロジェクトによって上回られました。たとえば、2021年にMicrosoftのMegatron-Turing NLG 530Bがリリースされました。これは、名前の通り5,300億個を超えるパラメータを持つものでした。

ハイパースケールTransformer NLPプロジェクトのタイムライン。 出典:Microsoft
トランスフォーマーアーキテクチャは、NLPからコンピュータビジョンにも広がり、新世代の画像合成フレームワークを動かしています。たとえば、OpenAIのCLIPやDALL-Eがあります。これらは、テキストと画像のドメインマッピングを使用して、不完全な画像を完成させ、学習されたドメインから新しい画像を合成することができます。
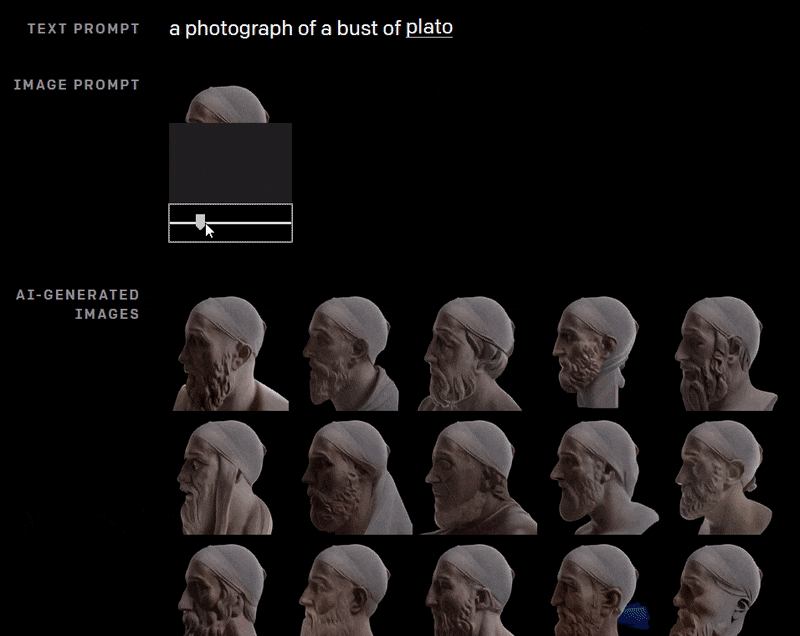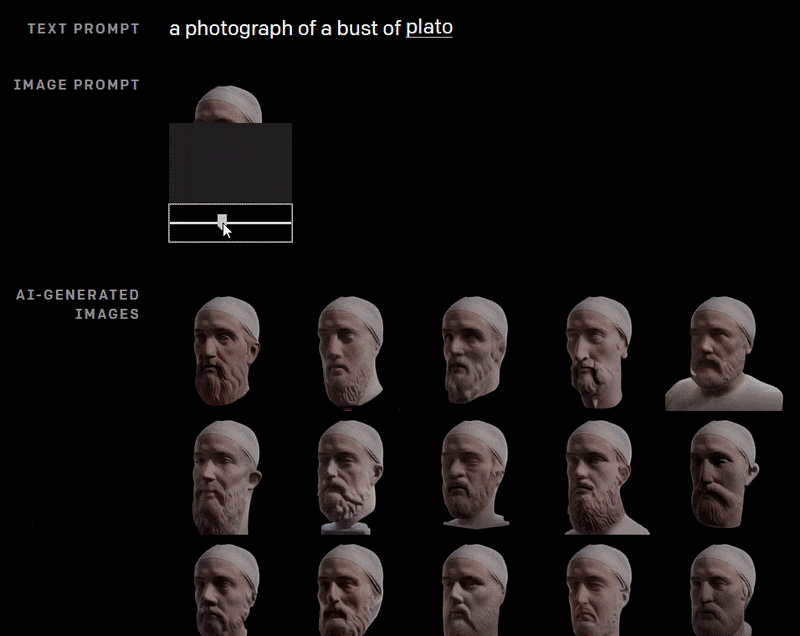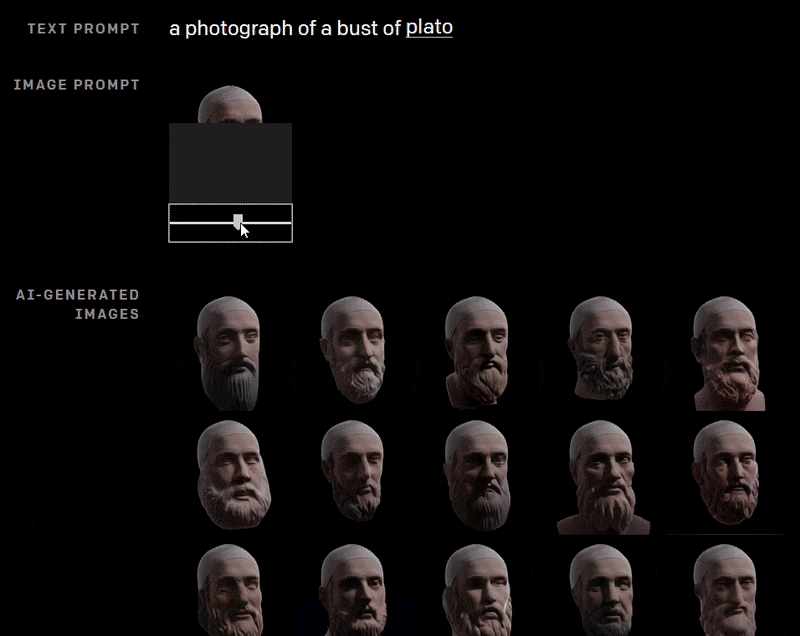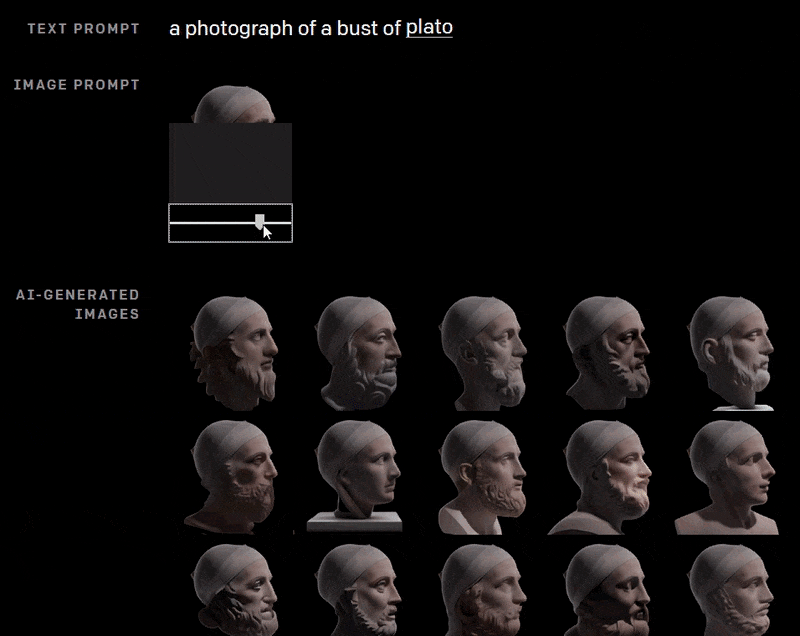
DALL-Eは、プラトンの胸像の部分的な画像を完成させます。 出典:https://openai.com/blog/dall-e/
2:生成対抗ネットワーク(GAN)
トランスフォーマーがGPT-3のリリースと採用を通じて非凡なメディアの注目を集めた一方で、生成対抗ネットワーク(GAN)は独自のブランドとして認識されるようになりました。GANは最終的にディープフェイクという用語と同様に動詞として使用される可能性があります。
2014年に最初に提案され、主に画像合成に使用される、生成対抗ネットワークアーキテクチャは、ジェネレーターとディスクリミネーターで構成されます。ジェネレーターは、データセット内の数千の画像を繰り返し再構築しようとします。各試行ごとに、ディスクリミネーターはジェネレーターの仕事を評価し、ジェネレーターに戻り、改善するように指示しますが、前の再構築がどのように間違っていたかについての洞察は提供しません。

出典:https://developers.google.com/machine-learning/gan/gan_structure
これにより、ジェネレーターは多数の道を探索するようになり、ディスクリミネーターがどこで間違っていたかを教えていれば生じる可能性のある盲点を避けることができます(下記の#8を参照)。トレーニングが終了するまでに、ジェネレーターはデータセット内のポイント間の関係の詳細で包括的なマップを取得します。
論文Improving GAN Equilibrium by Raising Spatial Awareness:GANの時に謎めいた潜在空間を巡る新しいフレームワークが、画像合成アーキテクチャを応答性よく操作する手段を提供します。 出典:https://genforce.github.io/eqgan/
これは、ロンドン中央部への単調な通勤を学ぶことと、ロンドンのタクシー運転手に求められる詳細な道路知識、The Knowledgeを苦労して習得することの違いです。
結果として、トレイン済みモデルの潜在空間に高いレベルの特徴のコレクションが得られます。高レベルの特徴の意味的なインジケーターは「人物」である可能性がありますが、特徴に関する特異性の降下では、他の学習された特徴、たとえば「男性」と「女性」が発見されます。下位レベルでは、サブ特徴は「ブロンド」、「コーカソイド」などのものに分解されます。
GANとエンコーダ/デコーダフレームワークの潜在空間における「エンタングルメント」は注目すべき問題です。GAN生成の女性の顔の笑顔は、潜在空間における彼女の「アイデンティティ」のエンタングルされた特徴ですか、それとも並行なブランチですか?

GAN生成の顔。 出典:https://this-person-does-not-exist.com/en
過去2年間で、潜在空間の特徴レベルの編集のための新しい研究イニシアチブが多数出現し、GANの潜在空間のためのPhotoshopスタイルの編集の道を切り開く可能性があります。しかし現在、多くの変換は実質的に「すべてか、さもなくば何もない」という一括処理です。注目すべきことに、2021年後半に公開されたNVIDIAのEditGANは、セマンティックセグメンテーションマスクを用い、潜在空間で高い解釈可能性を実現しています。
一般的な使用
実際には、ディープフェイク動画での使用が限られているにもかかわらず、画像/ビデオ中心のGANは過去4年間で普及し、研究者や一般の人々を魅了してきました。新しいリリースの驚くべき速度と頻度に追いつくことは課題ですが、Awesome GAN Applications GitHubリポジトリは、包括的なリストを提供することを目指しています。
GANは、テキストを含む、適切に構成されたドメインからの特徴を抽出できることが理論的に示されています。
3:サポートベクターマシン(SVM)
1963年に初めて提案された、サポートベクターマシン(SVM)は、研究論文で頻繁に登場する重要なアルゴリズムです。SVMでは、ベクターはデータセット内のデータポイントの相対的な配置をマッピングし、サポートベクターは異なるグループ、特徴、または特性間の境界を定義します。

サポートベクターはグループ間の境界を定義します。 出典:https://www.kdnuggets.com/2016/07/support-vector-machines-simple-explanation.html
導出された境界は、ハイパープレーンと呼ばれます。
特徴が少ない場合、SVMは2次元(上の画像)ですが、認識されるグループまたはタイプの数が多い場合、3次元になります。

ポイントとグループのより深い配列は、3次元SVMを必要とします。 出典:https://cml.rhul.ac.uk/svm.html
一般的な使用
SVMは、高次元のさまざまな種類のデータを効果的に、かつアグノスティックに処理できるため、ディープフェイク検出、画像分類、ヘイトスピーチ分類、DNA分析、および集団構造予測を含む、さまざまなマシンラーニングの分野で広く使用されています。
4:K-平均クラスタリング
クラスタリングは一般に、教師なし学習アプローチであり、密度推定を使用して、データポイントをカテゴリ化し、分析対象のデータの分布をマッピングします。

K-平均クラスタリングは、データにセグメント、グループ、コミュニティを認識します。 出典:https://aws.amazon.com/blogs/machine-learning/k-means-clustering-with-amazon-sagemaker/
K-平均クラスタリングは、このアプローチで最も人気のある実装であり、データポイントを「Kグループ」に導きます。これらは、人口統計セクター、オンラインコミュニティ、または生データで発見できる他の潜在的な集団を表す可能性があります。

K-平均分析でクラスターが形成されます。 出典:https://www.geeksforgeeks.org/ml-determine-the-optimal-value-of-k-in-k-means-clustering/
Kの値は、プロセスの有用性とクラスターの最適値を決定する決定的な要素です。最初に、Kの値はランダムに割り当てられ、その特徴とベクター特性がその隣接点と比較されます。ランダムに割り当てられた値を持つデータポイントに最もよく似ている隣接点は、クラスターに反復的に割り当てられます。データが許可するすべてのグループ化が得られるまで、プロセスが続きます。
クラスター間の異なる値の二乗誤差、または「コスト」のプロットは、データに対して「肘点」を示します。

クラスター グラフの肘点。 出典:https://www.scikit-yb.org/en/latest/api/cluster/elbow.html
肘点は、トレーニング セッションの終わりに損失が減少して収束するのと同じ概念です。グループ間のさらなる区別が明らかにならなくなるポイントを表し、データ パイプラインの次の段階に進むか、または結果を報告することを示します。
一般的な使用
K-平均クラスタリングは、明確で説明可能な方法で大量の商業レコードを人口統計情報や「リード」に翻訳できるため、顧客分析で主な技術です。
このアプリケーションの外側で、K-平均クラスタリングは、地滑り予測、医療画像セグメンテーション、GANを使用した画像合成、ドキュメント分類、および都市計画を含む、多数の潜在的な使用法や実際の使用法があります。
5:ランダムフォレスト
ランダムフォレストは、アンサンブル学習方法であり、決定木の配列からの結果の平均を使用して、結果の全体的な予測を決定します。

出典:https://www.tutorialandexample.com/wp-content/uploads/2019/10/Decision-Trees-Root-Node.png
あなたがそれを少し調べたとしても、バック・トゥ・ザ・フューチャー三部作のように、決定木自体は概念として理解しやすいです。あなたの前にいくつかのパスがあり、それぞれのパスは新しい結果に分岐し、その結果はさらに新しいパスを含みます。
強化学習では、ある経路から引き返して以前の状態からやり直せますが、決定木は選んだ経路を進みます。
したがって、ランダムフォレストは本質的に意思決定のリスクを分散させる方法です。「ランダム」と呼ばれるのは、決定木の配列から得られる結果の中央値の総和を理解するために、その場に応じた選択と観測を行うためです。
多くの要因を考慮するため、ランダムフォレストは単一の決定木よりも意味のあるグラフに変換しにくい場合がありますが、生産性は大きく向上する可能性があります。
決定木はオーバーフィッティングの影響を受けやすく、データに特化した結果が得られ、一般化する可能性は低くなります。ランダムフォレストのランダムなデータポイントの選択は、この傾向に対抗し、データに含まれる意味のある有用で代表的な傾向を抽出します。

決定木回帰。 出典:https://scikit-learn.org/stable/auto_examples/tree/plot_tree_regression.html
一般的な使用
ランダムフォレストは、データの早期のソーターおよびフィルタとして頻繁に機能するため、研究論文で頻繁に登場します。ランダムフォレストの使用例としては、磁気共鳴画像シンセシス、ビットコイン価格予測、国勢調査データに基づく顧客セグメンテーション、テキスト分類、およびクレジットカード不正検出があります。
ランダムフォレストは、マシンラーニングアーキテクチャの低レベルアルゴリズムであるため、誘導クラスタリング、特徴変換、スパース特徴を使用したテキストドキュメントの分類、およびパイプラインの表示を含む他の低レベル方法のパフォーマンスに貢献する可能性があります。
6:ナイーブベイズ
密度推定(上記の4を参照)と組み合わせて、ナイーブベイズ分類器は、データの計算された特徴に基づいて確率を推定できる、比較的軽量なアルゴリズムです。

ナイーブベイズ分類器の特徴関係。 出典:https://www.sciencedirect.com/topics/computer-science/naive-bayes-model
「ナイーブ」という用語は、ベイズの定理における仮定、つまり特徴が無関係であることを示しています。これは、条件付き独立と呼ばれます。アヒルが歩くように歩き、アヒルが話すように話すだけでは、アヒルであると結論付けるには十分ではないということです。明らかな仮定は、事前に採用されません。
このレベルの学術的、調査的な厳格さは、「常識」が利用可能な場合には過剰であるかもしれませんが、マシンラーニングのデータセットに存在する可能性のある多くの曖昧さや無関係な相関関係を通過する場合には、貴重な基準です。
元のベイジアン ネットワークでは、特徴には、最小記述長やベイジアンスコアリングなどのスコアリング関数が適用されます。これらは、データ ポイント間の推定される接続と、これらの接続が流れる方向に関する制限をデータに課すことができます。
ナイーブベイズ分類器は、特徴が独立しているという仮定に基づいて動作し、ベイズの定理を使用して、特定のオブジェクトの確率をその特徴に基づいて計算します。
一般的な使用
ナイーブベイズ フィルタは、疾患予測とドキュメント分類、スパム フィルタリング、感情分析、レコメンダー システム、および不正検出を含む、さまざまなアプリケーションで広く表れています。
7:K-最近傍(KNN)
アメリカ空軍航空医学学校によって1951年に初めて提案され、20世紀半ばのコンピュータハードウェアの性能に適応する必要があった、K-最近傍(KNN)は、依然としてマシンラーニングの研究論文やプライベート セクターのイニシアチブで重要な役割を果たしています。
KNNは「怠惰な学習者」と呼ばれます。なぜなら、データセットを徹底的にスキャンしてデータ ポイント間の関係を評価する必要があるからです。代わりに、完全な機械学習モデルをトレーニングする必要はありません。

KNNグループ化。 出典:https://scikit-learn.org/stable/modules/neighbors.html
KNNはアーキテクチャ的にスリムですが、その体系的なアプローチは、特に主成分分析(PCA)などの付随技術を使用せずに、非常に大きなデータセットで読み取り/書き込み操作に著しい要求を課す可能性があります。PCAは、複雑で大量のデータセットを、KNNがより簡単に移動できる、代表的なグループに変換できます。
最近の研究では、従業員が会社を辞めるかどうかを予測する複数のアルゴリズムの有効性と経済性が評価され、70年前に生まれたKNNが、精度と予測性能でより新しい競合手法を上回っていることが分かりました。
一般的な使用
KNNは、よりDNNに焦点を当てたアプローチに2018年にペンシルバニア州立大学によって適応され、より複雑な機械学習フレームワークの多くで、初期段階の中心的な処理や後処理の分析ツールとして使われています。
さまざまな構成でKNNは、オンライン署名検証、画像分類、テキスト マイニング、作物予測、および顔認識を含む、さまざまな構成と多数のアプリケーションで使用されています。

トレーニング中のKNNベースの顔認識システム。 出典:https://pdfs.semanticscholar.org/6f3d/d4c5ffeb3ce74bf57342861686944490f513.pdf
8:マルコフ決定プロセス(MDP)
アメリカの数学者リチャード・ベルマンが1957年に導入した数学的枠組みであるマルコフ決定過程(MDP)は、強化学習アーキテクチャの最も基本的な構成要素の一つです。それ自体が概念的なアルゴリズムであり、多数の別のアルゴリズムに取り入れられ、現在のAI・機械学習研究にも頻繁に登場します。
MDPは、現在の状態(つまり、データの中でどこにいるか)の評価を使用して、次にデータのどのノードを探索するかを決定します。

出典:https://www.sciencedirect.com/science/article/abs/pii/S0888613X18304420
基本的なマルコフ決定プロセスは、長期的な目標よりも近期的な利益を優先します。この理由により、強化学習では、より包括的なポリシー アーキテクチャに組み込まれることが多く、割引報酬やその他の調整用の環境変数などの制約を受けます。これらにより、望ましい全体の結果を考慮せず、目先の目標だけに飛びつくことを防ぎます。
一般的な使用
MDPの低レベル概念は、研究とマシンラーニングの活用において広く普及しています。IoTセキュリティ防御システム、漁獲、および市場予測の提案がなされています。
チェスやその他の厳密に逐次的なゲームへの明らかな適用可能性に加え、MDPは、下の動画に見られるように、ロボットシステムの手順的な訓練にも自然な候補となります。
9:TF-IDF(Term Frequency-Inverse Document Frequency)
単語頻度(TF)は、単語が文書内で出現する回数を、文書内の単語の総数で割ったものです。したがって、1,000語の記事で単語「アザラシ」が1回出現する場合、そのTFは0.001になります。単独では、TFは単語の重要性の指標としてほとんど役に立たないため、意味内容の乏しい機能語(the、and、a、itなど)が優勢になるからです。
単語に意味のある値を与えるため、逆文書頻度(IDF)はデータセット内の複数の文書について単語のTFを計算し、冠詞などの非常に頻度の高いストップワードに低い評価を与えます。得られた特徴ベクトルは整数値に正規化され、各単語に適切な重みが割り当てられます。

TF-IDFは複数の文書における頻度に基づいて単語の関連性を重み付けし、まれに現れることを重要性の指標とします。 出典:https://moz.com/blog/inverse-document-frequency-and-the-importance-of-uniqueness
このアプローチでは、意味的に重要な単語が外れ値として失われるのを防ぎますが、頻度を逆転させることは、低頻度の単語が外れ値ではないことを意味するわけではありません。なぜなら、まれでありながら価値のないものも存在するからです。したがって、低頻度の単語は、データセット内の複数のドキュメントに(各ドキュメントあたり低頻度で)出現することで、その価値を証明する必要があります。
その古さにもかかわらず、TF-IDFは、自然言語処理フレームワークでの初期フィルタリング パスの強力で一般的な手法です。
一般的な使用
TF-IDFは、過去20年間でGoogleのPageRankアルゴリズムの開発に少なくともある程度関与しているため、非常に広く採用されていますが、ジョン・ミューラーが2019年に検索結果における重要性を否定したにもかかわらず、操作的なSEO戦術として使われています。
PageRankの秘密に包まれているため、TF-IDFが現在Googleのランキングを上げるのに効果的ではないことを示す明確な証拠はありません。IT専門家の間で最近行われた激しい議論は、正しいかどうかは別として、広く共有されている見方として、単語の乱用がSEOの位置を向上させる可能性があることを示唆しています(ただし、追加の独占的乱用の告発や過度の広告は、この理論の境界を曇らせています)。
10:確率的勾配降下法(SGD)
確率的勾配降下法(SGD)は、マシンラーニング モデルのトレーニングを最適化するために、ますます人気のある方法となっています。
勾配降下法は、マシンラーニング モデルがトレーニング中に改善していることを最適化し、量化する方法です。
この意味で「勾配」は、色のグラデーションではなく下向きの傾斜を指します(下の図参照)。左側にある「丘」の最高点が訓練の開始を表します。トレーニングの開始時点で、モデルはまだデータの全体を見ておらず、データの関係について十分に学習していないため、効果的な変換を生成することができません。

FaceSwapトレーニング セッションの勾配降下法。2番目の半分でしばらくプラトーに達していたものの、最終的に収束に向かって勾配を回復しました。
最低点は、モデルが与えられた制約と設定の下で可能な限り効果的になるポイントを表します。
勾配は、エラー率(モデルが現在データの関係をどの程度正確にマッピングしているか)と重み(モデルが学習するように影響を与える設定)の間の不一致の記録であり、予測でもあります。
この進歩の記録は、学習率スケジュールに使用できます。学習率スケジュールは、初期の漠然とした詳細が明確な関係とマッピングに変化するにつれて、より緻密で正確なものになるようにアーキテクチャに指示する自動プロセスです。実質的に、勾配の損失は、トレーニングが次にどこへ行くべきか、どのように進むべきかを示す、ジャストインタイムのマップを提供します。
確率的勾配降下法の革新は、各トレーニング例ごとにモデルパラメータを更新することです。これにより、一般的に収束への旅が速くなります。近年、超大規模データセットが登場したため、SGDは、生じるロジスティック問題に対処するための1つの方法として、人気を博しています。
一方で、SGDは、特徴スケーリングに悪影響を及ぼします。さらに、同じ結果を達成するために、通常の勾配降下法よりも反復回数が多くなる可能性があり、追加の計画と追加のパラメータが必要になる可能性があります。
一般的な使用
設定の柔軟性があり、欠点もあるものの、SGDはニューラルネットワークをデータに適合させる最も一般的な最適化アルゴリズムとなりました。新しいAI・機械学習論文で主流になりつつあるSGDの構成の一つは、2015年に導入されたアダプティブ モーメント推定(ADAM)オプティマイザーの選択です。
ADAMは、各パラメータの学習率を動的に調整します(「適応学習率」)。また、前の更新からの結果を次の構成に組み込みます(「モーメントム」)。さらに、ネステロフ モーメントムなどの後続の革新を使用するように構成できます。
しかし、一部の人は、モーメントムの使用が、ADAM(および同様のアルゴリズム)を最適でない結論に急がせる可能性があると主張しています。マシンラーニング研究の最前線は、ほとんどの場合、進行中の作業です。
最初に公開された:2022年2月10日。2022年2月10日20:05 EET – フォーマットの変更。


