
Andersonの視点
従来のCGIで顔を描画するためのGAN

 Unite.AI を Google の優先ソースに追加

要点GANの潜在空間において、アイデンティティと表現を切り離すことは、顔動画合成における中心的な未解決課題であり続けている。
もっと見る
- GANの潜在空間において、アイデンティティと表現を切り離すことは、顔動画合成における中心的な未解決課題であり続けている。
- SMPLや3DMMのようなパラメトリックCGIモデルは、GANの扱いにくい潜在コードに秩序をもたらすためにますます使用されている。
- ディズニーのRendering with Styleハイブリッドアプローチは、従来のテクスチャマップとGANが生成した画像を融合させることで、不気味の谷現象を引き起こす結果を生み出した。
意見 Generative Adversarial Networks (GANs) が最初に 驚くほど写実的な3Dフェイスを再現する能力を実証したとき、GANs の未開拓の可能性を利用して人間の顔が登場する時間的に一貫したビデオを生成するためにゴールドラッシュが起こった。
GANの潜在空間のどこかに、隠れた秩序と合理性 – 潜在コードの中に埋もれた、同じ顔の複数のビューと解釈 (例えば、表情の変化) を生成するために、GAN が使用できるスキーマ – があり、結果として、オートエンコーダーを上回る、時間的に説得力のあるディープフェイクビデオ方法が提供されるはずだった。
高解像度出力は、GPU 制約によって DeepFaceLab と FaceSwap が操作する低解像度環境に比べて簡単なことだった。オートエンコーダーのワークフローにおける「スワップゾーン」は、GAN の「創造ゾーン」になり、数枚の入力画像、あるいは1枚だけでも、それを手がかりに生成することになる。
「スワップ」と「ホスト」の顔の間の不一致は、画像全体がゼロから生成されるため、なくなり、髪の毛、顎線、顔の線の最も外側の部分も含めて、頻繁にオートエンコーダーのディープフェイクの課題となる。
GAN フェイシャルビデオの冬
しかし、実際にはそう簡単ではなかった。最終的には、解離が中心的な問題となり、現在も主要な課題となっている。どのようにして、明確な顔のアイデンティティを維持し、姿勢や表情を変更することができるか、そして、オートエンコーダーシステムがそのような変更が行われたときに何が起こるかを教えるために、数千枚の参照画像を苦労して集めることなしに実現できるか。
その後、GAN フェイシャル演技と合成研究では、入力アイデンティティに、個人固有ではない目的志向の汎用的なテンプレート化された変換に従属させることができると考えられた。例えば、GAN が知っているその人の画像に存在しない表情を GAN フェイスに適用することである。

2022 年の論文「Tensor-based Emotion Editing in the StyleGAN Latent Space」から、テンプレート化された表情が FFHQ データセットからの入力フェイスに適用される。ソース: https://arxiv.org/pdf/2205.06102.pdf
「ワンサイズフィットオール」のアプローチでは、個人の固有の顔の表情の多様性をカバーすることはできない。ジャック・ニコルソンやウィレム・デフォーのようなユニークな笑顔が、そんな「平均的な表情」の潜在コードの影響を受けて、忠実に解釈されることができるかどうか疑問に思う。

この魅力的なラテン系の男性は誰か。GAN メソッドはよりリアルで高解像度のフェイスを生成するが、ディープフェイスラブのように、数千の画像で長時間、しばしば大きな費用をかけて学習したものではなく、変換は、GAN が知っている俳優の実際の画像によって通知されていない。そのため人物の似かより方は損なわれる。ここでは(背景)ディープフェイスラブのモデルが、人気があり議論も呼ぶソフトウェアのストリーミング実装であるDeepFaceLiveにインポートされる。例は https://www.youtube.com/watch?v=9tr35y-yQRY(2022 年)および https://arxiv.org/pdf/2205.06102.pdf から。
過去数年間に、いくつかの GAN フェイシャル表情エディターが提示されてきたが、そのほとんどは 未知のアイデンティティ を扱っており、その忠実性は、一般の読者が判断することができない。なぜなら、これらは馴染みのない顔だからである。

2020 年の Cascade-EF-GAN では、不明なアイデンティティが変換される。ソース: https://arxiv.org/pdf/2003.05905.pdf
過去 3 年間で最も注目された GAN フェイスエディターは、InterFaceGAN であり、姿勢(カメラ/顔の角度)、表情、年齢、人種、性別などの基本的な特性に関連する潜在コードの空間を移動することができる。
InterFaceGAN や同様のフレームワークの 1980 年代スタイルの「モーフィング」機能は、主に画像が適切な潜在コード(例えば「年齢」)を通じて再投影される変換への道を示す方法であり、現在のところ、時間的に連続したビデオの生成においては「印象的な失敗」となっている。
また、時間的に一貫した髪の毛の作成の難しさや、潜在コードの探索/操作の技術が時間的なガイドラインを提供することができないこと(そして、静止画像を生成するように設計されたフレームワークにそのようなガイドラインを注入することが難しい)を加えると、GAN がフェイシャルビデオ合成に必要なすべてのものではないと結論付けることが論理的である。
したがって、後の努力により、漸進的な改善が得られ、他のコンピュータビジョンの規範、例えばセマンティックセグメンテーションを制御メカニズムとして使用することができた。2021 年末の 論文 SemanticStyleGAN: Learning Compositional Generative Priors for Controllable Image Synthesis and Editing ではそうである。
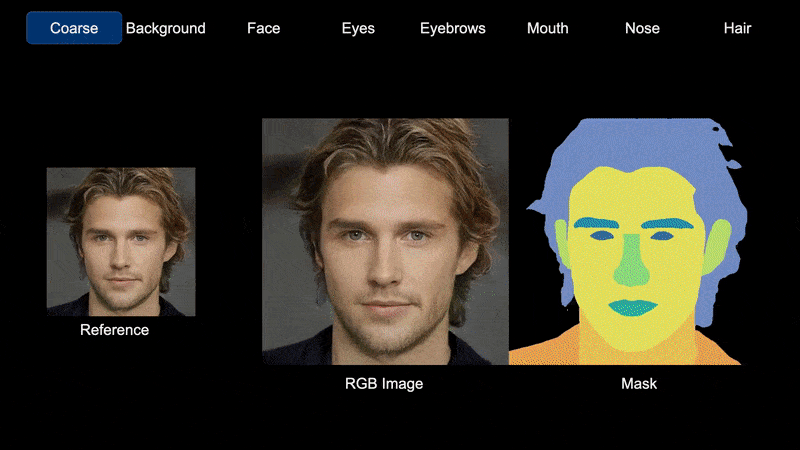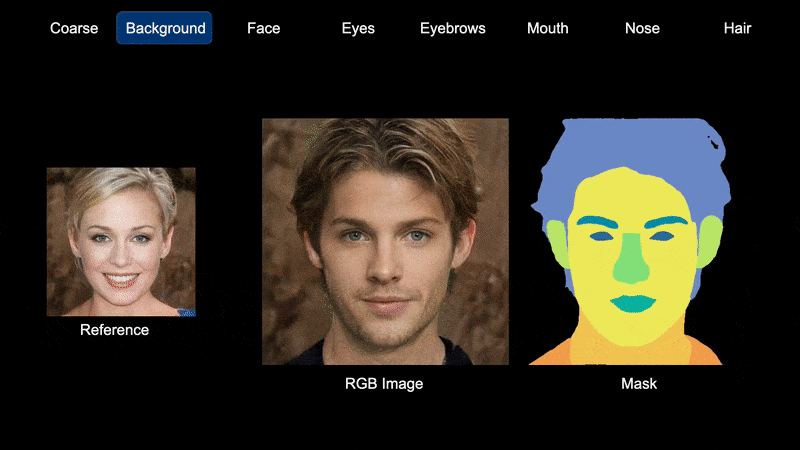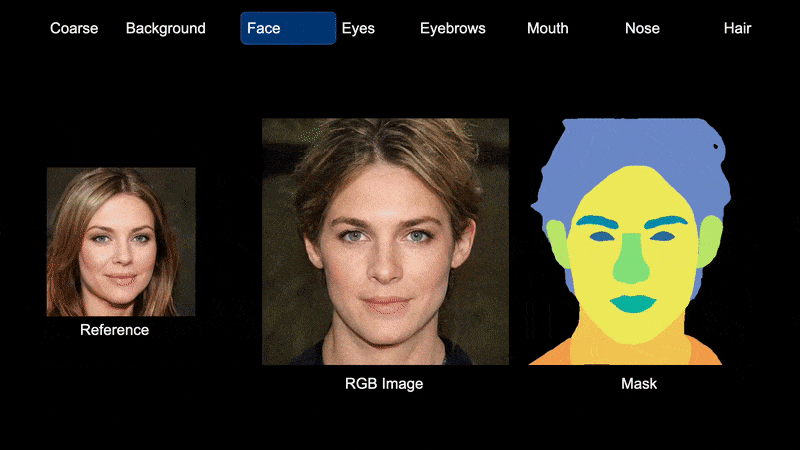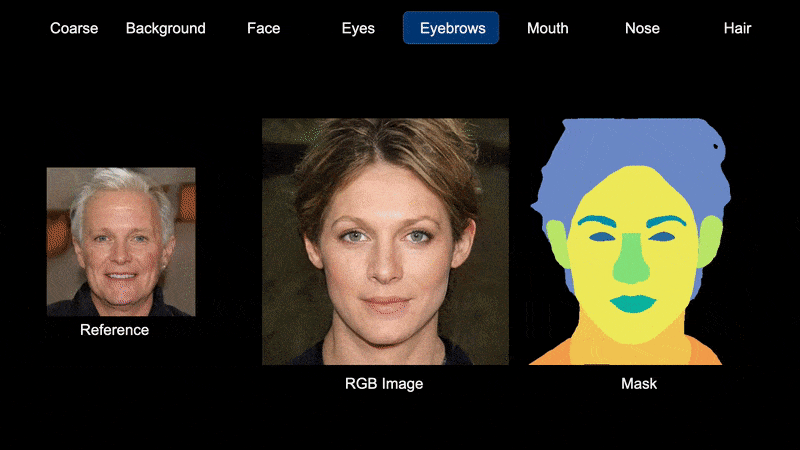
SemanticStyleGAN では、セマンティックセグメンテーションが潜在空間を制御する手段として使用される。ソース: https://semanticstylegan.github.io/
パラメトリックガイダンス
GAN フェイシャル合成研究コミュニティは、GAN の潜在空間の乱れた潜在コードを導き、秩序をもたらすために「伝統的な」パラメトリック CGI フェイスを使用することにますます重点を置いている。
パラメトリックフェイシャルプリミティブは、コンピュータビジョン研究の定番であり、20年以上の歴史があるが、このアプローチへの関心は最近高まっており、Skinned Multi-Person Linear Model (SMPL) CGI プリミティブの使用が増えており、Max Planck Institute と ILM によって開拓され、Sparse Trained Articulated Human Body Regressor (STAR) フレームワークによって改良されている。

SMPL (この場合は SMPL-X というバリアント) は、画像に含まれる人間の身体の推定された姿勢(必要に応じて表情を含む)に一致する CGI パラメトリックメッシュを課すことができるため、新しい操作を画像に対してパラメトリックメッシュをボリューメトリックまたは認識ガイドラインとして使用して実行できる。ソース: https://arxiv.org/pdf/1904.05866.pdf
この分野で最も称賛される開発は、ディズニーの 2019 年の レンダリングスタイル の取り組みであり、伝統的なテクスチャーマップと GAN 生成画像を組み合わせて、改善された「ディープフェイクスタイル」のアニメ化出力を生成することを目指した。

古いものと新しいものがディズニーのハイブリッドアプローチで出会う、GAN 生成のディープフェイク。ソース: https://www.youtube.com/watch?v=TwpLqTmvqVk
ディズニーのアプローチでは、StyleGAN2 ネットワークに伝統的にレンダリングされた CGI フェイスを課すことで、人間のフェイシャルサブジェクトの「問題のある」領域(例えば、時間的一貫性が問題となるビデオ生成の場合の皮膚テクスチャ)を「インペイント」する。

レンダリングスタイルのワークフロー。
このプロセスを導く CGI ヘッドは、ユーザーによって調整および変更できるため、GAN 生成のフェイスは、ヘッドのポーズや表情の変更を反映できる。
CGIの制御性とGANの自然な写実性を融合する狙いだったが、結果は両者の最悪の部分を示し、髪の毛のテクスチャーや基本的な特徴の位置を一貫して維持できない。
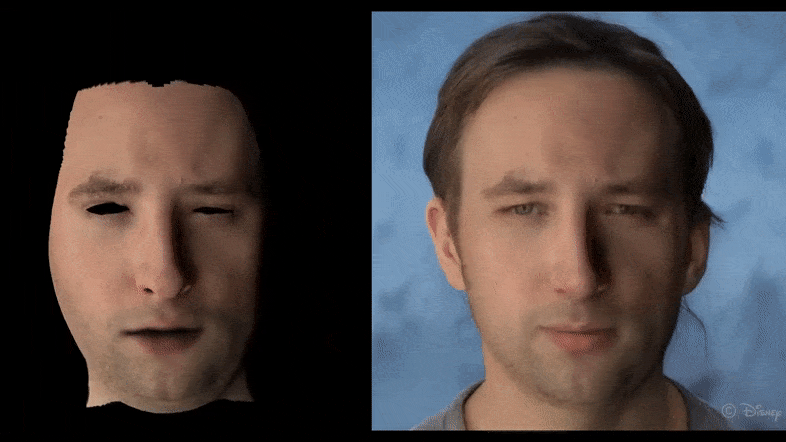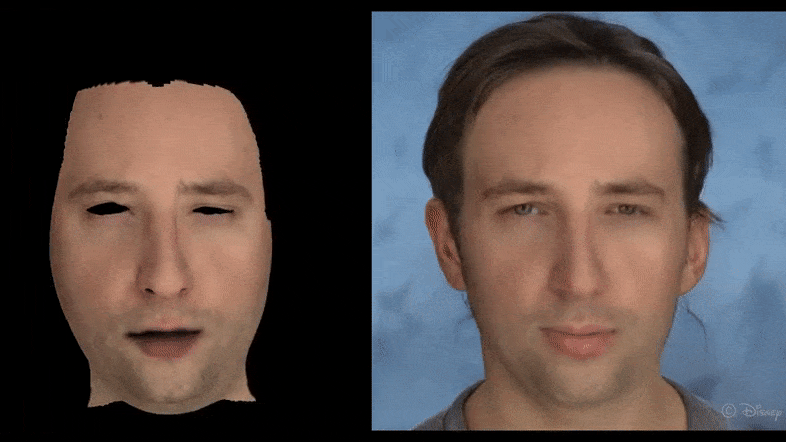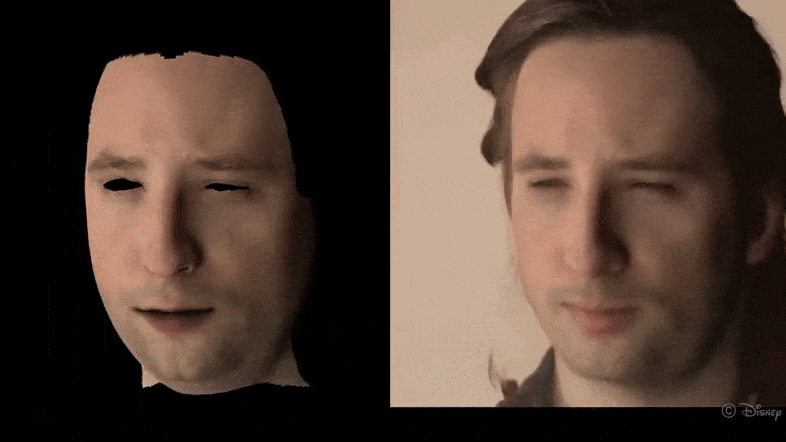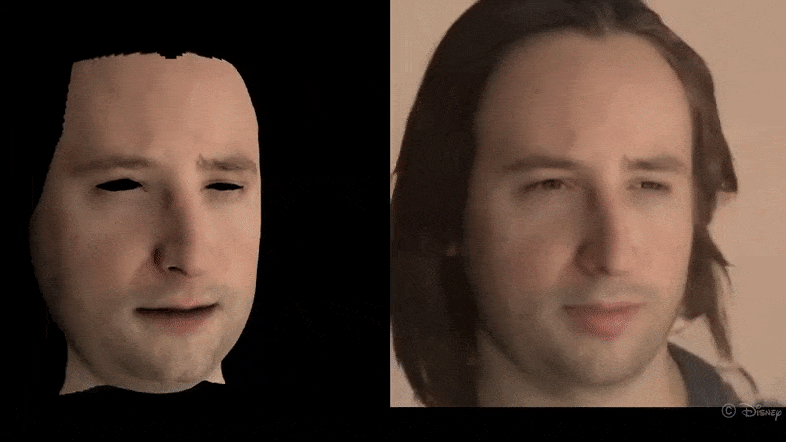
レンダリングスタイルから新しいタイプの不気味の谷 が生じるが、原則としてはまだ潜在性がある。
2020 年の 論文 StyleRig: Rigging StyleGAN for 3D Control over Portrait Images では、三次元モーファブルフェイスモデル (3DMM) を StyleGAN 環境で特性を変更するためのプロキシとして使用するという、ますます一般的なアプローチがとられている。ここではRigNetという新しいリギングネットワークを使用する。

StyleRig では、3DMM が潜在空間の解釈のためのプロキシとして使用される。ソース: https://arxiv.org/pdf/2004.00121.pdf
しかし、通常、これらの取り組みの結果は、最小限のポーズ操作や「情報のない」表情/アフェクトの変更に限定されている。

StyleRig では制御レベルが向上するが、時間的に一貫した髪の毛の問題は未解決のままである。ソース: https://www.youtube.com/watch?v=eaW_P85wQ9k
同様の出力は、Mitsubishi Research の MOST-GAN からも得られるが、非線形 3DMM を解離アーキテクチャとして使用する 2021 年の 論文 であり、動的かつ一貫した動きの実現に苦労している。
最新の研究では、One-Shot Face Reenactment on Megapixels が、StyleGAN に対する 3DMM パラメトリックヘッドをフレンドリーなインターフェイスとして使用している。

One-Shot Face Reenactment の MegaFR ワークフローでは、ネットワークは、実世界の画像を潜在表現へ逆変換したものと、レンダリングされた 3DMM モデルから取得されたパラメータを組み合わせて、フェイシャル合成を実行する。ソース: https://arxiv.org/pdf/2205.13368.pdf
OSFR は、Photoshop/After Effects スタイルの線形編集ワークフローを開発することを目指す、GAN フェイスエディターの成長するクラスの一つであり、ユーザーは、潜在空間で人物のアイデンティティに対応するコードを探す代わりに、希望する画像を入力して変換を適用できる。
また、パラメトリックな表情は、個人化されていない方法で表情を注入するための包括的な方法を表し、必ずしも肯定的ではない独特の意味で「不気味」な操作につながる。

OSFR での注入された表情。
先行研究と同様に、OSFR は、シングルイメージからほぼオリジナルのポーズを推測し、さらに「フロンタライゼーション」を行うことができ、オフセンターのポーズの画像をマグショットに変換することができる。

新論文で説明されるOSFR実装の元画像(上)と、推論された正面ポートレート。
実践では、このような推論は、Neural Radiance Fields (NeRF) を支える写真測量の原理と似ており、ただし、NeRF では 3 から 4 つの視点が必要であるのに対し、ここでは単一の写真によって幾何学が定義される。NeRFは複数の視点から欠けた中間姿勢を推定し、人が登場する探索可能なニューラル3Dシーンを生成する。
(ただし、NeRFも必要なすべて™ではない。顔動画合成では、GANとはほぼ完全に異なる障害に直面する。)
GAN はフェイシャルビデオ合成に役割があるか?
単一のソースイメージから動的な表情や学習分布外のポーズを達成することは、現在の GAN フェイシャル合成研究におけるアルケミーのような執念のようです。なぜなら、GAN は現在、高解像度と比較的高い忠実度のニューラルフェイスを出力する唯一の方法だからである。オートエンコーダーのディープフェイクフレームワークは、数多くの実世界のポーズや表情でトレーニングすることができるが、VRAM 制約された入力/出力解像度で動作し、ホストが必要である。NeRF は同様に制約されており、現在、顔の表情を変更するための確立された方法論がなく、編集可能性も限られている。
正確な CGI/GAN フェイス合成システムの唯一の前進方向は、新しい取り組みが潜在空間内でマルチフォトアイデンティティエンティティを組み立てる方法を見つけることである。潜在コードが、関連する(実世界の)画像を変換の参照として参照できるように、無関係な姿勢パラメータを利用するために潜在空間全体を横断する必要はない。
そのような場合にあっても、または StyleGAN ネットワーク全体が単一のアイデンティティフェイスセット(オートエンコーダーが使用するトレーニングセットに似たもの)でトレーニングされた場合にあっても、欠けているセマンティックロジックは、セマンティックセグメンテーションやパラメトリック 3DMM フェイスなどの付随技術によって提供される必要があるが、その場合には、少なくともより多くの材料を扱うことになる。


