
Andersonの視点
アンドリュー・エンが機械学習における過剰適合の文化を批判する

 Unite.AI を Google の優先ソースに追加
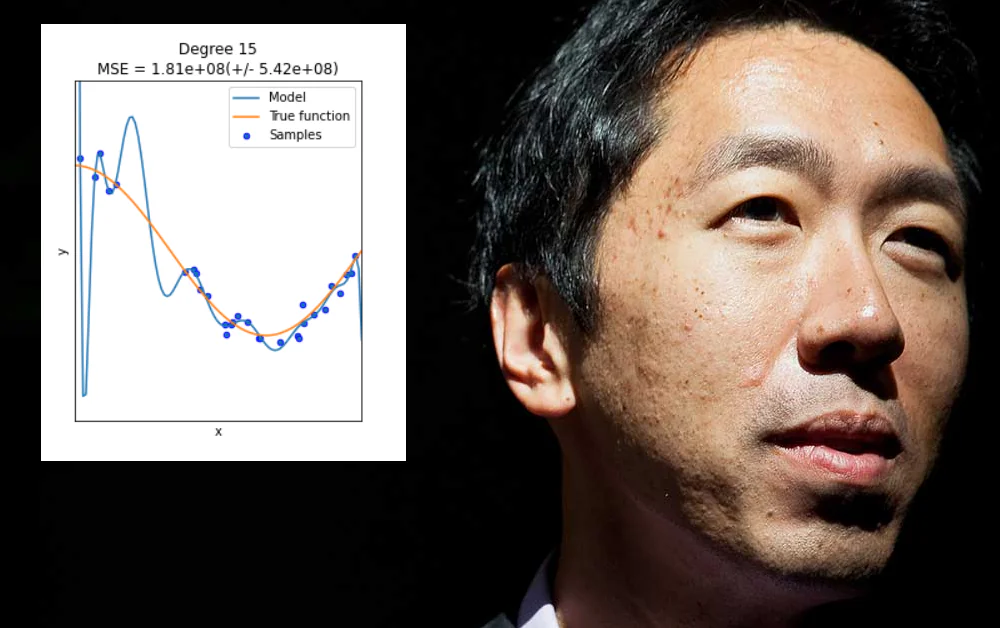
アンドリュー・エンは、過去10年間で最も影響力のある機械学習の声の一人であり、現在、モデルのアーキテクチャーにおける革新よりもデータに対する重点を置くことの重要性について懸念を表明しています。特に、過剰適合した結果が一般化された解決策または進歩として描かれることを許すことについて懸念しています。
これは、機械学習の文化に対する包括的な批判であり、最高権威の一人から発せられたものです。これは、60年間で3回目のAI開発におけるビジネス上の信頼性の低下という懸念に直面している分野に対する信頼性への影響をもたらします。
スタンフォード大学の教授であり、deeplearning.aiの創設者でもあるエンは、3月に組織のサイトに声明を公開しました。この声明は、彼の最近のスピーチを2つの核心的な勧告に凝縮しています。
第一に、研究コミュニティは、データクリーニングが機械学習の課題の80%を占めていると主張するのを止め、ロバストなMLOps方法論と実践の開発に着手すべきです。
第二に、過剰適合によって得られる「簡単な勝利」から離れ、広く適用可能なモデルを開発する必要があります。そうすれば、モデルは特定のデータセットに対してのみ優れたパフォーマンスを発揮するのではなく、より広い範囲のデータ環境に対して一般化できるようになります。
データアーキテクチャーとキュレーションの挑戦を受け入れる
エンは、「私の見解は、データ準備が私たちの仕事の80%を占める場合、データ品質を確保することが機械学習チームの重要な仕事である」と書いています。
彼は続けています:
「エンジニアがデータセットを改善するための最良の方法を偶然に発見するのではなく、AIシステムを構築する際に、高品質のデータセットを構築することを含む、繰り返し実行可能で体系的なMLOpsツールを開発できることを希望します。」
「MLOpsは新しい分野であり、異なる人々が異なる定義を与えています。しかし、私は、MLOpsチームとツールの最も重要な原則は、プロジェクトのすべての段階でデータの安定した流れを確保することであると考えています。これにより、多くのプロジェクトがよりスムーズに進むことができます。」
4月末にZoomで行われたQ&Aセッションで、エンは放射線学における機械学習分析システムの適用性の欠如について話しました:
「スタンフォード病院からデータを収集し、同じ病院のデータでトレーニングとテストを行うと、確かに、特定の条件を人間の放射線技師と同等の精度で検出できることを示す論文を発表できます。」
「しかし、同じモデル、同じAIシステムを、道を挟んで反対側にある古い病院に持っていくと、古い機械で、技術者が少し異なる画像化プロトコルを使用すると、データのドリフトが発生し、AIシステムの性能が大幅に低下します。一方、人間の放射線技師は、道を挟んで反対側にある古い病院に行って、問題なく仕事をこなすことができます。」
下位仕様は解決策ではない
過剰適合は、機械学習モデルが特定のデータセット(またはデータの形式)に合わせて設計されたときに発生します。これには、特定のデータセットに対してのみ優れた結果を生み出す重みを指定することが含まれますが、他のデータセットに対しては一般化しません。
多くの場合、パラメータは、トレーニングセットの「非データ」側面、たとえば収集された情報の特定の解像度やその他の固有の特徴に基づいて定義されます。これらの特徴は、他のデータセットでも再現される可能性は低いです。
理想的には、データアーキテクチャーまたはモデル設計の柔軟性や範囲を盲目的に広げることで、過剰適合の問題を解決できるかもしれません。しかし、実際には、広く適用可能な特徴や、高い精度を持つ特徴が必要です。これらは、さまざまなデータ環境で優れたパフォーマンスを発揮できるものでなければなりません。
一般的に、この種の「下位仕様」は、エンが最近指摘した問題、つまり機械学習モデルが未知のデータで失敗する問題を引き起こします。ただし、この場合は、モデルが過剰適合した元のトレーニングセットとデータ形式が異なるためではなく、モデルがあまりにも柔軟であるため失敗します。
2020年後半に、論文「Underspecification Presents Challenges for Credibility in Modern Machine Learning」が発表され、GoogleやMITを含む機関の40人以上の機械学習研究者や科学者が名前を連ねました。
この論文は、「ショートカット学習」と呼ばれる慣行を批判し、未仕様のモデルがトレーニング開始時のランダムなシードポイントに基づいて、予期せぬ方向に進む可能性があることを観察しています。寄稿者は次のように述べています:
「実践的な機械学習パイプラインでは、下位仕様が普遍的に存在することを確認しました。実際、下位仕様により、重要な決定の側面は、パラメータ初期化に使用されるランダムなシードなどの任意の選択によって決定されます。」
文化の変化の経済的影響
エンは、学術的な資格を持つだけでなく、Google BrainやCourseraの共同創設者、BaiduのビッグデータおよびAIの元チーフサイエンティスト、Landing AIの創設者として、高いレベルの産業経験を持っています。Landing AIは、セクターの新しいスタートアップ企業に1億7500万ドルを管理しています。
彼が「AI全体、ヘルスケアに限らず、概念実証から本稼働へのギャップがある」と述べているのは、現在の分野が長期的なビジネス投資として不確実であると見なされていることを示唆しています。分野は定義と範囲の問題に直面しています。
しかし、特定の環境でのみ優れたパフォーマンスを発揮するが、他の環境では失敗する独自の機械学習システムは、競合他社が複製するのが困難な市場を獲得する可能性があります。過剰適合の問題を職業上のハザードとして提示することは、オープンソース研究への企業投資を金銭化し、競合他社が複製するのが困難なシステムを生成する方法です。
このアプローチが長期的に機能するかどうかは、機械学習の実質的なブレークスルーが、ますます多くの投資を必要とするかどうかに依存します。さらに、すべての生産的なイニシアチブが、運用とホスティングに必要な大量のリソースのため、FAANGに何らかの形で移行する必要があるかどうかに依存します。
oach would work in the long term depends on the extent to which real breakthroughs in machine learning continue to require ever-greater levels of investment, and whether or not all productive initiatives will inevitably migrate to FAANG to some extent, due to the colossal resources necessary for hosting and operations.


