IAG et IA du futur
Qu’est‑ce que le test de Turing et pourquoi est‑il important ?

 Ajouter Unite.AI à vos sources préférées sur Google
Le test de Turing provient de l’article de 1950 d’Alan Turing, « Computing Machinery and Intelligence ». Au lieu de tenter de définir la pensée, Turing a proposé un jeu d’imitation: un interrogateur humain échange des messages écrits avec des participants invisibles et décide lequel est humain et lequel est une machine.
Le test reste influent car il transforme une question philosophique abstraite en une interaction observable. Il est toutefois limité: paraître humain dans une conversation n’est pas équivalent à être véridique, érudit, sûr, conscient ou généralement intelligent.
Points clés
- Le jeu d’imitation original de Turing est un test comportemental basé sur le texte, et non une liste de contrôle de propriétés cognitives internes.
- Les résultats dépendent de l’évaluateur, de l’invite, de la durée, des consignes aux participants et de la règle de notation.
- Un modèle peut imiter la conversation humaine tout en hallucinent des faits ou en échouant à de simples tests de robustesse.
- L’évaluation moderne nécessite des métriques de tâche, des tests adversariaux, une révision humaine et des preuves spécifiques aux risques en plus de la conversation.
Le jeu d’imitation de Turing
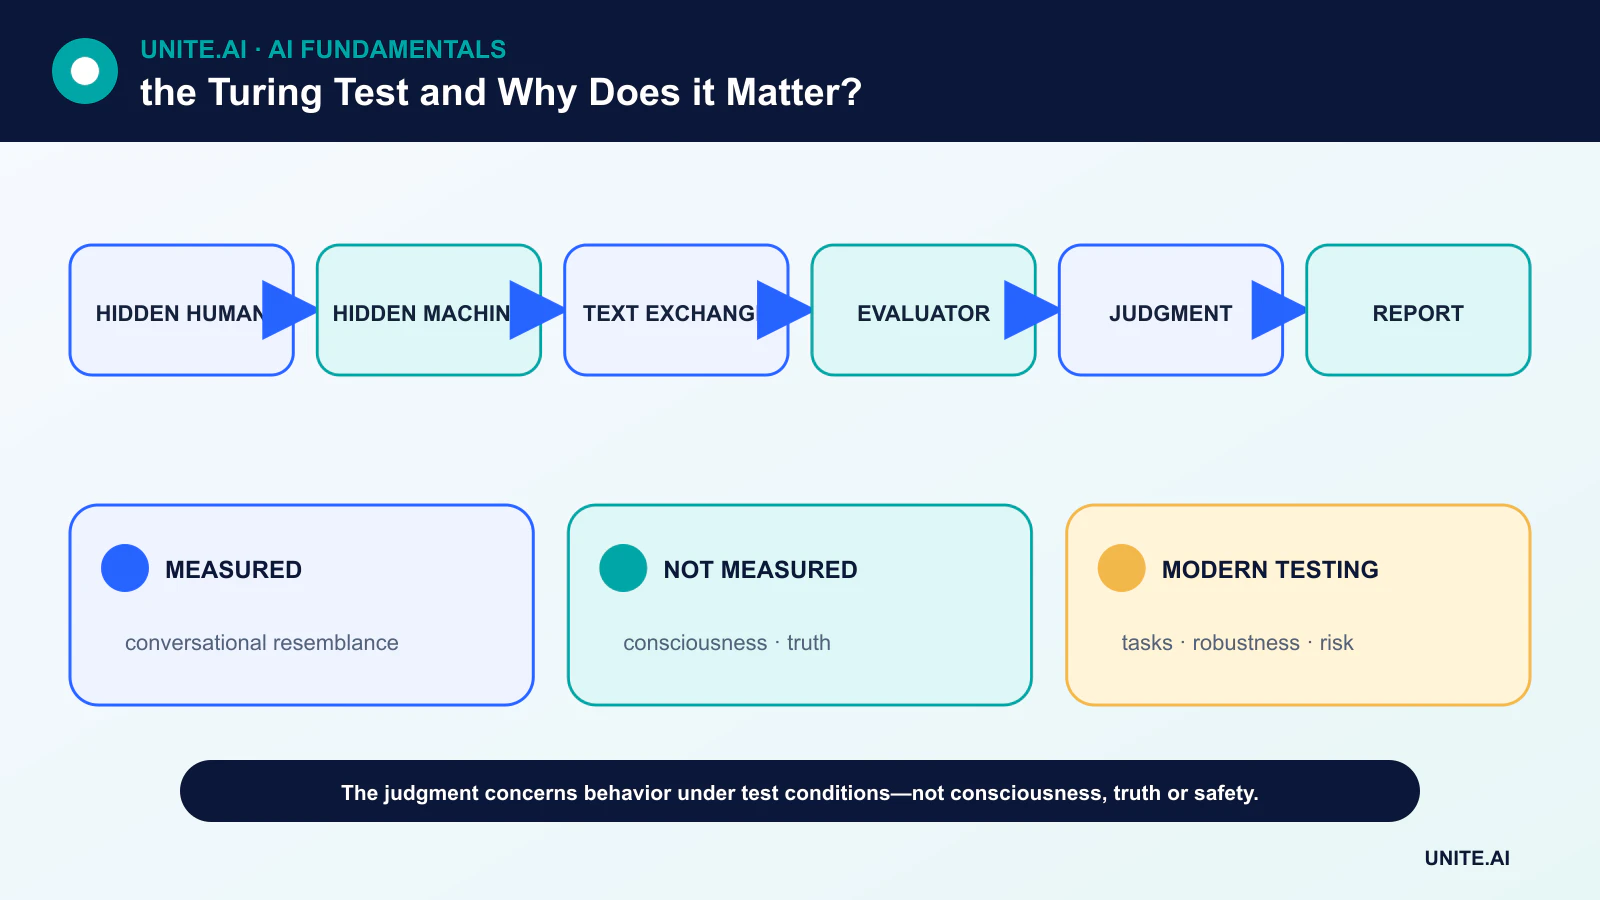
Dans la configuration originale, un interrogateur communiquait à distance afin que la voix et l’apparence ne révèlent pas l’identité. Turing se demandait si une machine pouvait se comporter suffisamment bien dans le jeu pour qu’un évaluateur ne puisse pas la distinguer de façon fiable d’une personne.
Cette formulation opérationnelle évitait la nécessité de fixer une définition unique de la pensée. Elle ne prétendait pas que chaque échange convaincant prouve l’intelligence, ni ne spécifiait un seuil de réussite universel applicable à toute démonstration ultérieure de chatbot.
Ce que mesure réellement un résultat
Un essai mesure l’indistinguabilité comportementale dans des conditions définies. Des conversations courtes, des juges inexpérimentés ou des invites choisies par le concepteur du système peuvent faciliter la tâche. Un rapport rigoureux doit divulguer la sélection des transcriptions, le nombre et le profil des juges, les humains de comparaison, la limite de temps et la méthode statistique.
Un système peut également exploiter les attentes: l’évitement, l’humour, les fautes typographiques et le jeu de rôle peuvent sembler humains sans démontrer un raisonnement fiable. Inversement, une réponse humaine exceptionnellement formelle peut être classée à tort comme générée par une machine.
Ce que le test de Turing n’établit pas
Le test ne mesure pas directement la conscience, l’expérience subjective, la précision factuelle, la compréhension causale ou la responsabilité morale. Il ne révèle pas les données d’entraînement, l’architecture du modèle ou les modes de défaillance en dehors de la conversation. Il en dit également peu sur l’intelligence non linguistique telle que la manipulation physique.
Les systèmes de langage modernes sont construits avec des réseaux neuronaux de type transformer et du deep learning, mais leurs productions fluides peuvent encore être générées à partir d’une structure statistique apprise plutôt que d’un modèle du monde vérifié.
Comment l’évaluation moderne de l’IA élargit la question
L’évaluation contemporaine utilise des ensembles de tâches réservés, une incertitude calibrée, des tests de robustesse, du red‑team, des vérifications de factualité et des études de préférence humaine. Une métrique de classification de texte peut tester un comportement défini, tandis qu’une évaluation basée sur des scénarios peut vérifier si un système suit la politique sous pression.
Aucun benchmark unique ne capture chaque déploiement. La contamination des tests peut gonfler les scores, et les benchmarks statiques encouragent le surapprentissage. L’évaluation doit être répétée à mesure que les modèles, les données, les invites, les outils et les populations d’utilisateurs évoluent.
Pourquoi le test reste pertinent
Le test de Turing a anticipé une leçon fondamentale de l’évaluation de l’IA: évaluer la capacité observable plutôt que de se fier à des affirmations sur une essence interne. Il nous oblige également à nous demander quels comportements humains comptent comme preuve et comment une configuration expérimentale façonne une conclusion.
Sa meilleure utilisation moderne est comme repère historique et conceptuel. Réussir un jeu d’imitation peut être intéressant, mais les décisions de déploiement exigent des preuves liées à la tâche réelle, aux utilisateurs concernés et aux préjudices prévisibles.
Ce que mesure le test de Turing
Le jeu d’imitation d’Alan Turing demandait si un interrogateur communiquant par texte pouvait distinguer de façon fiable une machine d’une personne. Il a reformulé un débat abstrait sur la capacité des machines à penser en une expérience conversationnelle observable. Le test dépend des participants, de la durée, du protocole, des sujets et de la règle de jugement ; il n’existe pas de score universel unique. Réussir signifie produire des réponses semblables à celles d’un humain dans ce cadre. Il ne mesure pas directement la précision factuelle, le raisonnement, la conscience, l’autonomie, la perception, l’incarnation, la fiabilité ou un comportement bénéfique dans le monde réel.
L’imitation humaine peut récompenser l’évitement, le rôle, les erreurs, l’humour ou la manipulation. Un juge peut confondre un humain avec une machine ou être influencé par les attentes, la langue et le contexte culturel. Les conversations courtes permettent des astuces qui échouent sur une interaction prolongée. Inversement, un système très utile pour les mathématiques, la traduction ou la modélisation de protéines peut échouer parce qu’il ne prétend pas être humain. Le test mesure donc une capacité sociale et linguistique façonnée par l’évaluateur, et non un classement complet de l’intelligence.
Modèles de langage modernes et évaluation renforcée
Les grands modèles de langage peuvent maintenir un dialogue fluide en prédisant des séquences à partir d’un vaste corpus d’entraînement puis d’un réglage ultérieur, mais la fluidité constitue une preuve faible de vérité ou de compréhension. Les schémas mémorisés, l’accès aux outils, les invites cachées, la latence et les paramètres d’échantillonnage influencent les résultats. Les évaluations contrôlées doivent divulguer le modèle et le protocole, prévenir les fuites d’information, inclure des questions adversariales et sectorielles, et noter l’incertitude ainsi que les citations. Une démonstration tirée de conversations réussies ne peut pas estimer la fiabilité sur l’ensemble de la distribution d’utilisation.
L’évaluation moderne est multidimensionnelle: précision des tâches, calibration, robustesse, cohérence à long terme, sécurité, biais, confidentialité, sécurité, efficacité et résultats humains. Les tests comportementaux doivent être complétés par des preuves de processus, du red‑team, des benchmarks reproductibles et une surveillance en conditions réelles. Les benchmarks peuvent saturer ou être intégrés aux données d’entraînement, d’où la nécessité d’ensembles de tests privés et actualisés. Pour les systèmes qui agissent, il faut évaluer séparément les permissions d’outils, la récupération et les conséquences, en dehors de la qualité de la conversation.
Pourquoi le test reste pertinent
Le test de Turing demeure historiquement important car il place le comportement au centre et souligne la difficulté de définir l’intelligence. Il soulève également des questions persistantes sur l’anthropomorphisme et la tromperie. Les interfaces devraient identifier les agents synthétiques plutôt que de considérer l’erreur d’identité comme une réussite, surtout dans des contextes à fort enjeu. Utilisez le test comme une lentille philosophique et comme une évaluation conversationnelle, et non comme une certification d’intelligence générale ou de personnalité. La question cruciale lors du déploiement est ce que le système peut faire de façon fiable, sur quelles preuves et limites, et qui est responsable en cas d’échec.
Exemple pratique : une évaluation conversationnelle contrôlée
Les évaluateurs comparent des humains et plusieurs systèmes d’IA dans des conversations textuelles à durée, sujets, langue et identités masquées fixes. Les juges notent s’ils pensent que chaque participant est humain et évaluent également la factualité, la cohérence, l’utilité, l’incertitude et la manipulation. Plusieurs juges et conversations permettent d’estimer la variation, et le protocole empêche les développeurs de modèles de choisir des transcriptions favorables. La mauvaise classification d’un humain fournit une base nécessaire pour interpréter le résultat.
Un système qui trompe les juges mais invente des faits n’est pas déclaré généralement intelligent, tandis qu’un modèle spécialisé clairement indiqué peut être très utile malgré un échec à l’imitation. Les résultats comprennent l’invite, le modèle, le mode d’échantillonnage, l’accès aux outils et les caractéristiques du juge. L’expérience est présentée comme un test de conversation semblable à celle d’un humain. Les décisions de déploiement utilisent des preuves distinctes pour la justesse de la tâche, la sécurité, la confidentialité et la récupération, et l’interface identifie l’agent plutôt que de transformer la tromperie en objectif du produit.
Preuves de mise en œuvre et préparation opérationnelle
Une décision de production nécessite plus qu’une démonstration réussie. Définissez les utilisateurs visés, l’environnement d’exploitation, les entrées, les sorties, les dépendances, le propriétaire et les conséquences de chaque défaillance importante. Établissez une base reproductible et un jeu d’évaluation versionné avant l’ajustement. Testez les cas ordinaires, les conditions limites, les entrées malformées ou manquantes, les changements de distribution, les pannes de dépendances, les usages abusifs, ainsi que les groupes ou environnements les plus susceptibles d’être sous‑servis. Mesurez la qualité de la tâche conjointement avec la calibration ou l’incertitude, la latence, le débit, le coût des ressources, l’accessibilité, la confidentialité et la sécurité. Enregistrez chaque transformation et seuil afin qu’un évaluateur indépendant puisse reproduire le résultat et distinguer les preuves d’un prototype attrayant.
Avant le lancement, attribuez l’autorité pour la mise en production, les exceptions, les modifications, le retour en arrière et la mise hors service. Utilisez un déploiement progressif, conservez une solution de secours sûre et vérifiez la surveillance avec des pannes intentionnellement injectées. La télémétrie opérationnelle doit révéler la qualité des entrées, le comportement des sorties, la version du modèle ou de la règle, l’état des dépendances, les interventions humaines et les résultats confirmés, sans collecter de données sensibles inutiles. Définissez les seuils d’alerte et le responsable de la réponse, puis examinez les preuves du monde réel après le déploiement plutôt que de supposer que la performance hors ligne persistera. Réévaluez chaque fois que les sources de données, les utilisateurs, les modèles, les fournisseurs, les politiques, le matériel ou les objectifs changent. Un système maintenu nécessite également des procédures documentées de récupération, d’apprentissage des incidents, de suppression et de conservation, ainsi qu’un point clair où il doit être désactivé ou remplacé.
Foire aux questions
Une IA a‑t‑elle définitivement réussi le test de Turing ?
Il n’existe aucune autorité officielle unique ni de protocole universellement accepté. Les démonstrations publiques utilisent des règles différentes, de sorte que les affirmations de « réussite » ne sont pas directement comparables.
Un échec au test prouve‑t‑il qu’un système est non intelligent ?
Non. Un système spécialisé peut être très performant sans imiter le style conversationnel humain.
Références principales