
Fondamentaux de l’IA
Qu’est‑ce que le compromis biais‑variance ? Sous‑apprentissage et sur‑apprentissage expliqués
Le compromis biais‑variance décrit la tension entre des modèles trop rigides pour saisir la structure réelle et des modèles qui réagissent trop fortement à l’échantillon d’entraînement particulier. Ce guide explique le mécanisme, les compromis, l’évaluation et les contrôles qui importent en pratique.

 Ajouter Unite.AI à vos sources préférées sur Google
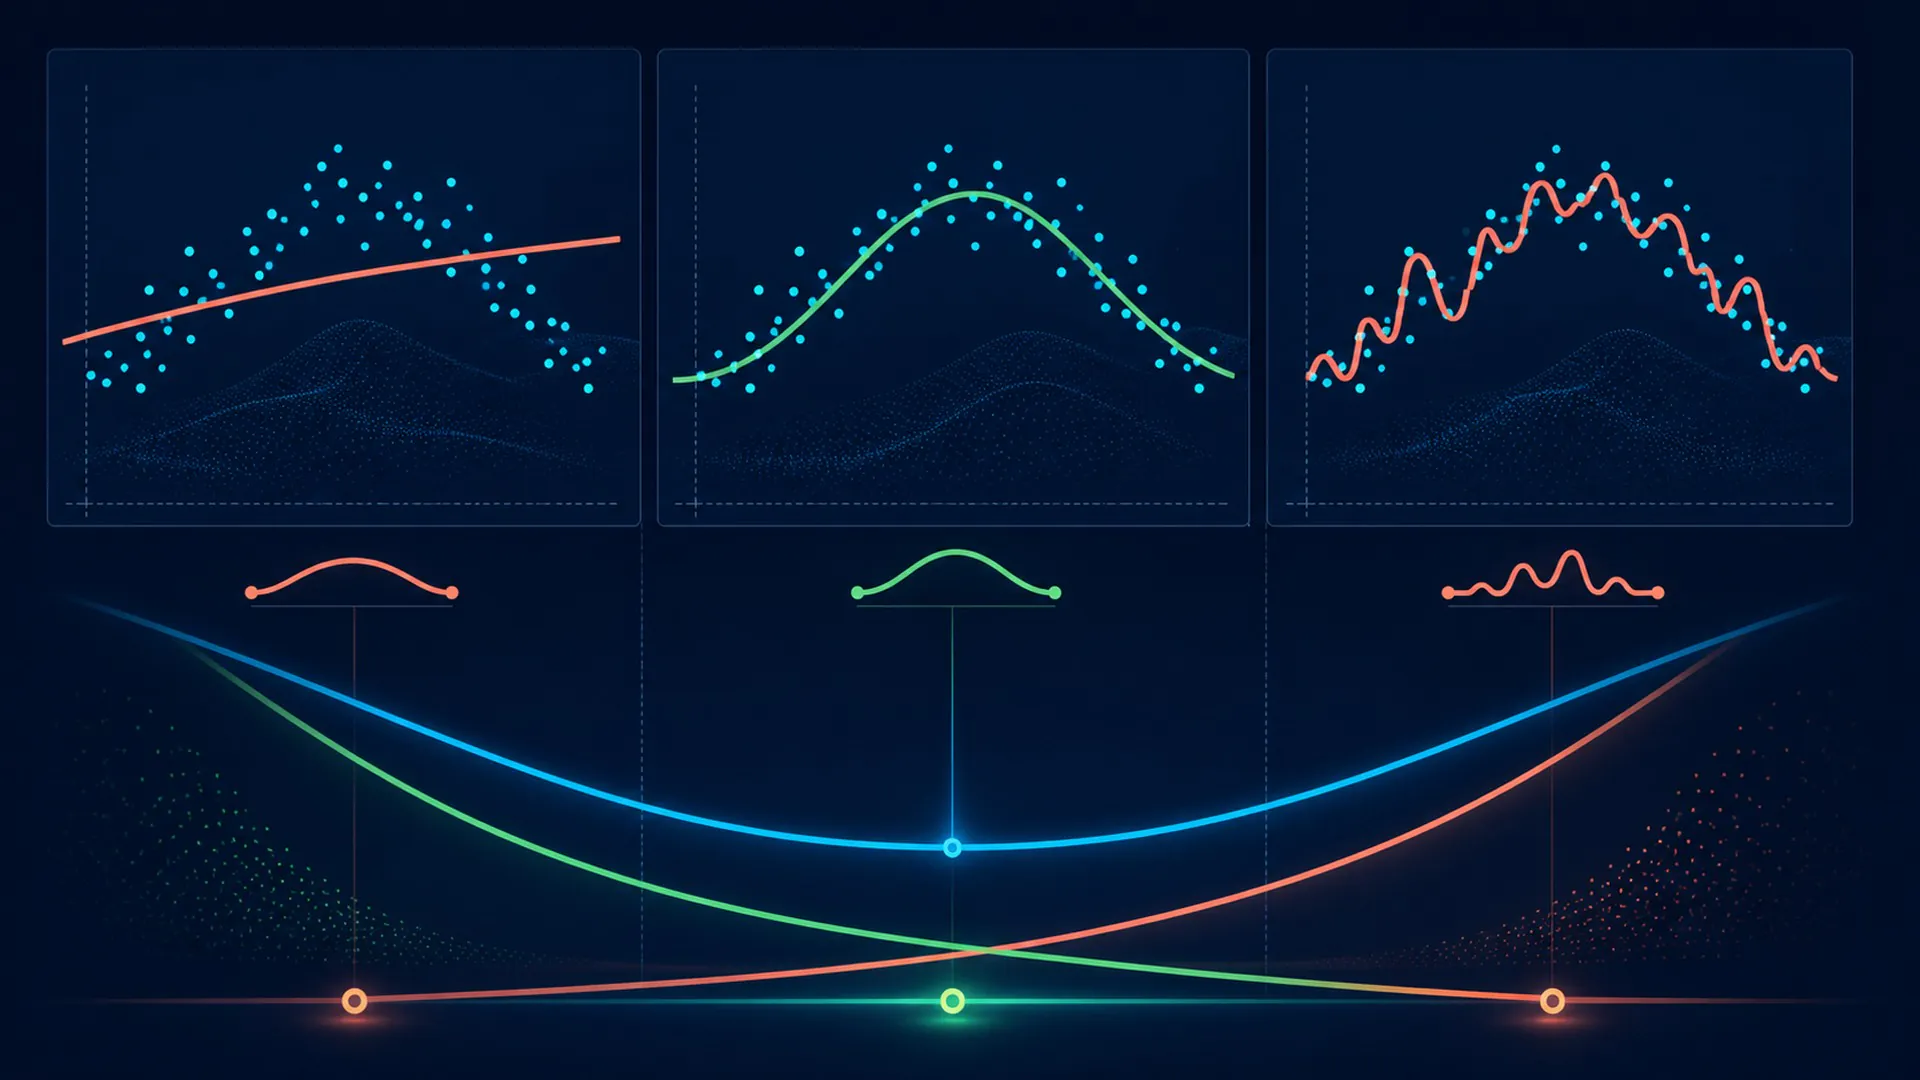
Le compromis biais‑variance décrit la tension entre des modèles trop rigides pour saisir la structure réelle et des modèles qui réagissent trop fortement à l’échantillon d’entraînement particulier.
Le compromis biais‑variance mérite une explication précise parce que son nom désigne un flux d’information, un choix d’entraînement, un mécanisme d’exécution ou une frontière de gouvernance particuliers. Le considérer comme synonyme d’« IA avancée » rend les affirmations impossibles à tester. Ce guide suit le concept depuis ses entrées et hypothèses jusqu’à son résultat observable, puis examine le raccourci le plus susceptible d’être confondu avec lui.
Compromis biais‑variance : définition, frontière et objectif
Le compromis biais‑variance décrit la tension entre des modèles trop rigides pour saisir la structure réelle et des modèles qui réagissent trop fortement à l’échantillon d’entraînement particulier. La définition comporte trois engagements pratiques : il existe une entrée identifiable, une transformation ou décision caractéristique du compromis biais‑variance, et un résultat qui peut être évalué par rapport à un objectif déclaré. Si l’un de ces éléments manque, le terme peut décrire une aspiration plutôt qu’un mécanisme implémenté.
L’apprentissage statistique transforme des échantillons finis en affirmations sur des données futures. La division, l’optimisation, la régularisation, les métriques et la surveillance sont donc des composantes d’un même problème de généralisation plutôt que des techniques isolées de manuel. Pour le compromis biais‑variance, cette vision systémique est importante car la performance peut être déterminée par les données environnantes, les interfaces, le matériel, les autorisations et les personnes, même lorsque le modèle sous‑jacent reste inchangé. Une explication utile sépare donc le comportement appris du modèle du produit qui décide quand, où et avec quelle autorité ce comportement est utilisé.
Le raccourci trompeur le plus proche est la signification sociale ou démographique du biais dans l’IA responsable. Il peut partager une caractéristique visible avec le compromis biais‑variance, mais il modifie l’histoire causale : des preuves différentes établiraient le succès, des ressources différentes domineraient les coûts, et des contrôles différents préviendraient les préjudices. La frontière est donc opérationnelle plutôt que terminologique.
Une carte opérationnelle en cinq étapes du compromis biais‑variance
Le diagramme est une carte causale compacte du compromis biais‑variance, et non une affirmation selon laquelle chaque implémentation utilise cinq composants logiciels. Certains systèmes combinent les étapes et d’autres les répètent en boucle. La carte reste utile car elle oblige chaque changement d’information ou d’autorité à avoir un propriétaire, une entrée, une sortie et un test.
1. Ajuster un modèle avec une capacité limitée ou flexible : entrée et hypothèses dans le compromis biais‑variance
À ce stade du compromis biais‑variance, le système doit ajuster un modèle avec une capacité limitée ou flexible. La question utile ne porte pas seulement sur la survenue de cette opération, mais sur les informations qu’elle consomme, l’état qu’elle modifie et les preuves qui démontrent que la modification est valide. Un examinateur doit pouvoir distinguer l’opération de la signification sociale ou démographique du biais dans l’IA responsable et reproduire son résultat dans les mêmes conditions déclarées.
Le passage à cette étape du compromis biais‑variance commence par l’objectif déclaré et doit se terminer par un résultat pouvant soutenir la mesure de l’erreur d’entraînement et de validation. Enregistrez l’incertitude, les alternatives rejetées, l’utilisation des ressources et tout contrôle humain ou logiciel appliqué à la frontière. Cette trace permet aux équipes de détecter si une faible erreur d’entraînement peut masquer une généralisation fragile avant que la même faiblesse n’atteigne une sortie conséquente.
2. Mesurer l’erreur d’entraînement et de validation : représentation ou décision dans le compromis biais‑variance
À ce stade du compromis biais‑variance, le système doit mesurer l’erreur d’entraînement et de validation. La question utile ne porte pas seulement sur la survenue de cette opération, mais sur les informations qu’elle consomme, l’état qu’elle modifie et les preuves qui démontrent que la modification est valide. Un examinateur doit pouvoir distinguer l’opération de la signification sociale ou démographique du biais dans l’IA responsable et reproduire son résultat dans les mêmes conditions déclarées.
Le passage à cette étape du compromis biais‑variance commence par ajuster un modèle à capacité limitée ou flexible et doit se terminer par un résultat capable de soutenir le diagnostic d’un sous‑ajustement systématique versus une instabilité. Enregistrez l’incertitude, les alternatives rejetées, l’utilisation des ressources et tout contrôle humain ou logiciel appliqué à la frontière. Cette trace est l’endroit où les équipes peuvent détecter si une faible erreur d’entraînement peut masquer une généralisation fragile avant que la même faiblesse n’atteigne une sortie conséquente.
3. Diagnostiquer le sous‑ajustement systématique versus l’instabilité : transformation distinctive dans le compromis biais‑variance
À ce stade du compromis biais‑variance, le système doit diagnostiquer le sous‑ajustement systématique versus l’instabilité. La question utile ne porte pas seulement sur la survenue de cette opération, mais sur les informations qu’elle consomme, l’état qu’elle modifie et les preuves qui démontrent que le changement est valide. Un examinateur doit pouvoir distinguer l’opération du sens social ou démographique du biais dans l’IA responsable et reproduire son résultat dans les mêmes conditions déclarées.
Le passage à cette étape du compromis biais‑variance commence par mesurer l’erreur d’entraînement et de validation et doit se terminer par un résultat capable de soutenir l’ajustement des caractéristiques, des données, de la régularisation ou de la capacité. Enregistrez l’incertitude, les alternatives rejetées, l’utilisation des ressources et tout contrôle humain ou logiciel appliqué à la frontière. Cette trace est l’endroit où les équipes peuvent détecter si une faible erreur d’entraînement peut masquer une généralisation fragile avant que la même faiblesse n’atteigne une sortie conséquente.
4. Ajuster les caractéristiques, les données, la régularisation ou la capacité : contrainte et frontière de vérification dans le compromis biais‑variance
À ce stade du compromis biais‑variance, le système doit ajuster les caractéristiques, les données, la régularisation ou la capacité. La question utile ne porte pas seulement sur la survenue de cette opération, mais sur les informations qu’elle consomme, l’état qu’elle modifie et les preuves qui démontrent que le changement est valide. Un examinateur doit pouvoir distinguer l’opération du sens social ou démographique du biais dans l’IA responsable et reproduire son résultat dans les mêmes conditions déclarées.
Le passage à cette étape du compromis biais‑variance commence par diagnostiquer le sous‑ajustement systématique versus l’instabilité et doit se terminer par un résultat capable de soutenir la répétition sur des échantillons représentatifs. Enregistrez l’incertitude, les alternatives rejetées, l’utilisation des ressources et tout contrôle humain ou logiciel appliqué à la frontière. Cette trace est l’endroit où les équipes peuvent détecter si une faible erreur d’entraînement peut masquer une généralisation fragile avant que la même faiblesse n’atteigne une sortie conséquente.
5. Répéter sur des échantillons représentatifs : sortie, rétroaction et règle d’arrêt dans le compromis biais‑variance
À ce stade du compromis biais‑variance, le système doit répéter sur des échantillons représentatifs. La question utile ne porte pas seulement sur la survenue de cette opération, mais sur les informations qu’elle consomme, l’état qu’elle modifie et les preuves qui démontrent que le changement est valide. Un examinateur doit pouvoir distinguer l’opération du sens social ou démographique du biais dans l’IA responsable et reproduire son résultat dans les mêmes conditions déclarées.
Le passage à cette étape du compromis biais‑variance commence par ajuster les caractéristiques, les données, la régularisation ou la capacité et doit se terminer par un résultat capable de soutenir la surveillance ou une décision finale. Enregistrez l’incertitude, les alternatives rejetées, l’utilisation des ressources et tout contrôle humain ou logiciel appliqué à la frontière. Cette trace est l’endroit où les équipes peuvent détecter si une faible erreur d’entraînement peut masquer une généralisation fragile avant que la même faiblesse n’atteigne une sortie conséquente.
Lisez la carte du compromis biais‑variance en avant pour comprendre la production et en arrière pour diagnostiquer l’échec. L’analyse en avant interroge la façon dont une étape alimente la suivante. L’analyse en arrière part d’un résultat incorrect, lent, coûteux ou dangereux et retrace quelle hypothèse antérieure l’a permis. Le chemin inverse est souvent celui où une équipe découvre que l’erreur décisive s’est produite avant que le modèle ne génère quoi que ce soit.
Exemple appliqué du compromis biais‑variance
Une ligne droite sous‑ajuste une relation courbe, tandis qu’une courbe extrêmement ondulée mémorise le bruit ; une complexité intermédiaire peut mieux généraliser.
Cet exemple est instructif car le compromis biais‑variance peut être lié à des entrées observables, des états intermédiaires et un résultat plutôt que jugé à travers une démonstration soignée. Un test rigoureux construirait des cas ordinaires, difficiles et délibérément trompeurs autour du scénario, conserverait une référence sans la technique, et enregistrerait à la fois la performance moyenne et la gravité des échecs individuels.
Modifiez une hypothèse dans l’exemple du compromis biais‑variance et répétez l’analyse. Supprimez une entrée requise, introduisez un signal contradictoire, limitez la puissance de calcul, modifiez la population d’utilisateurs ou forcez le système à s’abstenir. Un mécanisme qui ne réussit que dans une démonstration soigneusement orchestrée n’a pas prouvé qu’il se généralise à l’environnement opérationnel.
Compromis biais‑variance vs. son raccourci le plus courant
Le compromis biais‑variance est souvent réduit au sens social ou démographique du biais dans l’IA responsable. Cette réduction supprime la frontière même qui définit le concept. Elle peut amener les acheteurs à comparer des produits incompatibles, les chercheurs à exagérer ce qu’une expérience démontre, et les opérateurs à surveiller le mauvais signal après le déploiement.
| Objectif | Réponse pratique |
|---|---|
| Définition | Le compromis biais-variance décrit la tension entre des modèles trop rigides pour saisir la structure réelle et des modèles qui réagissent trop fortement à l’échantillon d’entraînement particulier. |
| Confusion | la signification sociale ou démographique du biais dans l’IA responsable. |
| Risque | une faible erreur d’entraînement peut masquer une généralisation fragile. |
La comparaison doit également identifier l’unité d’analyse. Un article sur le compromis biais-variance peut isoler un modèle ou un algorithme, tandis qu’un service déployé ajoute la récupération, le routage, la mise en cache, les politiques, l’identité, les interfaces utilisateur et la surveillance. Deux produits peuvent utiliser le même terme d’en-tête tout en implémentant différentes parties de cette pile. Demandez quel composant effectue la transformation définissante et quels autres composants sont nécessaires pour le résultat rapporté.
Pourquoi le compromis biais-variance est important dans les systèmes d’IA actuels
Le compromis biais-variance est désormais crucial parce que les systèmes d’IA reçoivent des contextes plus étendus, davantage de modalités, plus de puissance de calcul en temps réel, un accès plus large aux outils et des liens plus profonds avec les décisions organisationnelles. Dans ces conditions, ce qui semblait autrefois être un détail de recherche peut déterminer la latence, la sécurité, l’accessibilité, le coût environnemental, la qualité du produit ou la responsabilité juridique.
La mesure pertinente n’est pas de savoir si le compromis biais-variance peut produire un résultat impressionnant. Il s’agit de savoir si la technique améliore un résultat qui compte dans des conditions représentatives et le fait de manière plus efficace qu’une base plus simple. Rapportez les distributions, les catégories d’échec, la latence de queue, l’utilisation des ressources et les sous‑groupes affectés plutôt que de condenser chaque résultat en une moyenne unique.
Choisissez les procédures en fonction de la structure des données et du coût décisionnel. Conservez les groupes et le temps, quantifiez l’incertitude, inspectez les découpes, verrouillez les tests finaux et vérifiez que les gains hors ligne survivent au déploiement. Appliqué spécifiquement au compromis biais-variance, ce discipline rend les preuves transportables : une autre équipe peut juger si le gain revendiqué est susceptible de résister à un modèle, une langue, une plateforme matérielle, un jeu de données, une population d’utilisateurs ou une tolérance au risque différents.
Avantages que le compromis biais-variance peut offrir
La raison la plus convaincante d’utiliser le compromis biais-variance est qu’il peut traiter directement le goulot d’étranglement visé. Selon l’implémentation, le bénéfice peut se manifester sous la forme d’un meilleur ancrage, d’une représentation plus fidèle, d’une généralisation améliorée, d’une latence réduite, d’un déplacement de mémoire moindre, d’une responsabilité plus claire ou d’une frontière plus sûre entre une proposition de modèle et une action réelle.
Les bénéfices doivent être exprimés en décisions et mesures. « Plus intelligent » n’est pas un critère d’acceptation pour le compromis biais-variance. Un objectif utile pourrait spécifier le taux d’erreur sur les cas difficiles, la récupération après des preuves contradictoires, le coût à un percentile du trafic, le temps de révision humaine, la calibration, ou le pourcentage d’actions maintenues dans une limite d’autorité définie.
Le mode d’échec qui définit le compromis biais-variance
La limitation centrale est qu’une faible erreur d’entraînement peut masquer une généralisation fragile. Cet échec n’est pas une réflexion secondaire à ajouter une fois le développement terminé. Il doit influencer la collecte de données, l’architecture, les autorisations, l’évaluation, les portes de mise en production et la surveillance du compromis biais-variance dès le départ.
Un contrôle du compromis biais‑variance n’est utile que s’il agit avant une conséquence coûteuse ou irréversible. Identifiez le premier précurseur observable de la défaillance, définissez un seuil ou une règle, attribuez un responsable et testez la récupération. Selon le cas d’usage, la récupération peut signifier s’abstenir, revenir à un système plus simple, demander davantage de preuves, escalader à une personne, revenir à une version antérieure du modèle ou arrêter complètement une action.
Un plan d’évaluation du compromis biais‑variance
Commencez l’évaluation du compromis biais‑variance en rédigeant la décision que les preuves doivent soutenir. Définissez la population opérationnelle, la conséquence d’un résultat erroné, les informations réellement disponibles au moment de la décision, et l’alternative crédible la plus simple. Cela empêche un benchmark de devenir l’objectif simplement parce qu’il est facile à exécuter.
Utilisez un jeu de test vierge pour des comparaisons contrôlées, puis validez le compromis biais‑variance dans un environnement opérationnel par étapes. L’évaluation hors ligne rend les variantes comparables ; le mode ombre, les canaris, les limites de débit ou les portes d’approbation révèlent comment le trafic réel, les boucles de rétroaction et les personnes modifient le comportement. La phase de déploiement doit comporter une condition d’arrêt explicite plutôt que de supposer que chaque amélioration mérite un déploiement complet.
Versionnez les entrées nécessaires pour reproduire le compromis biais‑variance : données sources, prétraitement, tokenizer ou encodeur, poids du modèle, configuration, invite ou politique, index de récupération, jeu d’évaluation, hypothèses matérielles et code de service le cas échéant. Sans traçabilité, une équipe ne peut pas déterminer si un résultat modifié provient de la technique, de l’environnement ou d’une modification non détectée du pipeline.
Enfin, demandez quel résultat invaliderait l’affirmation selon laquelle le compromis biais‑variance aide. Si aucun résultat ne peut inverser la décision d’adoption, l’évaluation relève du marketing. Des seuils d’acceptation pré‑engagés et un jeu de confirmation préservé transforment l’exercice en preuve.
Questions à poser avant d’adopter le compromis biais‑variance
- Objectif : Quel goulot d’étranglement mesurable le compromis biais‑variance est‑il censé résoudre ?
- Mécanisme : Quelle des cinq étapes contient la transformation distinctive ?
- Référence de base : Comment se compare‑t‑il à la signification sociale ou démographique du biais en IA responsable ou à une autre alternative plus simple ?
- Preuve : Quels cas ordinaires, difficiles, adversaires et de sous‑groupes ont été testés ?
- Opérations : Quels coûts de latence, de mémoire, de calcul, d’énergie, de maintenance et de révision apparaissent à grande échelle ?
- Risque : Comment l’équipe détectera‑t‑elle qu’une faible erreur d’entraînement peut masquer une généralisation fragile ?
- Récupération : Le système peut‑il s’abstenir, revenir en arrière, annuler ou escalader avant qu’un préjudice ne survienne ?
Sources principales pour étudier le compromis biais‑variance
Des points de départ autoritaires pour la partie de la pile IA entourant le compromis biais‑variance incluent guide de sélection de modèle scikit-learn, Règles de ML de Google, RMF IA du NIST. Lisez‑les en parallèle de la documentation du modèle exact, du jeu de données, du matériel et de la juridiction concernés. Une source générale peut définir le mécanisme, mais seules des preuves spécifiques au déploiement peuvent établir qu’une implémentation particulière est adaptée.
Ce qu’il faut retenir sur le compromis biais‑variance
Le compromis biais‑variance est un mécanisme défini au sein d’un système sociotechnique plus vaste. Sa valeur provient de l’amélioration d’un résultat spécifique sous des conditions explicites, et non du simple libellé. La carte à cinq étapes rend son flux d’information visible, la comparaison identifie ce qu’il n’est pas, et le chemin de contrôle montre où un opérateur responsable peut intervenir.
La règle pratique pour le compromis biais‑variance consiste à définir l’objectif, à le comparer à une référence crédible, à tester la défaillance la plus critique, et à conserver les preuves nécessaires pour surveiller le changement. Avec ces éléments en place, le concept devient un choix d’ingénierie et de gouvernance qui peut être évalué. Sans eux, il reste un nom prometteur attaché à un risque opérationnel inconnu.


