
Fondamentaux de l’IA
SGD vs. Adam : comment les optimiseurs d’apprentissage automatique apprennent réellement
La descente de gradient stochastique et Adam sont des algorithmes d’optimisation qui mettent à jour les paramètres du modèle à partir de gradients estimés, mais ils utilisent des règles différentes pour le momentum et les tailles de pas par paramètre. Ce guide explique le mécanisme, les compromis, l’évaluation et les contrôles qui importent en pratique.

 Ajouter Unite.AI à vos sources préférées sur Google
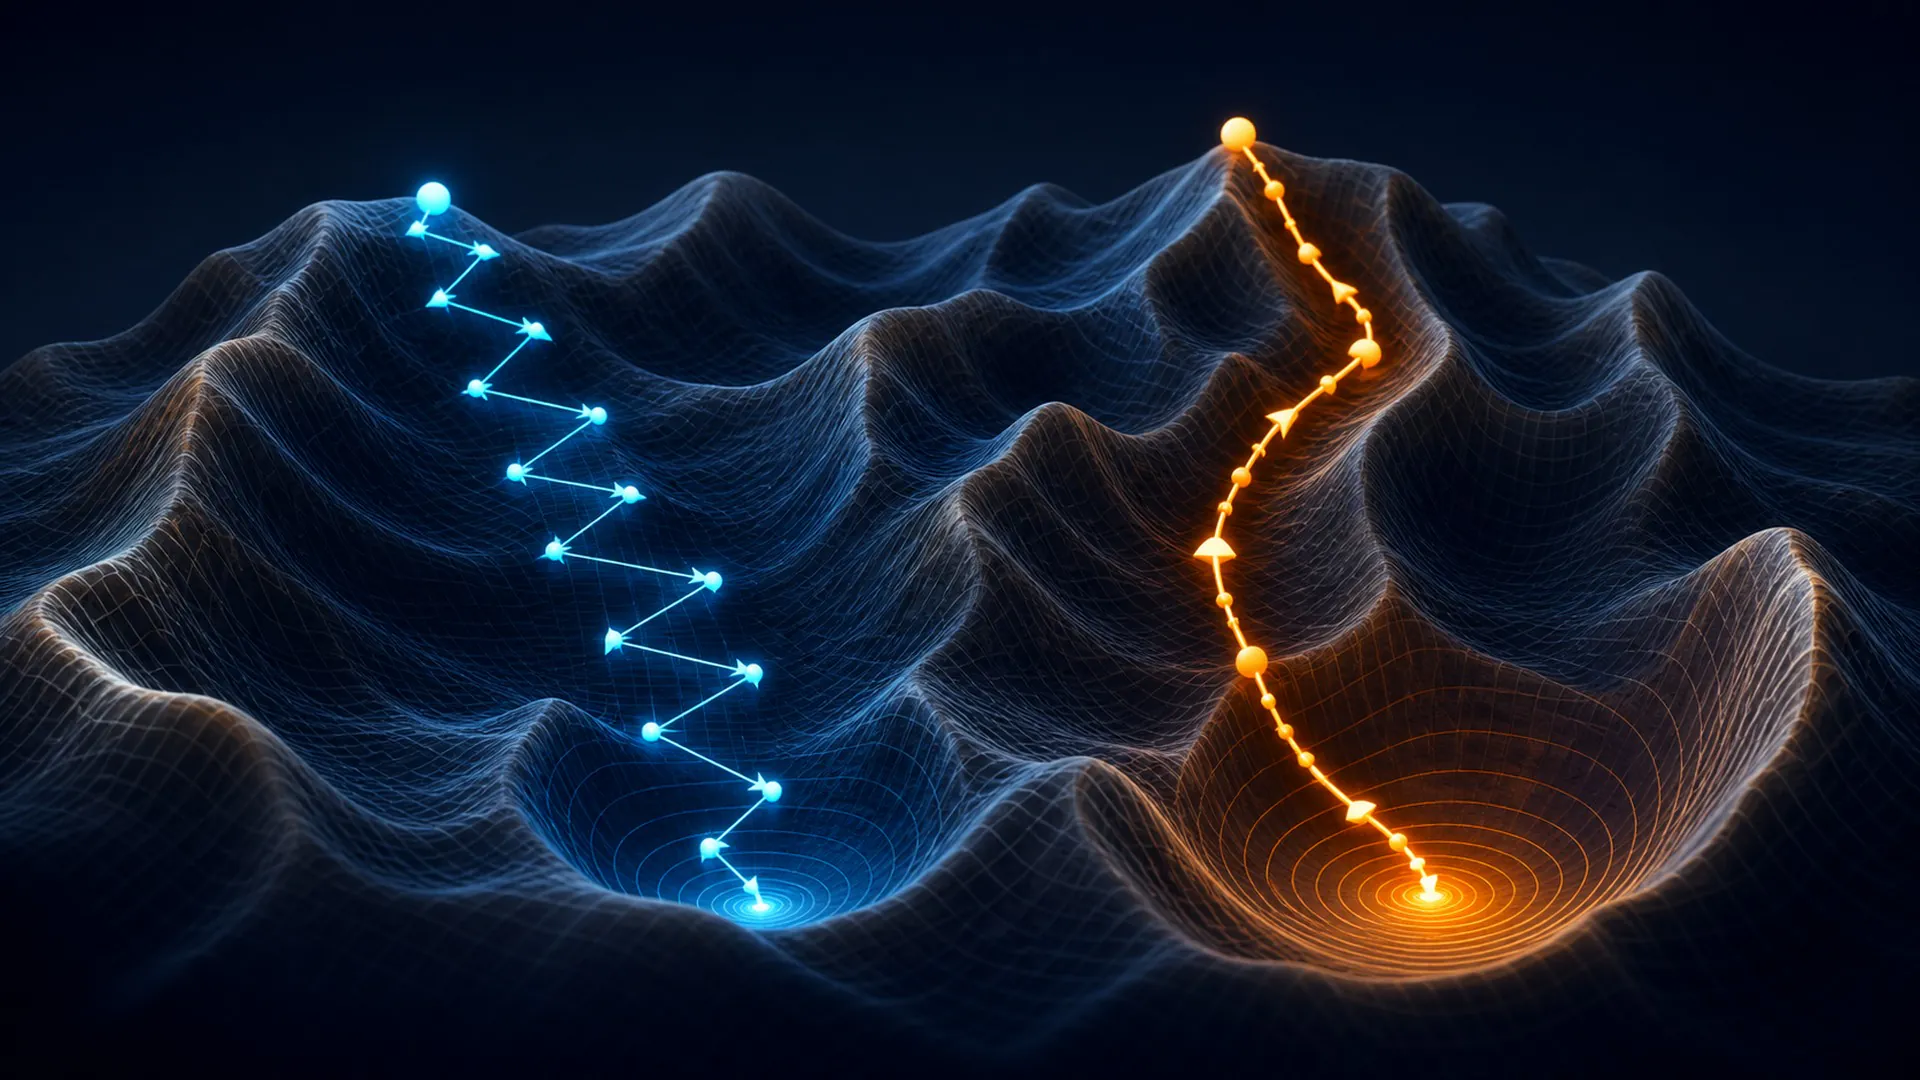
La descente de gradient stochastique et Adam sont des algorithmes d’optimisation qui mettent à jour les paramètres du modèle à partir de gradients estimés, mais ils utilisent des règles différentes pour le momentum et les tailles de pas par paramètre.
SGD et Adam méritent une explication précise parce que leur nom identifie un flux d’information particulier, un choix d’entraînement, un mécanisme d’exécution ou une frontière de gouvernance. Les considérer comme synonymes de « IA avancée » rend les affirmations impossibles à tester. Ce guide suit le concept depuis ses entrées et hypothèses jusqu’à son résultat observable, puis teste le raccourci le plus susceptible d’être confondu avec lui.
SGD et Adam : définition, frontière et objectif
La descente de gradient stochastique et Adam sont des algorithmes d’optimisation qui mettent à jour les paramètres du modèle à partir de gradients estimés, mais ils utilisent des règles différentes pour le momentum et les tailles de pas par paramètre. La définition comporte trois engagements pratiques : il existe une entrée identifiable, une transformation ou décision caractéristique de SGD et Adam, et un résultat qui peut être évalué par rapport à un objectif déclaré. Si l’un de ces éléments manque, le libellé peut décrire une aspiration plutôt qu’un mécanisme implémenté.
L’apprentissage statistique transforme des échantillons finis en affirmations concernant des données futures. La division, l’optimisation, la régularisation, les métriques et la surveillance sont donc des parties d’un même problème de généralisation plutôt que des techniques isolées de manuel. Pour SGD et Adam, cette vision système est importante car les performances peuvent être déterminées par les données environnantes, les interfaces, le matériel, les autorisations et les personnes, même lorsque le modèle sous‑jacent reste inchangé. Une explication utile sépare donc le comportement appris du modèle du produit qui décide quand, où et avec quelle autorité ce comportement est utilisé.
Le raccourci trompeur le plus proche est une méthode de recherche qui évalue des modèles complets sans gradients. Elle peut partager une caractéristique visible avec SGD et Adam, mais elle modifie l’histoire causale : des preuves différentes établiraient le succès, des ressources différentes domineraient les coûts, et des contrôles différents préviendraient les préjudices. La frontière est donc opérationnelle plutôt que terminologique.
Carte opérationnelle en cinq étapes de SGD et Adam
Le diagramme est une carte causale compacte pour SGD et Adam, et non une affirmation selon laquelle chaque implémentation utilise cinq composants logiciels. Certains systèmes combinent les étapes et d’autres les répètent dans une boucle. La carte reste utile car elle oblige chaque modification d’information ou d’autorité à disposer d’un propriétaire, d’une entrée, d’une sortie et d’un test.
1. Échantillonner un mini‑lot et calculer la perte : entrée et hypothèses dans SGD et Adam
À ce stade de SGD et Adam, le système doit échantillonner un mini‑lot et calculer la perte. La question pertinente ne porte pas seulement sur la survenue de cette opération, mais sur les informations qu’elle consomme, l’état qu’elle modifie et les preuves qui démontrent que la modification était valide. Un examinateur doit pouvoir distinguer cette opération d’une méthode de recherche qui évalue des modèles complets sans gradients et reproduire son résultat dans les mêmes conditions déclarées.
Le passage à cette étape de SGD et Adam commence avec l’objectif déclaré et doit se terminer par un résultat capable de soutenir la rétropropagation des gradients. Enregistrez l’incertitude, les alternatives rejetées, l’utilisation des ressources et tout contrôle humain ou logiciel appliqué à la frontière. Cette trace permet aux équipes de détecter si Adam peut converger rapidement tandis que SGD peut généraliser différemment, et les deux sont sensibles aux calendriers et à l’échelle avant que la même faiblesse n’atteigne une sortie conséquente.
2. Rétropropager les gradients : représentation ou décision dans SGD et Adam
À ce stade de SGD et Adam, le système doit rétropropager les gradients. La question pertinente ne porte pas seulement sur la survenue de cette opération, mais sur les informations qu’elle consomme, l’état qu’elle modifie et les preuves qui démontrent que la modification était valide. Un examinateur doit pouvoir distinguer cette opération d’une méthode de recherche qui évalue des modèles complets sans gradients et reproduire son résultat dans les mêmes conditions déclarées.
Le passage à cette étape de SGD et Adam commence par échantillonner un mini‑lot et calculer la perte, et doit se terminer par un résultat capable de prendre en charge l’accumulation du momentum ou des estimations de moments. Enregistrez l’incertitude, les alternatives rejetées, l’utilisation des ressources, ainsi que tout contrôle humain ou logiciel appliqué à la frontière. Cette trace est l’endroit où les équipes peuvent détecter si Adam peut converger rapidement tandis que SGD peut généraliser différemment, les deux étant sensibles aux plannings et à l’échelle avant que la même faiblesse n’atteigne une sortie conséquente.
3. Accumuler le momentum ou les estimations de moments : transformation distinctive dans SGD et Adam
À ce stade de SGD et Adam, le système doit accumuler le momentum ou les estimations de moments. La question utile n’est pas seulement de savoir si cette opération se produit, mais quelles informations elle consomme, quel état elle modifie, et quelles preuves démontrent que le changement était valide. Un examinateur devrait pouvoir distinguer l’opération d’une méthode de recherche qui évalue des modèles complets sans gradients et reproduire son résultat dans les mêmes conditions déclarées.
Le passage à cette étape de SGD et Adam commence par la rétropropagation des gradients et doit se terminer par un résultat capable d’appliquer la mise à jour des paramètres de l’optimiseur. Enregistrez l’incertitude, les alternatives rejetées, l’utilisation des ressources, ainsi que tout contrôle humain ou logiciel appliqué à la frontière. Cette trace est l’endroit où les équipes peuvent détecter si Adam peut converger rapidement tandis que SGD peut généraliser différemment, les deux étant sensibles aux plannings et à l’échelle avant que la même faiblesse n’atteigne une sortie conséquente.
4. Appliquer la mise à jour des paramètres de l’optimiseur : contrainte et frontière de vérification dans SGD et Adam
À ce stade de SGD et Adam, le système doit appliquer la mise à jour des paramètres de l’optimiseur. La question utile n’est pas seulement de savoir si cette opération se produit, mais quelles informations elle consomme, quel état elle modifie, et quelles preuves démontrent que le changement était valide. Un examinateur devrait pouvoir distinguer l’opération d’une méthode de recherche qui évalue des modèles complets sans gradients et reproduire son résultat dans les mêmes conditions déclarées.
Le passage à cette étape de SGD et Adam commence par l’accumulation du momentum ou des estimations de moments et doit se terminer par un résultat capable d’ajuster le planning du taux d’apprentissage et de répéter le processus. Enregistrez l’incertitude, les alternatives rejetées, l’utilisation des ressources, ainsi que tout contrôle humain ou logiciel appliqué à la frontière. Cette trace est l’endroit où les équipes peuvent détecter si Adam peut converger rapidement tandis que SGD peut généraliser différemment, les deux étant sensibles aux plannings et à l’échelle avant que la même faiblesse n’atteigne une sortie conséquente.
5. Ajuster le planning du taux d’apprentissage et répéter : sortie, rétroaction et règle d’arrêt dans SGD et Adam
À ce stade de SGD et Adam, le système doit ajuster le planning du taux d’apprentissage et répéter. La question utile n’est pas seulement de savoir si cette opération se produit, mais quelles informations elle consomme, quel état elle modifie, et quelles preuves démontrent que le changement était valide. Un examinateur devrait pouvoir distinguer l’opération d’une méthode de recherche qui évalue des modèles complets sans gradients et reproduire son résultat dans les mêmes conditions déclarées.
Le passage à cette étape de SGD et Adam commence par l’application de la mise à jour des paramètres de l’optimiseur et doit se terminer par un résultat capable de soutenir la surveillance ou une décision finale. Enregistrez l’incertitude, les alternatives rejetées, l’utilisation des ressources, ainsi que tout contrôle humain ou logiciel appliqué à la frontière. Cette trace est l’endroit où les équipes peuvent détecter si Adam peut converger rapidement tandis que SGD peut généraliser différemment, les deux étant sensibles aux plannings et à l’échelle avant que la même faiblesse n’atteigne une sortie conséquente.
Lisez la carte de SGD et Adam en avant pour comprendre la production et en arrière pour diagnostiquer les échecs. L’analyse en avant demande comment une étape alimente la suivante. L’analyse en arrière part d’un résultat incorrect, lent, coûteux ou dangereux et trace quelle hypothèse antérieure l’a permis. Le chemin inverse est souvent celui où une équipe découvre que l’erreur décisive s’est produite avant que le modèle ne génère quoi que ce soit.
Un exemple travaillé de SGD et Adam
Un modèle de vision peut utiliser AdamW pour un entraînement précoce stable ou le momentum SGD avec un planning soigneusement réglé.
Cet exemple est instructif parce que SGD et Adam peuvent être liés à des entrées observables, des états intermédiaires et un résultat, plutôt que jugés à travers une démonstration polie. Un test rigoureux construirait des cas ordinaires, difficiles et délibérément trompeurs autour du scénario, préserverait une ligne de base sans la technique, et enregistrerait à la fois la performance moyenne et la gravité des échecs individuels.
Modifiez une hypothèse dans l’exemple de SGD et Adam et répétez l’analyse. Supprimez une entrée requise, introduisez un signal contradictoire, limitez le calcul, modifiez la population d’utilisateurs, ou forcez le système à s’abstenir. Un mécanisme qui ne réussit que dans une démonstration soigneusement arrangée n’a pas prouvé qu’il se généralise à l’environnement opérationnel.
SGD et Adam vs. leur raccourci le plus courant
SGD et Adam sont souvent réduits à une méthode de recherche qui évalue des modèles complets sans gradients. Cette réduction élimine la frontière même qui définit le concept. Elle peut amener les acheteurs à comparer des produits dissemblables, les chercheurs à exagérer ce qu’une expérience démontre, et les opérateurs à surveiller le mauvais signal après le déploiement.
| Objectif | Réponse pratique |
|---|---|
| Définition | La descente de gradient stochastique et Adam sont des algorithmes d’optimisation qui mettent à jour les paramètres du modèle à partir de gradients estimés, mais ils utilisent des règles différentes pour le moment et les tailles de pas par paramètre. |
| Confusion | une méthode de recherche qui évalue des modèles complets sans gradients. |
| Risque | Adam peut converger rapidement tandis que SGD peut se généraliser différemment, et les deux sont sensibles aux plannings et à l’échelle. |
La comparaison doit également identifier l’unité d’analyse. Un article sur SGD et Adam peut isoler un modèle ou un algorithme, tandis qu’un service déployé ajoute la récupération, le routage, la mise en cache, la politique, l’identité, les interfaces utilisateur et la surveillance. Deux produits peuvent utiliser le même terme principal tout en implémentant différentes parties de cette pile. Demandez quel composant réalise la transformation définissante et quels autres composants sont nécessaires pour le résultat rapporté.
Pourquoi SGD et Adam sont importants dans les systèmes d’IA actuels
SGD et Adam sont désormais importants parce que les systèmes d’IA reçoivent des contextes plus larges, davantage de modalités, plus de puissance de calcul en temps réel, un accès plus étendu aux outils et des liens plus profonds avec les décisions organisationnelles. Dans ces conditions, ce qui semblait autrefois être un détail de recherche peut déterminer la latence, la sécurité, l’accessibilité, le coût environnemental, la qualité du produit ou la responsabilité juridique.
La mesure pertinente n’est pas de savoir si SGD et Adam peuvent produire un résultat impressionnant. Il s’agit de savoir si la technique améliore un résultat qui compte dans des conditions représentatives et le fait de manière plus efficace qu’une référence plus simple. Rapportez les distributions, les catégories d’échec, la latence de queue, l’utilisation des ressources et les sous‑groupes affectés plutôt que de condenser chaque résultat en une moyenne unique.
Choisissez les procédures en fonction de la structure des données et du coût de décision. Conservez les groupes et le temps, quantifiez l’incertitude, inspectez les découpes, verrouillez les tests finaux et vérifiez que les gains hors ligne survivent au déploiement. Appliqué spécifiquement à SGD et Adam, ce principe rend les preuves transportables : une autre équipe peut juger si le gain revendiqué est susceptible de survivre à un modèle, une langue, une plateforme matérielle, un jeu de données, une population d’utilisateurs ou une tolérance au risque différents.
Avantages que SGD et Adam peuvent offrir
La raison la plus forte d’utiliser SGD et Adam est qu’ils peuvent traiter directement le goulot d’étranglement visé. Selon l’implémentation, le bénéfice peut se manifester sous la forme d’un meilleur ancrage, d’une représentation plus fidèle, d’une généralisation améliorée, d’une latence réduite, d’un déplacement de mémoire moindre, d’une responsabilité plus claire ou d’une frontière plus sûre entre une proposition de modèle et une action réelle.
Les bénéfices doivent être exprimés en termes de décisions et de mesures. « Plus intelligent » n’est pas un critère d’acceptation pour SGD et Adam. Un objectif utile pourrait spécifier le taux d’erreur sur les cas difficiles, la récupération après des preuves contradictoires, le coût à un percentile du trafic, le temps de révision humaine, l’étalonnage, ou le pourcentage d’actions maintenues dans une limite d’autorité définie.
Le mode de défaillance qui définit SGD et Adam
La limitation centrale est qu’Adam peut converger rapidement tandis que SGD peut se généraliser différemment, et les deux sont sensibles aux plannings et à l’échelle. Cette défaillance n’est pas une réflexion tardive à ajouter une fois le développement terminé. Elle doit influencer la collecte de données, l’architecture, les autorisations, l’évaluation, les portes de mise en production et la surveillance de SGD et Adam dès le départ.
Un contrôle pour SGD et Adam n’est utile que s’il agit avant une conséquence coûteuse ou irréversible. Identifier le premier précurseur observable de la défaillance, définir un seuil ou une règle, attribuer un responsable, et tester la récupération. Selon le cas d’usage, la récupération peut signifier s’abstenir, revenir à un système plus simple, demander davantage de preuves, escalader à une personne, revenir à une version antérieure du modèle, ou arrêter complètement une action.
Un plan d’évaluation pour SGD et Adam
Commencez l’évaluation de SGD et Adam en rédigeant la décision que les preuves doivent soutenir. Définissez la population opérationnelle, la conséquence d’un résultat erroné, les informations réellement disponibles au moment de la décision, et l’alternative crédible la plus simple. Cela empêche un benchmark de devenir l’objectif simplement parce qu’il est facile à exécuter.
Utilisez un jeu de test vierge pour des comparaisons contrôlées, puis validez SGD et Adam dans un environnement opérationnel en étapes. L’évaluation hors ligne rend les variantes comparables ; le mode ombre, les canaris, les limites de débit ou les portes d’approbation révèlent comment le trafic réel, les boucles de rétroaction et les personnes modifient le comportement. L’étape de déploiement doit comporter une condition d’arrêt explicite plutôt que de supposer que chaque amélioration mérite un déploiement complet.
Versionnez les entrées nécessaires pour reproduire SGD et Adam : données sources, prétraitement, tokenizer ou encodeur, poids du modèle, configuration, invite ou politique, index de récupération, jeu d’évaluation, hypothèses matérielles et code de service le cas échéant. Sans traçabilité, une équipe ne peut pas déterminer si un résultat modifié provient de la technique, de l’environnement ou d’une modification non détectée du pipeline.
Enfin, demandez quel résultat invaliderait l’affirmation selon laquelle SGD et Adam aident. Si aucun résultat ne peut inverser la décision d’adoption, l’évaluation devient du marketing. Des seuils d’acceptation pré‑engagés et un jeu de confirmation préservé transforment l’exercice en preuve.
Questions à poser avant d’adopter SGD et Adam
- Objectif : Quel goulot d’étranglement mesurable SGD et Adam sont‑ils censés résoudre ?
- Mécanisme : Quelle des cinq étapes contient la transformation distinctive ?
- Référence de base : Comment cela se compare‑t‑il à une méthode de recherche qui évalue des modèles complets sans gradients ou à une autre alternative plus simple ?
- Preuve : Quels cas ordinaires, difficiles, adversaires et de sous‑groupes ont été testés ?
- Opérations : Quels coûts de latence, mémoire, calcul, énergie, maintenance et révision apparaissent à grande échelle ?
- Risque : Comment l’équipe détectera‑t‑elle que Adam peut converger rapidement tandis que SGD peut généraliser différemment, et que les deux sont sensibles aux plannings et à l’échelle ?
- Récupération : Le système peut‑il s’abstenir, revenir en arrière, annuler ou escalader avant qu’un préjudice ne survienne ?
Sources principales pour étudier SGD et Adam
Des points de départ autoritaires pour la partie de la pile IA entourant SGD et Adam incluent guide de sélection de modèle scikit-learn, Règles de ML de Google, RMF IA du NIST. Lisez‑les en parallèle de la documentation du modèle exact, du jeu de données, du matériel et de la juridiction concernés. Une source générale peut définir le mécanisme, mais seules des preuves spécifiques au déploiement peuvent établir qu’une implémentation particulière est adaptée.
Ce qu’il faut retenir sur SGD et Adam
SGD et Adam constituent un mécanisme défini au sein d’un système sociotechnique plus vaste. Sa valeur provient de l’amélioration d’un résultat spécifique sous des conditions explicites, et non du simple libellé. La carte à cinq étapes rend son flux d’information visible, la comparaison identifie ce qu’il n’est pas, et le chemin de contrôle montre où un opérateur responsable peut intervenir.
La règle pratique pour SGD et Adam consiste à définir l’objectif, à le comparer à une référence crédible, à tester la défaillance la plus critique, et à conserver les preuves nécessaires pour surveiller le changement. Avec ces éléments en place, le concept devient un choix d’ingénierie et de gouvernance qui peut être évalué. Sans eux, il reste un nom prometteur attaché à un risque opérationnel inconnu.


