
Entretiens
Piotr Tomasik, Co-Fondateur et Président de TensorWave – Série d’entretiens

 Ajouter Unite.AI à vos sources préférées sur Google
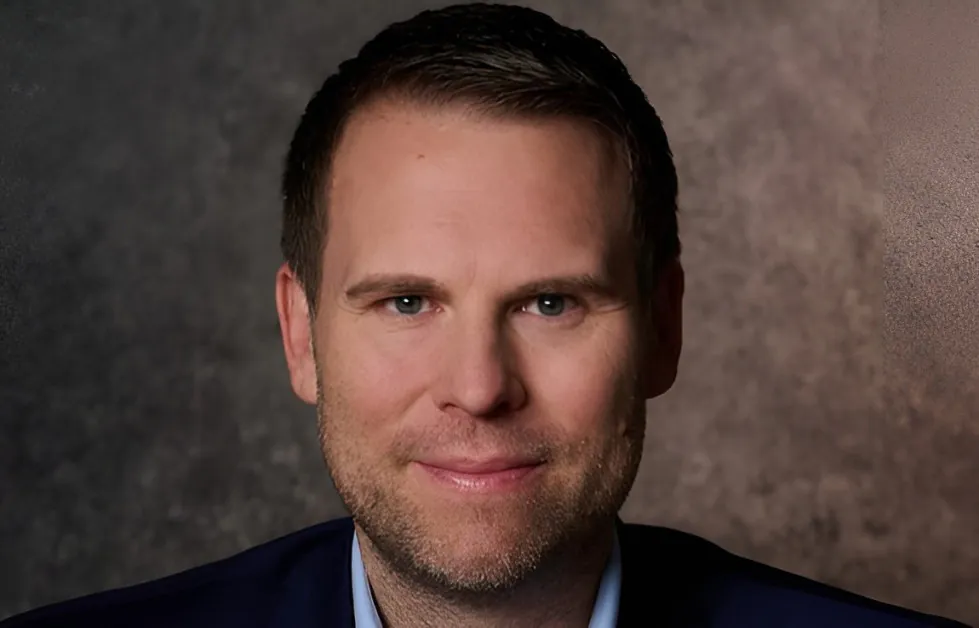
Piotr Tomasik, Co-Fondateur et Président de TensorWave, est un entrepreneur expérimenté dans le domaine de la technologie et un dirigeant d’infrastructure d’intelligence artificielle avec plus de deux décennies d’expérience dans les domaines de l’intelligence artificielle, du SaaS, du cloud computing, de la fintech et de l’économie créative. Avant de co-fonder TensorWave en 2023, il a co-fondé Influential, une plateforme de marketing d’influence alimentée par l’intelligence artificielle, qui a ensuite été acquise par Publicis pour environ 500 millions de dollars, où il a occupé le poste de directeur technique avant de passer à un rôle consultatif.
Au cours de sa carrière, Tomasik a également fondé ou dirigé des entreprises telles que Lets Rolo, On Guard Data et ActiveSide, tout en occupant des postes de direction dans les domaines de la technologie chez CARD.com et Marker Trax. En plus de ses rôles opérationnels, il est associé général du fonds 1864 et co-fondateur de StartUp Vegas, où il soutient activement l’écosystème des startups de Las Vegas et les talents émergents dans le domaine de la technologie. Diplômé en informatique de l’UNLV et leader technologique reconnu, Tomasik est devenu connu pour avoir aidé à positionner TensorWave en tant que société d’infrastructure de calcul d’intelligence artificielle à croissance rapide, axée sur les plates-formes cloud à grande échelle alimentées par des accélérateurs AMD.
TensorWave est une société d’infrastructure d’intelligence artificielle qui se concentre sur la fourniture de services de cloud computing à haute performance alimentés par des GPU AMD, se positionnant ainsi comme une alternative aux écosystèmes d’intelligence artificielle plus fermés. Fondée en 2023 et ayant son siège social à Las Vegas, l’entreprise construit de grands clusters de GPU optimisés pour la formation et le déploiement de modèles d’intelligence artificielle avancés, en mettant l’accent sur les performances, la flexibilité et l’efficacité coûts. En exploitant les écosystèmes de matériel et de logiciel ouverts, TensorWave vise à élargir l’accès aux ressources de calcul d’intelligence artificielle puissantes pour les entreprises, les chercheurs et les développeurs, permettant ainsi des charges de travail d’intelligence artificielle évolutives sans les contraintes de verrouillage traditionnel des fournisseurs.
Nvidia (NVDA ) domine la majeure partie du marché des GPU – pourquoi avez-vous décidé de miser tout sur AMD, et quels avantages cela apporte-t-il à TensorWave et à ses clients ?
À la suite du lancement de ChatGPT, la demande d’intelligence artificielle a explosé. Les GPU ont été rapidement pris et Nvidia était pratiquement la seule option, si vous pouviez l’obtenir, et si vous pouviez vous permettre le coût. Cette pénurie a suscité un grand intérêt pour les alternatives. Maintenant que nous sommes passés au-delà de l’hype initial, il y a une véritable opportunité de remettre en question la domination de Nvidia avec des solutions accessibles, rentables et faciles à utiliser.
En tant que startup, nous prenons toujours des décisions commerciales avec une forte concentration et un but. C’est pourquoi nous n’avons pas expérimenté avec Nvidia et que nous continuons à développer nos capacités sur AMD. La prochaine phase de notre entreprise consiste à nous appuyer sur ces capacités ciblées afin que tout le monde puisse se lancer et faire quelque chose de significatif avec l’intelligence artificielle. AMD est une alternative crédible avec une échelle de fabrication réelle, une posture logicielle ouverte et une feuille de route « mémoire d’abord » pour l’intelligence artificielle moderne.
Comment l’approche de TensorWave en matière d’infrastructure d’intelligence artificielle diffère-t-elle des fournisseurs de cloud GPU traditionnels ?
Notre différenciation est simple : nous sommes le seul cloud exclusif AMD à grande échelle, qui vise à rétablir le choix dans le calcul d’intelligence artificielle, à briser la domination de Nvidia et à démocratiser l’accès. Mais c’est également une question de notre éthos et de notre engagement à apporter une véritable alternative sur le marché. Tout d’abord et avant tout, nous voulons fournir une infrastructure exceptionnelle basée sur AMD à grande échelle. À partir de là, nous allons élargir nos services de niveau supérieur – Services de modèles, Services d’intelligence artificielle, en rendant tout plus simple.
En tant que cloud exclusif AMD, nous avons une expérience logicielle spécifiquement conçue pour AMD dès le premier jour. Cette concentration nous permet d’optimiser le silicium, le réseau et le logiciel de bout en bout, en garantissant que les équipes puissent évoluer lorsqu’elles en ont besoin.
Quel rôle joue votre partenariat stratégique avec AMD dans la croissance et la différenciation de TensorWave ?
C’est fondamental. AMD a investi dans TensorWave, nous a invités au lancement de MI300X Instinct et nous continuons à collaborer étroitement sur le matériel, la mise en œuvre logicielle et la croissance de l’écosystème. Être un cloud exclusif AMD signifie que nous pouvons avancer rapidement avec chaque génération d’Instinct, et servir de laboratoire vivant qui fournit, à grande échelle, des alternatives sur notre marché. Notre différenciation exclusive AMD nous a permis de travailler à un rythme qui n’est pas aussi réalisable sur le marché de l’infrastructure d’intelligence artificielle. Leur partenariat nous permet de combler les lacunes rapidement, de lancer les premiers les nouveaux GPU et de publier de véritables performances à grande échelle.
L’accès aux GPU reste un goulet d’étranglement majeur pour les équipes d’intelligence artificielle – comment TensorWave relève-t-il ce défi ?
Nous abordons ces goulets d’étranglement en premier lieu par l’indépendance d’approvisionnement : en nous appuyant sur AMD, nous évitons les pires contraintes d’approvisionnement des autres fabricants de puces, et nous passons l’availability à nos clients. L’indépendance d’approvisionnement via AMD garantit que nos clients ne sont pas bloqués dans la même file d’attente que tout le monde.
Les lacunes dans l’écosystème d’infrastructure d’intelligence artificielle existent parce que de nombreux acteurs construisent des solutions similaires, créant ainsi beaucoup de chevauchements. Cela provient souvent d’un manque de connaissance de ce qui se passe sur le marché. La première étape pour combler ces lacunes consiste à comprendre qui fait quoi, où il y a des opportunités de collaboration, où la concurrence peut stimuler l’innovation, et comment l’écosystème peut s’améliorer dans son ensemble. Une lacune unique dans le marché de l’infrastructure d’intelligence artificielle est le pouvoir ; même si les GPU sont disponibles, il n’y a souvent pas suffisamment d’énergie pour soutenir le nombre croissant d’applications d’intelligence artificielle. Résoudre ces défis de ressources est la clé pour permettre une croissance et une innovation durables dans les années à venir.
Comment des fonctionnalités telles que le refroidissement liquide direct et le réseau prêt UEC (Universal Ethernet Consortium) améliorent-elles les performances et l’efficacité coûts ?
Le refroidissement liquide direct et le réseau prêt UEC sont fondamentaux pour ce qui rend un cloud d’intelligence artificielle moderne économiquement viable à grande échelle, et les deux sont centraux dans la façon dont nous avons conçu TensorWave.
Sur le DLC : les nouvelles générations d’accélérateurs, les MI355X et MI455X d’AMD, fonctionnent à des enveloppes thermiques que l’air ne peut pas gérer efficacement. Nous parlons de 1400W+ TDP par GPU. Le refroidissement liquide direct supprime la chaleur à la source via des conceptions de plaque froide ou d’immersion, ce qui fait trois choses pour nos clients. Premièrement, cela permet une densité de rack nettement plus élevée, 120-300kW+ par rack au lieu de 30 à 40kW, ce qui comprime l’empreinte et réduit les coûts de distribution de puissance et de réal estate par mégawatt. Deuxièmement, cela pousse le PUE vers 1,1, contre 1,4 à 1,5 pour les installations refroidies à l’air traditionnelles ; à notre échelle, cela se traduit par des dizaines de millions de dollars d’économies d’utilité annuelle. Troisièmement, et souvent sous-estimé, le DLC maintient le silicium à des températures de jonction plus basses et plus stables, ce qui préserve les taux d’horloge soutenus pendant les longs entraînements et prolonge la durée de vie utile du matériel. Ce dernier point est extrêmement important lorsque vous souscrivez un actif sur six ans.
Sur l’UEC : la spécification du consortium Ethernet Ultra, qui a atteint 1,0 en 2025 et auquel AMD a contribué, nous donne un tissu marchand ouvert qui répond ou dépasse InfiniBand sur les métriques qui comptent vraiment pour la formation distribuée. La latence de queue sur les collectifs, la bande passante effective sous contention et le comportement de mise à l’échelle au-delà du seuil de 100 000 GPU. L’histoire des coûts est structurelle. L’Ethernet a une demi-douzaine de fournisseurs de silicium marchand crédibles qui concourent sur le prix, contrairement à une alternative à source unique qui comporte un premium bien documenté. Pour un site de 100 MW, choisir un réseau prêt UEC plutôt qu’un tissu propriétaire est généralement une décision de CAPEX à neuf chiffres, et les avantages opérationnels se cumulent car nos ingénieurs réseau connaissent déjà l’Ethernet.
Ces choix combinés nous permettent de fournir une meilleure économie de formation que les nuages traditionnels. Les clients voient des FLOPs effectifs plus élevés par dollar, des temps de pas plus prévisibles sur les grands travaux et une voie claire à mesure que les modèles évoluent. Pour nous, cela signifie une structure de coûts plus défendable et la flexibilité de proposer des tarifs réellement compétitifs.
Pouvez-vous partager des exemples de la façon dont les clients utilisent TensorWave pour former de grands modèles d’intelligence artificielle ?
Les clients de TensorWave ont besoin d’un calcul d’intelligence artificielle à haute performance sans pénurie de GPU, de verrouillage de fournisseur ou de coûts déraisonnables. TensorWave fournit un cloud exclusif AMD – ouvert, optimisé pour la mémoire et prêt pour la production – ce qui donne aux équipes une infrastructure d’intelligence artificielle évolutives qui est accessible, flexible et rentable.
Par exemple, Modular a choisi d’exécuter sa pile d’inférence MAX sur l’infrastructure de GPU AMD de TensorWave, car TensorWave offre une économie de coûts et de performances nettement supérieure pour l’inférence d’intelligence artificielle à grande échelle. En exécutant la pile MAX de Modular sur le calcul AMD de TensorWave, ils atteignent jusqu’à 70 % de réduction des coûts par million de jetons, 57 % de débit plus rapide et moins de coûts globaux que les autres piles de GPU.
Avec la domination continue de Nvidia, où voyez-vous les plus grandes opportunités pour les challengers comme TensorWave ?
Dans un espace de calcul d’intelligence artificielle dominé par quelques grands acteurs, les plus grands défis sont d’atteindre la vitesse de mise sur le marché, de livrer la dernière technologie et de fournir un soutien exceptionnel. Les hyperscalers offrent souvent une large gamme d’options, mais luttent pour fournir la concentration ou les conseils personnalisés dont les clients ont besoin. Pour percer dans cet espace dominé, TensorWave se concentre sur ses forces, tout en collaborant pour fournir la meilleure technologie possible et en garantissant que les clients ont des options alternatives.
Les deux plus grandes opportunités pour les challengers de la domination de l’infrastructure d’intelligence artificielle de Nvidia sont les écosystèmes ouverts et la mémoire. Les écosystèmes ouverts éliminent le verrouillage à chaque couche (matériel, interconnecteur et logiciel). De plus, la mémoire associée à la formation et à l’inférence optimisées pour le réseau inverse la courbe des coûts.
En regardant cinq ans à l’avance, comment voyez-vous l’avenir de l’infrastructure d’intelligence artificielle et le rôle de TensorWave à cet égard ?
Pendant des années, l’objectif de l’infrastructure d’intelligence artificielle était de la rendre bonne, stable et facile à utiliser. La prochaine phase sera axée sur ce que vous pouvez livrer par-dessus – des services gérés, des services d’intelligence artificielle, tout ce qui aide les clients à déployer et à évoluer plus facilement.
Nous sommes au début d’une grande transformation. La technologie d’intelligence artificielle continue de progresser, et des alternatives comme AMD sont de plus en plus viables. À mesure que cela se produit, les clients deviendront plus à l’aise pour les déployer à grande échelle, et l’ensemble de l’écosystème commencera à s’ouvrir et à croître.
Je vous remercie pour cette grande interview, quiconque voulant en savoir plus sur cette société d’infrastructure d’intelligence artificielle innovante devrait visiter TensorWave.


