
Entretiens
Dr Mathilde Pavis, Responsable Juridique, OpenOrigins – Série d’entretiens

 Ajouter Unite.AI à vos sources préférées sur Google
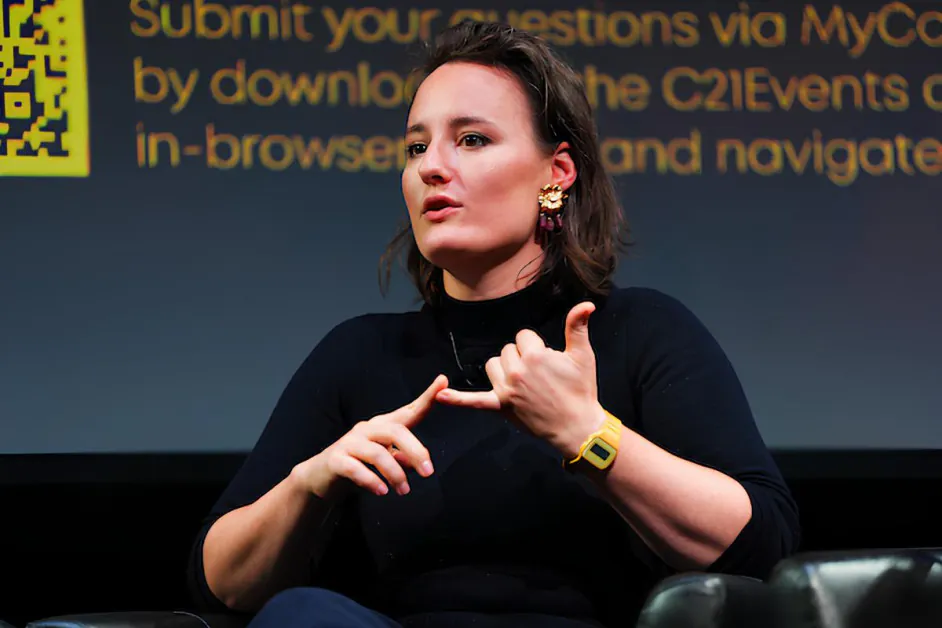
Dr Mathilde Pavis, Responsable Juridique d’OpenOrigins, est une experte de premier plan en matière de régulation de l’IA et de gouvernance des médias numériques, spécialisée dans les deepfakes, les médias synthétiques et la provenance du contenu. Elle conseille des entreprises, des gouvernements et des syndicats sur la conformité, la licence et les risques liés à l’IA générative, et a travaillé avec Microsoft (MSFT ) et ElevenLabs sur la politique et la stratégie de l’IA. Elle a également conseillé l’UNESCO sur l’IA et la propriété intellectuelle, et apporte régulièrement des preuves d’expertise aux décideurs politiques du Royaume-Uni.
OpenOrigins développe des technologies pour lutter contre la désinformation et les deepfakes en créant des enregistrements vérifiables et inviolables de contenu numérique. Sa plateforme se concentre sur l’établissement d’une provenance claire, permettant aux médias, aux créateurs et aux plateformes de prouver quand et comment le contenu a été créé, édité et distribué – une capacité de plus en plus critique à mesure que les médias synthétiques deviennent plus avancés et plus difficiles à détecter.
Vous avez conseillé des gouvernements, des institutions mondiales comme l’UNESCO, et des entreprises comme Microsoft et ElevenLabs sur la régulation de l’IA. Qu’est-ce qui vous a amenée à vous concentrer spécifiquement sur les deepfakes, les répliques numériques et les médias synthétiques, et comment ce parcours a-t-il influencé votre décision de fonder Replique ?
Mon travail sur les deepfakes n’a pas commencé avec la technologie – il a commencé avec un vieux puzzle juridique. Lorsque j’ai commencé à rechercher la propriété intellectuelle pour mon doctorat en 2013, j’ai été frappée par le fait que les interprètes reçoivent beaucoup moins de protection que les auteurs, les compositeurs ou les cinéastes. Dans la pratique, cela signifie que vos mots ou votre musique sont mieux protégés par la loi que votre voix, votre visage et votre corps. Ce déséquilibre m’a semblé étrange, et m’a poussée à poser une question plus profonde : comment valorisons-nous culturellement et juridiquement le travail de quelqu’un dont la contribution est son visage, sa voix et son corps à l’écran ?
Cette question m’a menée à étudier les droits des interprètes et les données. À l’époque, il s’agissait d’un domaine de niche avec peu de pertinence commerciale. On m’a activement conseillé de passer à des domaines plus “lucratifs” comme les brevets ou le droit d’auteur classique. L’hypothèse était que les questions relatives à la ressemblance ou à la voix d’une personne étaient largement gérées de manière informelle – par des normes de l’industrie ou des “accords de gentlemen” à Hollywood. Mais pour moi, ce manque de protection formelle a signalé une faille, et non une impasse pour ma recherche, donc j’ai continué.
Ce qui a changé, c’est que aujourd’hui, presque tout le monde est un interprète. Nos vies sont médiatisées par des caméras – sur les téléphones, les ordinateurs portables, les appels vidéo et les plateformes sociales. Que ce soit pour le travail ou pour un usage personnel, les gens enregistrent et partagent constamment des versions d’eux-mêmes. Les questions juridiques qui s’appliquaient autrefois principalement aux acteurs ou aux musiciens s’appliquent maintenant à quiconque possède un smartphone.
Les deepfakes n’ont pas créé ces problèmes – ils les ont exposés et accélérés. Les recherches que j’ai menées à partir de 2013 sont devenues urgentes. Vers 2017 et 2018, les développements dans les réseaux neuronaux – en particulier ceux issus d’endroits comme le MIT et l’UC Berkeley – ont commencé à démontrer à quel point il était possible de manipuler numériquement de manière convaincante le visage, la voix et le corps d’une personne. Dans l’année qui a suivi, cette capacité est devenue largement connue sous le nom de “deepfakes”, et a d’abord gagné en traction de manière particulièrement préjudiciable, notamment à travers des contenus sexuels non consentis ciblant les femmes et les enfants.
Ce n’est que plus tard que les implications commerciales sont apparues, à mesure que les industries créatives ont commencé à adopter les médias synthétiques. C’est alors que les questions contractuelles et économiques que j’avais étudiées sont devenues centrales. Presque du jour au lendemain, ce qui avait été considéré comme un domaine largement théorique ou doctrinal du droit est devenu un domaine hautement pratique, commercialement significatif et socialement urgent.
Au cœur du défi juridique, rien n’a changé : les gens veulent partager des aspects d’eux-mêmes, mais conserver également un contrôle significatif. Les cadres existants luttent avec cette nuance. Ils ont tendance à traiter les individus comme étant entièrement privés ou entièrement publics – soit protégés, soit à portée de main. Mais la plupart des gens existent quelque part entre les deux. Cette tension est maintenant centrale, pas seulement pour les interprètes professionnels, mais pour quiconque participe à la vie numérique.
Je suis devenue connue comme quelqu’un qui a étudié et travaillé dans ce domaine, ce qui m’a amenée à travailler avec des gouvernements intéressés à protéger les gens contre les deepfakes, et des entreprises qui veulent rendre les produits de clonage numérique sûrs à utiliser, comme ElevenLabs. Chez Replique, j’apporte tout ce que j’ai appris aux personnes et aux entreprises qui veulent utiliser la technologie de clonage numérique ou de réplique numérique de manière responsable et sûre. J’ai essentiellement transformé mes recherches “blue sky” en une entreprise de conseil qui apporte des conseils juridiques spécialisés aux industries créatives.
En tant que Responsable Juridique d’OpenOrigins, une entreprise qui se concentre sur l’établissement d’un enregistrement immuable de la provenance du contenu pour lutter contre les deepfakes, comment voyez-vous les systèmes basés sur la provenance en concurrence ou en remplacement des approches traditionnelles de détection des deepfakes ?
La comparaison des outils de détection des deepfakes peut rapidement devenir un exercice de comparaison des pommes et des oranges, car leur efficacité dépend du contexte et de l’objectif. D’un point de vue politique, ce dont nous avons besoin, c’est une gamme d’outils complémentaires – il n’y a pas de solution unique “meilleure”, et Open Origins est une partie de cet écosystème plus large. Là où la technologie d’OpenOrigins se distingue comme une solution de détection des deepfakes, c’est dans les situations où un créateur de contenu ou une organisation d’information a besoin de prouver l’authenticité du contenu qu’il partage avec des partenaires, un public ou le grand public.
En fournissant une provenance vérifiable et des “reçus” au moment de la création, elle offre une forme solide de prévention en démontrant que le contenu n’est pas un deepfake. Cependant, cette approche est moins utile pour les utilisateurs quotidiens d’Internet qui veulent évaluer rapidement le contenu qu’ils rencontrent en ligne. Dans ces cas, la détection repose davantage sur des méthodes probabilistes et d’analyse de contenu plutôt que sur la vérification basée sur la provenance. Nous avons besoin d’outils différents pour différents besoins, et nous devons accepter qu’il n’y a pas de solution miracle contre les deepfakes.
Du point de vue juridique, quel est actuellement le plus grand vide dans la façon dont les juridictions gèrent le consentement et la propriété dans le contenu généré ou répliqué par l’IA ?
Oof, combien de temps avez-vous ? Les réponses dépendent de ce que nous entendons par contenu généré ou répliqué par l’IA. Les problèmes varient selon que l’on regarde une image générée par l’IA d’une maison ou d’un chat. Ou la récréation numérique du visage ou de la voix d’une personne. Restons sur le sujet des deepfakes et des répliques numériques, et répondons à votre question dans le contexte du “clonage numérique”.
En ce qui concerne le consentement, le problème principal est que la plupart des contrats – qu’il s’agisse d’accords d’emploi ou de conditions de plateforme – contiennent des clauses larges et vagues qui accordent des droits étendus sur le contenu de l’utilisateur. Ces clauses peuvent être interprétées comme une forme de “consentement par la porte de derrière” où l’accord aux conditions peut être considéré comme un consentement à des utilisations telles que le clonage, même si la plupart des gens contesteraient fortement cette interprétation. Cela crée un écart important entre l’interprétation juridique et l’attente de l’utilisateur, qui profite actuellement aux entreprises tandis que la réglementation est en retard.
En ce qui concerne la propriété, il n’y a pas de réponse juridique claire pour savoir qui possède une réplique numérique, car les cadres existants tels que la protection des données, le droit d’auteur et les droits de la personnalité n’ont pas été conçus pour cette technologie. Aujourd’hui, la plupart des gens sont numérisés et clonés au travail, à la demande et avec le financement d’un employeur ou d’un client. Et ces entités s’attendent généralement à avoir un contrôle important sur cet actif, ce qui est compréhensible mais souvent problématique car cet actif est une imitation numérique de votre visage ou de votre voix, et peut vous faire dire des choses que vous n’avez jamais dites, ou faire des choses que vous n’avez jamais faites.
La question de “qui possède votre clone ?” est très importante, mais reste sans réponse en droit aujourd’hui.
Vous avez travaillé étroitement sur les technologies de clonage vocal. Quels sont les risques juridiques les plus mal compris lorsqu’il s’agit de voix synthétiques, à la fois pour les entreprises et les individus ?
Le problème le plus mal compris en matière de conformité juridique est l’équilibre entre l’intérêt commercial d’une entreprise à financer et à exploiter un clone numérique, et le droit de l’individu à la vie privée et à la dignité numérique. Cette tension s’étend sur plusieurs régimes juridiques (principalement la propriété intellectuelle, la protection des données et la vie privée) qui n’ont jamais été conçus pour fonctionner ensemble et interprètent le clonage de manière fondamentalement différente. En conséquence, traduire cela en pratiques commerciales viables est complexe et souvent flou. Les entreprises ignorent donc soit les risques clés, soit engagent des coûts importants pour les naviguer correctement. Cela crée un résultat pervers où la conformité responsable devient le chemin le plus difficile et le plus coûteux, plutôt que la voie par défaut.
Comment les entreprises devraient-elles réfléchir à l’architecture du consentement dans les systèmes d’IA, en particulier lorsqu’elles traitent de ressemblance, d’identité et de données de formation ?
Les entreprises devraient concevoir leurs systèmes autour de trois capacités de base. Premièrement, elles doivent obtenir un consentement éclairé et contextuel lors de l’intégration. Deuxièmement, elles doivent faciliter la révocation de ce consentement et la suppression de certaines ou de toutes les données de l’utilisateur, ce qui est techniquement difficile et souvent négligé, mais essentiel pour se conformer aux lois comme le RGPD de l’UE et les régimes similaires aux États-Unis. Maintenir le consentement au fil du temps signifie construire des systèmes où la révocation est opérationnellement fluide et alignée sur le modèle économique.
Le consentement doit être granulaire. Et troisièmement, les utilisateurs devraient être en mesure de gérer les autorisations au niveau des fichiers individuels, de mettre à jour leurs données de ressemblance et de comprendre comment elles sont utilisées. Cela nécessite de la transparence et du contrôle – des outils qui permettent aux utilisateurs de surveiller, de revoir et de modérer la manière dont leurs clones numériques sont déployés. Ce niveau de flexibilité est encore rare, mais c’est là que réside l’avantage concurrentiel croissant.
À votre avis, où se situe la plus grande déconnexion entre la façon dont l’IA est construite et la façon dont elle est réglementée, en fonction de votre expérience en tant que conseillère pour les startups et les gouvernements ?
La déconnexion entre la façon dont l’IA est construite et la façon dont elle est réglementée se résume à des missions fondamentalement différentes. Les gouvernements réglementent dans l’intérêt public, tandis que les entreprises d’IA (souvent soutenues par des investisseurs) sont principalement motivées par la croissance, les revenus et les bénéfices. Ces priorités ne sont pas toujours en conflit, mais elles tirent souvent dans des directions différentes, la réglementation étant considérée comme une contrainte plutôt que comme un soutien.
Cela crée une tension structurelle : les régulateurs et les innovateurs opèrent avec des incitations, des valeurs et même des langages différents. Cela rend l’alignement difficile dans la pratique, même s’il n’est pas impossible. Nous commençons à voir une nouvelle vague d’entreprises technologiques s’aligner plus étroitement sur les objectifs d’intérêt public, mais elles restent l’exception plutôt que la règle – en particulier parmi celles qui réussissent à grandir.
OpenOrigins se concentre sur la vérification du contenu au moment de sa création en utilisant la provenance cryptographique. Quelle est l’importance de cette approche “origine-première” par rapport aux garanties de sécurité post-distribution ?
Cela fait écho à ma réponse ci-dessus. L’authentification du contenu à la création, “en amont”, est beaucoup plus efficace que d’essayer de le vérifier au moment de la distribution ou même de la consommation, c’est-à-dire “en aval”. L’authentification du contenu à la création est comme retracer la nourriture depuis le moment où elle est cultivée sur la ferme, plutôt que d’essayer de le déterminer à partir de ce qui est sur votre assiette. Si vous savez où le poulet a été élevé, comment il a été manipulé et comment il a traversé la chaîne d’approvisionnement, vous pouvez faire confiance à ce que vous mangez. Si vous essayez plutôt de déduire tout cela en regardant simplement le plat fini, vous vous fiez à des suppositions. C’est la même chose pour discerner entre le contenu créé par l’homme et le contenu généré par l’IA en ligne : la provenance à la source vous donne une assurance vérifiable, tandis que la détection en aval est inhérentement plus incertaine et réactive.
Quel rôle voyez-vous pour les normes comme C2PA dans l’avenir des médias, et sont-elles suffisantes par elles-mêmes pour rétablir la confiance en ligne ?
C2PA est une initiative bienvenue, et de nombreuses manières, elle soutient le même mouvement pour l’authenticité du contenu que OpenOrigins. Ils sont une partie importante de l’écosystème de sécurité et d’authenticité du contenu. Comme pour tout outil de cybersécurité, il n’y a pas de solution miracle.
Pour les créateurs et les talents dans des industries comme le cinéma, la musique et le jeu, quels sont les pas pratiques qu’ils devraient prendre aujourd’hui pour se protéger contre la réplication numérique non autorisée ?
Les artistes sont aujourd’hui confrontés à deux risques distincts : la reproduction de leur travail (comme de la musique, des images ou des écrits) et la reproduction de leur ressemblance, y compris leur visage, leur voix et leur corps. Avec un minimum d’entrée, les systèmes d’IA peuvent maintenant reproduire les deux avec un degré élevé de fidélité. Dans les termes pratiques, la protection commence par être délibérément attentif à ce que vous partagez en ligne, en reconnaissant que tout contenu publié peut être scrapé et utilisé dans des ensembles de données de formation, souvent sans consentement clair ou visibilité.
Ce risque est maintenant une réalité de base du fonctionnement en ligne. Mais le risque plus immédiat et plus contrôlable se trouve souvent dans les contrats. Les accords que les artistes concluent avec leurs collaborateurs, distributeurs ou plateformes peuvent inclure des clauses qui permettent l’utilisation, la réutilisation ou la revente de contenu à des fins de formation – souvent sans participation significative aux revenus en aval.
Pour les artistes, cela rend l’examen attentif des contrats critique. Comprendre comment votre travail et votre ressemblance peuvent être utilisés, licenciés ou réutilisés est maintenant aussi important que le processus créatif lui-même. Beaucoup du débat actuel (à travers les syndicats, les organismes de l’industrie et les plateformes) se concentre sur la correction de ce déséquilibre et la garantie que les créateurs conservent à la fois le contrôle et une rémunération équitable.
Donc deux conseils clés : soyez prudent avec ce que vous partagez en ligne, et lisez vos contrats et cherchez les clauses relatives à l’IA avant de les signer.
En regardant trois à cinq ans dans le futur, croyez-vous que nous atteindrons un point où chaque pièce de contenu numérique devra avoir une provenance vérifiable, ou la confiance restera-t-elle fragmentée à travers les plateformes et les juridictions ?
J’aimerais dire oui, mais réaliste, non – pas dans cinq ans. Dans la technologie, cinq ans semble long ; en termes de changement de comportement et d’habitudes des utilisateurs, c’est très court. La plupart des consommateurs sont peu susceptibles de baser leurs décisions sur le fait que le contenu est accompagné d’une provenance authentifiée. Les plateformes suivent généralement la demande des utilisateurs, en optimisant pour l’engagement plutôt que pour la provenance.
Cela pourrait changer si la réglementation intervient. Nous voyons déjà les premiers mouvements en Californie, où les exigences d’étiquetage et de modération émergent, mais la mise à l’échelle de cela au niveau mondial prendra du temps – probablement plus proche d’une décennie que de cinq ans.
Un autre domaine de changement est spécifique au secteur : les industries comme le journalisme, la finance, l’assurance et les soins de santé peuvent commencer à exiger la provenance et l’authentification parce que la confiance est fondamentale pour leurs opérations.
Enfin, les consommateurs ne se soucient peut-être pas de l’information de provenance à court terme, mais ils se soucieront probablement de la qualité du contenu et de la qualité de l’information. Si le contenu généré par l’IA devient trop homogène ou “terne”, les audiences peuvent commencer à valoriser davantage le contenu créé par l’homme. Cela pourrait conduire à une segmentation du marché, avec certaines plateformes donnant la priorité à la taille et au contenu généré par l’IA, et d’autres curant l’authenticité, la provenance et le matériel dirigé par l’homme de haute confiance – mais ce déplacement reste inconnu.
Merci pour vos excellentes réponses, les lecteurs qui souhaitent en savoir plus peuvent visiter OpenOrigins.


