Angle d’Anderson
Exprimer l’émotion à travers la typographie avec l’IA

 Ajouter Unite.AI à vos sources préférées sur Google
Points clésLa typographie modulée par la parole associe la hauteur, la durée et l'intensité à un…
Voir plus
- La typographie modulée par la parole associe la hauteur, la durée et l'intensité à un décalage de la ligne de base, au crénage et à la graisse de la police.
- Les sous-titres dynamiques ont obtenu de moins bons résultats que les sous-titres statiques, car la lecture animée ajoute une charge cognitive pour les spectateurs.
- Un texte tenant compte de la prosodie pourrait enrichir les jeux de données et les tâches d'informatique affective, comme l'inférence de la satisfaction client ou de la dépression.
Les tendances et innovations actuelles en matière de communications textuelles (y compris les emails, les messageries et les systèmes de sous-titres) doivent négocier le fossé affectif entre le langage écrit et parlé de manière grossière et approximative.
Par exemple, ces dernières années, l’alternance de majuscules et de minuscules sont devenues à la mode en tant que mème provocateur dans les querelles virulentes des médias sociaux, tandis que l’utilisation très décriée du verrouillage des majuscules (ainsi que des effets typographiques gras et criards autorisés par certaines plateformes de commentaires) continue de provoquer l’intervention des modérateurs. Ce sont des méthodes monotones et ne représentent que de manière large l’intention du mot écrit.
En même temps, la popularité croissante des émoticônes et des émojis, en tant que vecteur hybride de sentiment, textuel et visuel, a activement mobilisé le secteur de la recherche en traitement automatique des langues (TAL) ces dernières années, ainsi que l’intérêt pour le sens des GIF animés que les utilisateurs publient dans les fils de commentaires.
Au fil du temps, le langage écrit a développé un répertoire innovant de ces méthodes linguistiques « additives », qui tentent soit de représenter l’émotion, soit de l’évoquer en l’absence d’informations tonales dans le mot parlé.
En général, cependant, nous devons rendre l’émotion aussi bien que possible à partir du contexte du mot écrit. Considérez, par exemple, l’exclamation ‘Oh, Oh, Oh!’, à la fin du soliloque nocturne délirant de Lady Macbeth, ce qui constitue sans doute une étude de cas de l’étendue à laquelle l’intonation peut affecter le sens.
Dans la plupart des adaptations, cette lamentation douloureuse dure 2-6 secondes; dans la production de 1976 de la Royal Shakespeare Company de Macbeth, Judi Dench a pris la durée de cette réplique à un record peut-être inégalé de 24,45 secondes, dans une interprétation emblématique du rôle.
(Le système de sous-titres automatique de YouTube pour cette vidéo décrit l’ululation de Dench comme [MUSIQUE])
Traduire la prosodie en typographie
Un article récent du Brésil propose un système de typographie modulée par la parole qui pourrait potentiellement incorporer une telle prosodie, et d’autres composants paralinguistiques, directement dans les sous-titres de la parole, ajoutant une dimension d’émotion qui est mal capturée par la préfixation d’adjectifs tels que [En criant], ou les autres « procédés sans relief » disponibles aux conventions de sous-titres.
‘Nous proposons un modèle novateur de typographie modulée par la parole, où les caractéristiques acoustiques de la parole sont utilisées pour moduler l’apparence visuelle du texte. Cela pourrait permettre à la transcription d’une énonciation de ne pas seulement représenter les mots prononcés, mais également la façon dont ils ont été prononcés.
‘Avec cela, nous espérons découvrir des paramètres typographiques qui peuvent être généralement reconnus comme des proxys visuels pour les caractéristiques prosodiques de l’amplitude, de la hauteur de la voix et de la durée.’

Le flux de travail qui translittère la prosodie en stylisation typographique. En visant à produire le système le plus polyvalent et le plus largement déployable possible, les auteurs se sont limités au décalage de la ligne de base, au crénage et à la graisse, cette dernière étant fournie par la polyvalence d’une police OpenType. Source: https://arxiv.org/pdf/2202.10631.pdf
L’article est intitulé Hidden bawls, whispers, and yelps: can text be made to sound more than just its words?, et provient de Calua de Lacerda Pataca et Paula Dornhofer Paro Costa, deux chercheurs à l’Universidade Estadual de Campinas au Brésil.
Mots gras
Bien que l’objectif plus large du projet soit de développer des systèmes qui puissent transmettre la prosodie et d’autres caractéristiques linguistiques paramétriques dans les sous-titres, les auteurs estiment également qu’un système de ce type pourrait éventuellement développer un public plus large dans le monde des personnes entendantes.
Il existe de nombreuses initiatives antérieures dans cet espace, notamment un projet de 1983 qui a proposé un système de sous-titres qui pourrait inclure ‘des effets spéciaux, de la couleur et des lettres majuscules [pour représenter] les riches informations tonales refusées aux enfants sourds[.]’.
En revanche, le projet brésilien peut tirer parti à la fois de la transcription automatisée et des nouveaux développements dans la reconnaissance des affects, qui se combinent pour permettre un flux de travail qui peut importer et caractériser les composants d’une bande sonore de parole.
Une fois les caractéristiques prosodiques extraites et traitées, elles sont mappées aux horodatages des mots de la parole, produisant des jetons qui peuvent ensuite être utilisés pour appliquer une modulation basée sur les règles de la typographie des sous-titres (voir image ci-dessus).
Ce résultat peut représenter visuellement l’étendue à laquelle une syllabe particulière pourrait être prolongée, murmurée, soulignée ou autrement détenir des informations contextuelles qui seraient perdues dans une transcription brute.

De la phase de test du projet, notez la façon dont le crénage (l’espace entre les lettres d’un mot) a été élargi pour refléter une prononciation prolongée.
Les auteurs précisent que leur travail n’est pas destiné à contribuer directement à la recherche sur la reconnaissance des émotions et la reconnaissance des affects, mais plutôt à classer les caractéristiques de la parole et à les représenter avec un ensemble simple et limité de conventions visuelles nouvelles.
À tout le moins, l’accent supplémentaire fourni par le système désambiguise les phrases où l’objet de l’action peut ne pas être clair pour les téléspectateurs qui ne peuvent pas entendre le son (soit en raison d’un handicap, soit en raison des circonstances de lecture, telles que des environnements bruyants).
Pour emprunter mon propre exemple de 2017, qui a examiné la façon dont les systèmes d’apprentissage automatique peuvent également avoir du mal à comprendre où se trouve l’objet et l’action dans une phrase, il est facile de voir dans quelle mesure l’accent peut radicalement changer le sens d’une phrase même simple:
Je n’ai pas volé cela. (Quelqu’un d’autre l’a volé)
Je n’ai pas volé cela. (Je nie l’allégation que je l’ai volé)
Je n’ai pas volé cela. (Je le possède, le vol ne s’applique pas)
Je n’ai pas volé cela. (Mais j’ai volé autre chose)
Potentiellement, un flux de travail de prosodie > typographie mécanique tel que celui suggéré par les auteurs brésiliens pourrait également être utile comme complément dans le développement de jeux de données pour la recherche sur l’informatique des affects, puisqu’il facilite le traitement de données purement textuelles qui incorporent néanmoins certaines dimensions paralinguistiques pré-inférées.
De plus, les chercheurs notent que la charge linguistique supplémentaire du texte conscient de la prosodie pourrait être utile dans une gamme de tâches basées sur le TAL, y compris l’évaluation de la satisfaction client et pour l’inférence de la dépression à partir du contenu textuel.
Typographie élastique
Le cadre développé par les chercheurs offre une variation dans le décalage de la ligne de base, où une lettre peut être plus haute ou plus basse par rapport à la « ligne de base » sur laquelle repose la phrase; le crénage, où l’espace entre les lettres d’un mot peut être contracté ou étendu; et la graisse de la police.
Ces trois styles sont liés aux caractéristiques de la parole extraites auxquelles le projet s’est limité: respectivement, la hauteur de la voix, la durée et l’amplitude.

La progression du style sur une phrase. Dans #1, nous voyons les limites de syllabes qui ont été définies dans le processus d’extraction. Dans #2, nous voyons une représentation de chacune des trois modulations (amplitude|graisse, crénage|durée et hauteur de la voix|décalage de la ligne de base), appliquées individuellement. Dans #3, nous voyons les modulations typographiques combinées dans la sortie finale, telle que présentée aux 117 participants dans un essai du système.
Puisqu’une seule police de caractères peut nécessiter une police supplémentaire et distincte pour des variations telles que le gras et l’italique, les chercheurs ont utilisé une implémentation de Google de la police de caractères OpenType Inter, qui intègre une gamme granulaire de poids dans une seule police.

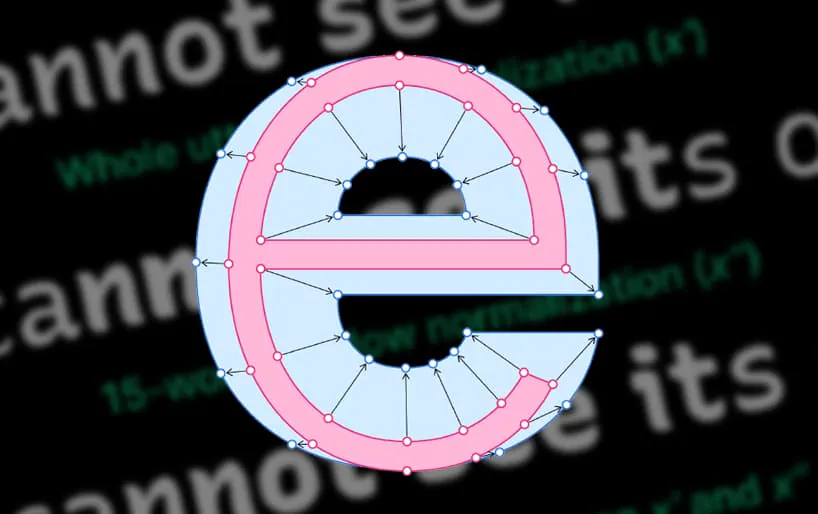
Du document, un graphique détaillant la mesure dans laquelle un glyphe OpenType à partir de la police Inter peut exprimer une gamme d’accentuations grasses le long du squelette de la spline de base minimale.
Test
L’expression du crénage et du décalage de la ligne de base a été intégrée dans un plugin de navigateur, qui a permis des tests menés sur 117 participants ayant une audition normale.
Le jeu de données pour les tests a été créé spécifiquement pour le projet, en embauchant un acteur qui a lu une sélection de poèmes plusieurs fois avec un accent différent à chaque prise, correspondant aux trois caractéristiques que le projet étudie. La poésie a été choisie car elle permet une gamme d’accentuations (même au-delà de l’intention du poète) sans paraître artificielle.
Les participants ont été divisés en deux groupes. Le premier a reçu 15 séquences de lecture d’une strophe par l’acteur accompagnée de texte animé et modulé synchronisé, qui s’est dévoilé au rythme de l’extrait audio.
Le deuxième groupe a reçu exactement le même ensemble de tâches, mais a été présenté avec des images statiques du texte modulé, qui n’ont pas changé du tout pendant la lecture de la piste audio de l’acteur.
Le taux moyen de réponses correctes était de 67 %, un résultat qui ne relevait pas du hasard, pour le groupe d’images statiques, et de 63 % pour le groupe de texte animé. Les commentaires des participants sollicités par les chercheurs après les essais ont confirmé leur théorie selon laquelle la charge cognitive de l’interprétation dynamique peut avoir contribué aux scores plus bas pour les tests non statiques. Cependant, le type de système de sous-titres et de messages que ce cadre serait destiné à fournir présente par défaut le texte une fois celui-ci terminé.
Les commentaires des participants ont également indiqué qu’il existe des limites strictes à l’utilisation du crénage pour indiquer la durée, avec un commentateur notant que lorsque les lettres sont espacées trop loin, il devient difficile d’individuer un mot.
Les chercheurs notent également:
‘[Certains] participants ont estimé que le modèle devrait être en mesure d’incarner des représentations plus nuancées et complexes de la parole, ce qu’il devrait faire avec un vocabulaire visuel plus varié et expressif. Même si ce n’est pas une tâche simple, il est encourageant de penser à la façon dont différentes applications de typographie modulée par la parole pourraient se développer à mesure que ce nouveau domaine se développe.’
Publié pour la première fois le 24 février 2022.