
Entretiens
Dr. Jaime Bland, Co-Fondateur et PDG d’Aquila Health – Série d’entretiens

 Ajouter Unite.AI à vos sources préférées sur Google
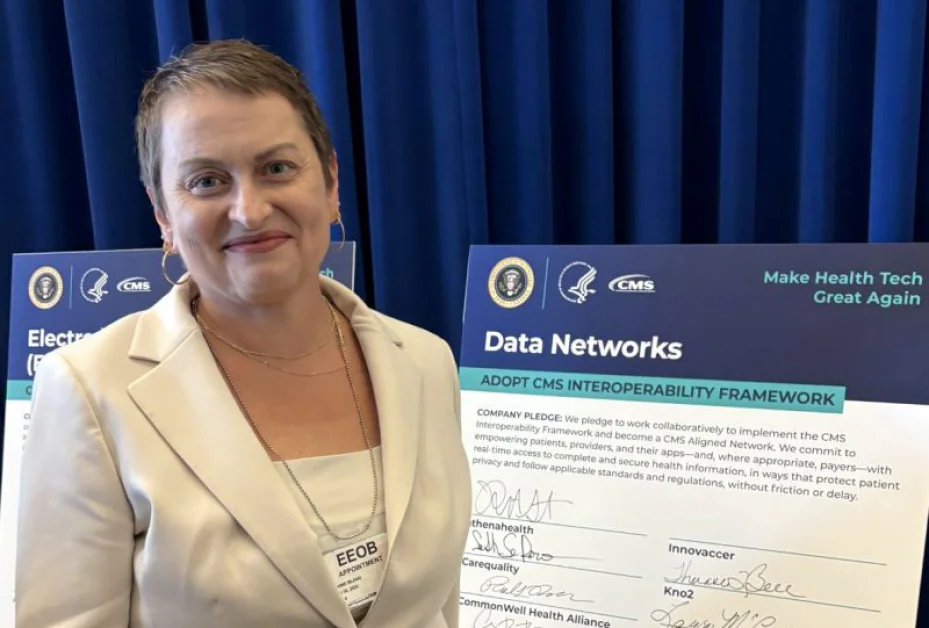
Dr. Jaime Bland, Co-Fondateur et PDG d’Aquila Health, est un leader dans le domaine des technologies de santé, axé sur la résolution de l’un des défis les plus persistants de l’industrie : les données fragmentées et inaccessibles. Elle a co-fondé Aquila Health pour créer une infrastructure de données unifiée qui permet aux organisations de santé de dépasser les systèmes cloisonnés, en exploitant l’apprentissage automatique et l’analyse structurée pour générer des insights actionnables tout en maintenant une supervision clinique. Son travail se concentre sur l’amélioration de l’interopérabilité, la mise en place d’une intelligence sanitaire au niveau de la population et le soutien à la détection précoce des menaces sanitaires émergentes grâce à des systèmes de données cliniques, de réclamations et de génomique intégrés.
Aquila Health est une plateforme de données de santé basée sur l’IA, conçue pour unifier les sources de données disparates en un seul système interopérable qui prend en charge à la fois l’efficacité opérationnelle et l’analyse avancée. La plateforme ingère des formats de données de santé à haute volumétrie tels que HL7 et FHIR, permettant une intégration transparente entre les hôpitaux, les systèmes de santé publique et d’autres parties prenantes. En combinant des approches d’apprentissage automatique structurées avec un modèle de validation humaine, Aquila se concentre sur la fourniture d’insights fiables pour la gestion de la santé de la population, la détection d’anomalies et la prise de décision en temps réel, plutôt que de s’appuyer uniquement sur des systèmes d’IA opaques. Cela positionne l’entreprise à l’intersection de l’infrastructure de données et de l’IA appliquée, où l’amélioration de la qualité et de l’accessibilité des données est fondamentale pour débloquer tout le potentiel de l’intelligence sanitaire.
Vous avez dirigé CyncHealth à travers une croissance massive, en élargissant l’interopérabilité à des millions de dossiers de patients et à plusieurs États, avant de fonder Aquila Health. Quelles étaient les principales limites ou défaillances systémiques que vous avez rencontrées au cours de ce parcours qui vous ont finalement poussé à construire Aquila à partir de zéro ?
Chez CyncHealth, nous avons passé des années à construire l’infrastructure pour connecter les organisations de santé à travers le Nebraska et l’Iowa. Nous avons connecté plus de 1 100 sites de soins et des millions de dossiers de patients, couvrant une population de plus de cinq millions de personnes.
Cependant, nous avons constamment rencontré le problème que connecter les systèmes et rendre les données utilisables sont deux problèmes très différents. Par exemple, nous avons travaillé pour créer un tableau de bord sur les overdoses d’opioïdes qui coordonnait les données que nous recevions de multiples sources. Il a fallu des mois avec des centaines d’heures de travail et une coordination avec de nombreux intervenants pour rendre cette seule donnée compréhensible dans un contexte de santé publique et de soins de santé. Et après tout cela, l’image était encore incomplète.
Cette expérience a été le point de départ pour Aquila. La façon traditionnelle de connecter les interfaces sans comprendre l’exhaustivité et la qualité des données exportées ne répondra pas aux besoins avec les progrès que nous avons vus ces dernières années dans le domaine de l’IA. Lorsque l’IA peut accomplir en quelques heures ce qui prenait des mois à une équipe, et le fait avec une meilleure qualité à un coût fractionnaire, vous devez utiliser ces connaissances pour reconstruire à partir d’une nouvelle fondation. C’est ce que nous avons fait avec Aquila ; nous nous concentrons sur des outils modernes qui réduisent le coût de la connexion afin que nous puissions nous concentrer sur la complétion de l’image globale de la santé, et non seulement sur les données dérivées des sources traditionnelles d’information sur la santé, mais sur l’image globale.
Aquila a récemment émergé de la confidentialité avec une plateforme axée sur l’unification des données de santé fragmentées en une seule couche prête pour l’IA. Quelles étaient les principales avancées techniques qui ont rendu cela possible maintenant, par opposition à il y a quelques années ?
Les capacités de l’IA ont entraîné ce changement presque entièrement.
J’ai passé des années à regarder des ingénieurs qualifiés réconcilier manuellement les normes de données, une source à la fois. Cela fonctionnait, mais ce modèle ne peut jamais être scalable. Vous ne pouvez pas embaucher suffisamment de personnel pour garder le rythme du volume et de la variété des données que génère le secteur de la santé.
Ce qui est différent maintenant, c’est que l’IA peut effectuer le travail de normalisation en continu à la couche des données à mesure que les informations circulent dans le système. Ce n’est pas un processus par lots qui s’exécute la nuit. Cela se produit en quasi-temps réel. Cela change ce qui est possible pour les cliniciens et les équipes de santé publique, car les données dont ils ont besoin sont structurées et validées (rendues utilisables) avant de leur parvenir.
Les cliniciens sont habitués à prendre des décisions sans l’image complète du patient. La santé publique est habituée à diriger des programmes sans données récentes pour les étayer. Aquila change le paysage et fournit la rapidité qui rend possible la prise de décision fondée sur les données à l’échelle de l’ensemble du secteur de la santé.
Nous avons construit TREUE™ comme le cadre qui organise les données cliniques dérivées des dossiers médicaux électroniques, des laboratoires, de la santé publique, des réclamations, de la pharmacie et des données sociales en une structure unifiée. L’IA ne remplace pas une bonne gouvernance des données ; elle la rend scalable pour la première fois.
Vous avez souligné que le véritable défi dans l’IA pour la santé n’est pas les modèles, mais les données elles-mêmes. Quels sont les écarts les plus critiques dans l’infrastructure actuelle des données de santé qui empêchent l’IA de fournir des résultats significatifs ?
L’industrie parle du modèle d’IA, mais le modèle n’est pas la partie difficile.
La partie difficile, c’est qu’un patient peut se présenter dans trois établissements différents en une seule journée et apparaître comme trois personnes différentes dans trois systèmes différents. Les laboratoires ne correspondent pas aux notes cliniques. Le dossier de l’assureur a un identifiant différent de celui de l’hôpital, et la santé publique utilise un identifiant entièrement différent. Une fois que vous avez tout cela manuellement résolu, la fenêtre clinique est close.
De solides connexions techniques ne peuvent pas résoudre les enregistrements qui arrivent incomplets ou hors séquence. L’IA ne peut pas détecter un motif qui n’est pas dans les données, et elle ne peut pas faire une recommandation fiable à partir d’un enregistrement qui manque la moitié de l’information historique ou actuelle qu’il devrait contenir.
L’écart n’est pas la puissance de traitement, c’est la confiance dans les données sous-jacentes. C’est ce qui doit être résolu en premier, et résoudre cela à grande échelle est là où l’IA peut vraiment gagner sa place.
Aquila se positionne comme la « couche de préparation des données » avant l’ingestion par l’IA. Pouvez-vous nous expliquer ce que cette couche fait dans la pratique, notamment lorsqu’il s’agit de données hétérogènes comme les dossiers médicaux, les données de réclamations et les flux en temps réel ?
En prenant l’exemple mentionné plus tôt, considérez ce qui arrive lorsque la rencontre d’un patient génère des données. Vous obtenez un message HL7 de l’hôpital, un dossier de réclamation de l’assureur, un résultat de laboratoire d’un laboratoire de référence utilisant un identifiant différent, et un rapport de santé publique déposé sur une chronologie entièrement différente. Aucun de ceux-ci n’a été conçu pour être réconcilié les uns avec les autres.
Notre couche de préparation, TREUE™, est ce qui se situe entre ces entrées et toute application d’analyse ou d’IA en aval. Son rôle est d’évaluer chaque enregistrement à son arrivée, de faire correspondre les identités entre les sources, de normaliser les formats et de signaler ce qui manque ou est incohérent avant que les données ne progressent.
Dans la pratique, cela signifie qu’un clinicien regardant un patient travaille à partir d’un dossier qui a été validé et aligné sur les sources, plutôt que de réconcilier manuellement quatre vues de système différentes pendant une prise en charge. Pour les équipes de santé publique, cela signifie que les signaux d’éclosion ne sont pas retardés par des données qui sont arrivées dans différents formats de différentes juridictions.
C’est un travail d’infrastructure. Ce n’est pas glamour, mais rien en aval ne fonctionne sans cela.
Les normes d’interopérabilité comme Fast Healthcare Interoperability Resources (FHIR) et United States Core Data for Interoperability (USCDI) existent depuis des années, pourtant la fragmentation persiste. Qu’est-ce qui manque encore d’un point de vue normatif, et comment Aquila aborde-t-elle ces lacunes différemment ?
FHIR et USCDI ont donné à l’industrie un langage partagé pour échanger des données. C’était un progrès important. Mais un langage partagé pour envoyer des données n’est pas la même chose que des données qui se comportent de manière cohérente une fois qu’elles arrivent.
Voici l’écart : les données de santé ne proviennent pas d’un seul domaine. Les systèmes cliniques, les registres de santé publique, les laboratoires et les sources de données sociales ont tous leurs propres exigences de gouvernance, leurs propres calendriers et leurs propres définitions de ce qu’un champ signifie. FHIR ne vous indique pas comment réconcilier un ensemble de données sur les déterminants sociaux avec un dossier médical d’une juridiction différente.
Ce que TREUE™ ajoute, c’est un cadre unifié pour organiser et valider les données de tous ces domaines ensemble, tout en respectant les règles de gouvernance qui s’appliquent à chaque source. Le résultat est des données que vous pouvez réellement analyser entre les domaines, et non des données qui ont simplement été transmises avec succès.
Aquila opère dans des environnements à haute conséquence où l’échec n’est pas une option. Comment concevez-vous des systèmes d’IA qui équilibrent les performances en temps réel avec des exigences strictes en matière de gouvernance, de traçabilité et de confiance ?
Vous devez intégrer la gouvernance dans l’architecture avant d’écrire la première ligne de code d’application. Elle ne doit pas être une couche que vous ajoutez par la suite.
Dans les environnements de santé et de gouvernement, les décisions informées par ces données affectent les soins aux patients, la réponse aux éclosions et la manière dont les ressources publiques sont allouées. Chaque action entreprise sur les données doit être traçable, et l’accès doit être étroitement contrôlé. Le système doit répondre aux exigences de conformité des environnements dans lesquels il opère.
Pour Aquila, cela signifie fonctionner dans une infrastructure cloud de niveau gouvernemental, des contrôles d’accès de confiance zéro et des pratiques de sécurité alignées sur les normes HIPAA et fédérales. Nous avons des contrats actifs en cours avec des gouvernements d’État, des agences fédérales et des organisations de santé, et ces environnements ont des exigences de conformité très différentes que la plateforme doit répondre simultanément.
La composante humaine est tout aussi importante. L’IA peut mettre en évidence des signaux, mais des experts cliniques valident les anomalies avant qu’elles n’informent les décisions opérationnelles. La technologie rend plus rapide la détection de ces signaux. Elle ne remplace pas le jugement des personnes qui doivent agir à leur sujet.
Votre plateforme prend en charge le déploiement sécurisé de l’IA sur appareil et la souveraineté des données. Quelle est l’importance de la décentralisation dans l’IA pour la santé, notamment compte tenu des préoccupations croissantes en matière de confidentialité des données et de conformité réglementaire ?
C’est devenu essentiel, et je pense que l’industrie commence à peine à comprendre pourquoi.
Les organisations de santé opèrent sous des obligations de confidentialité strictes. Des données de patients sensibles ne peuvent simplement être centralisées et traitées dans un environnement partagé. Différents États ont des règles différentes. Les agences fédérales ont des règles différentes. Les données de santé internationales ont un autre ensemble de contraintes. Toute architecture qui nécessite le déplacement de données sensibles vers un emplacement central va heurter ces murs à plusieurs reprises.
La direction qui fonctionne réellement consiste à générer des insights plus près de l’endroit où les données vivent déjà. Les organisations peuvent contribuer à des analyses partagées sans abandonner le contrôle de leurs données sous-jacentes. C’est ce que permettent les modèles fédérés.
Notre plateforme est conçue pour fonctionner dans ce type d’environnement réglementé et décentralisé – une gouvernance qui accompagne les données plutôt que d’être appliquée à un seul point. C’est une architecture plus difficile à construire, mais c’est celle qui est réellement compatible avec la façon dont la gouvernance des données de santé fonctionne dans la pratique.
De nombreuses startups d’IA s’appuient fortement sur des modèles de boîte noire, tandis qu’Aquila intègre une validation humaine dans la boucle. Où situez-vous la limite entre l’automatisation et la surveillance humaine dans les systèmes d’IA cliniques ?
J’ai commencé ma carrière en tant qu’infirmière. Cette expérience façonne ma façon de penser à l’endroit où l’IA appartient dans un contexte clinique, et où elle n’appartient pas.
L’IA est très bonne pour trouver des modèles dans de grands ensembles de données. Elle n’est pas bonne pour savoir ce qu’un modèle signifie pour un patient spécifique avec une histoire spécifique dans un contexte communautaire spécifique. C’est toujours un jugement humain.
Le rôle approprié de l’IA dans les systèmes cliniques est de mettre en évidence des signaux que les humains pourraient manquer en volume, et non de remplacer le raisonnement clinique qui suit. Chez Aquila, les anomalies et les insights signalés par le système sont soumis à des cliniciens et à des experts du domaine pour examen avant de conduire à des décisions opérationnelles. La technologie vous indique où regarder, et le professionnel vous indique ce que cela signifie.
Où je pense que la limite appartient : automatiser la détection, garder l’interprétation avec les personnes qui sont responsables du résultat.
Aquila travaille dans le domaine de la santé publique, des systèmes gouvernementaux et des industries réglementées. Comment les exigences pour l’infrastructure d’IA diffèrent-elles entre ces environnements par rapport aux déploiements d’IA traditionnels dans l’entreprise ?
Dans un déploiement d’IA traditionnel dans l’entreprise, vous travaillez généralement dans un seul environnement de données d’organisation, un seul ensemble de règles de gouvernance, un seul cadre de conformité.
Les environnements de santé publique et de gouvernement sont structurellement différents. Vous coordonnez entre plusieurs juridictions, plusieurs agences, plusieurs contextes cliniques, chacun opérant sur des calendriers de déclaration et des cadres juridiques différents. Un hôpital dans un État, une agence de santé publique dans un autre, un programme fédéral avec ses propres exigences de données. Tous ces éléments doivent échanger des données et générer des insights sans qu’aucune entité ne puisse accéder de manière non contrôlée aux enregistrements d’une autre.
L’infrastructure doit prendre en charge un traitement à haute volumétrie tout en maintenant une traçabilité stricte à travers toutes ces frontières. Elle doit s’intégrer avec les formats de messagerie de santé legacy, car ces systèmes ne disparaissent pas. Et elle doit fonctionner de manière fiable dans des environnements où le temps d’arrêt n’est pas seulement un problème commercial, mais un problème de sécurité des patients.
Cette complexité est la raison pour laquelle nous avons commencé Aquila avec ces environnements plutôt que le marché traditionnel de l’entreprise. Si vous pouvez construire une infrastructure qui fonctionne ici, elle fonctionnera partout.
Les capacités de l’IA continuent de progresser plus vite que les cadres de gouvernance. Quelles sont les responsabilités des fondateurs et des concepteurs de plateformes pour s’assurer que ces systèmes sont déployés de manière éthique et sécurisée dès le premier jour ?
Je pense que la responsabilité est straightforward, même si la satisfaction de cette responsabilité ne l’est pas. Si vous construisez de l’IA qui affecte les décisions cliniques ou les résultats de la santé publique, vous n’avez pas le droit de traiter la gouvernance comme un élément de la feuille de route du produit que vous aborderez éventuellement. Elle doit être conçue dès le départ.
Ce que cela signifie pratiquement, c’est que chaque action sur les données doit être traçable. Les modèles doivent être suffisamment interprétables pour qu’un clinicien comprenne pourquoi un signal a été signalé. Les experts cliniques doivent faire partie du processus d’examen, et non une après-pensée. Et l’organisation doit être honnête sur ce que le système peut et ne peut pas faire de manière fiable.
J’ai passé ma carrière dans des environnements où les défaillances des données ont des conséquences réelles pour des personnes réelles. Cela façonne ma façon de penser à cela. Les capacités sont en progression rapide, et la responsabilité de leur déploiement ne doit pas être allowed à lag behind. Les fondateurs qui construisent ces systèmes doivent tenir ce standard pour eux-mêmes, et non attendre que la réglementation l’impose.
Merci pour cette discussion éclairante. Les lecteurs intéressés à explorer la plateforme et son approche de l’infrastructure des données de santé peuvent en savoir plus en visitant Aquila Health.






