
Angle d’Anderson
Disney combine le CGI avec le rendu neuronal pour s’attaquer à la « vallée étrange »

 Ajouter Unite.AI à vos sources préférées sur Google
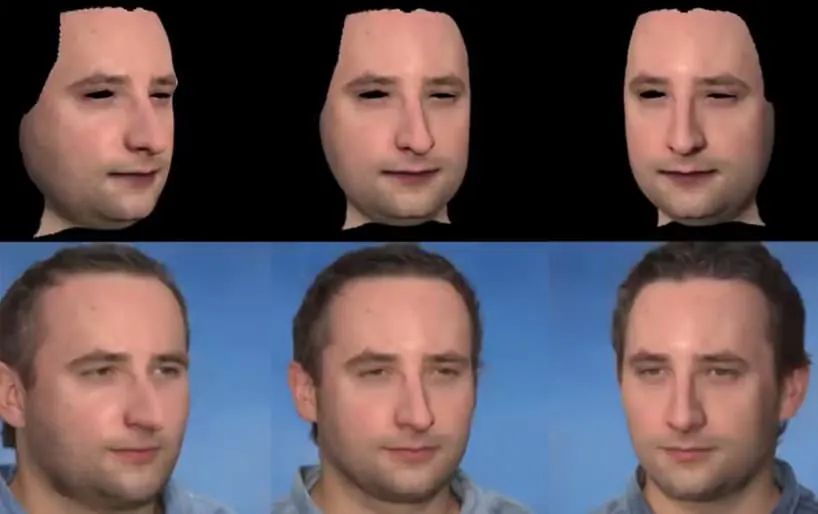
La division de recherche en IA de Disney a mis au point une méthode hybride de simulation faciale de qualité cinématographique, combinant les atouts du rendu neuronal facial avec la cohérence d’une approche basée sur le CGI.
L’article à paraître s’intitule Rendering with Style: Combining Traditional and Neural Approaches for High Quality Face Rendering, et est présenté dans une nouvelle vidéo de 10 minutes sur la chaîne YouTube Disney Research (intégrée à la fin de cet article*).
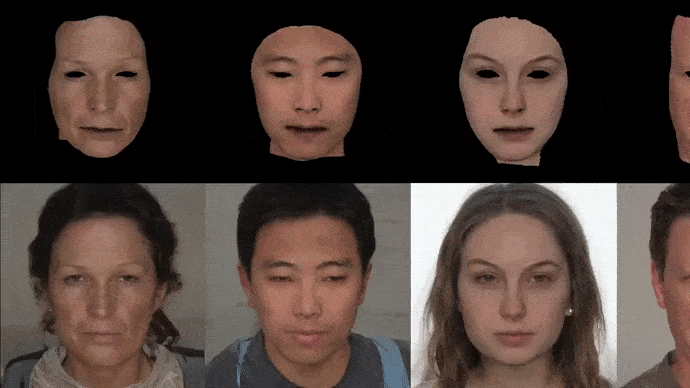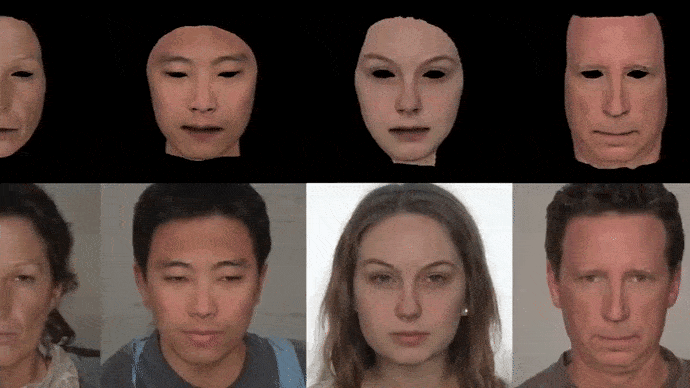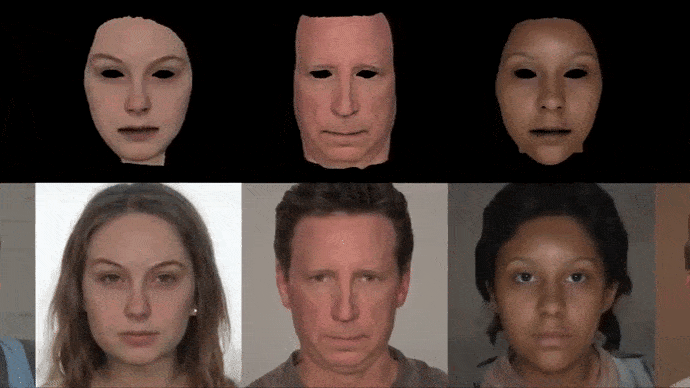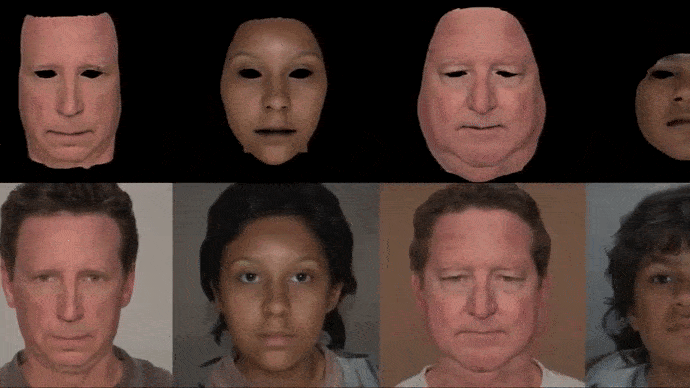
Meshes combined with neural facial renders. See video embed at end of article for better detail and quality. Source: https://www.youtube.com/watch?v=TwpLqTmvqVk
Comme le souligne la vidéo, le rendu neuronal des visages (y compris les deepfakes) peut produire des yeux et des intérieurs de bouche bien plus réalistes que le CGI ne le permet, tandis que les textures faciales générées par le CGI sont plus cohérentes et adaptées à des effets visuels de niveau cinématographique.
Ainsi, Disney expérimente en confiant au générateur neuronal StyleGan2 de NVIDIA la prise en charge des caractéristiques périphériques d’un visage et des éléments « vitaux » tels que les yeux, tout en superposant une peau faciale CGI cohérente et les éléments associés au rendu final.
From the video (see end of article), the architectural concept behind Disney’s hybrid approach, where an old-school CGI mesh, of the type used to recreate ‘young’ Carrie Fisher and the late Peter Cushing for Rogue One (2016), is integrated into neurally-rendered face environments.
La vidéo fait une référence tacite aux critiques récurrentes concernant le manque d’authenticité et l’effet « vallée étrange » de la recréation CGI du défunt acteur britannique de Star Wars, Peter Cushing, dans Rogue One (2016), en admettant :
« Il reste encore un énorme écart entre ce que les gens peuvent capturer et rendre facilement et les doubles numériques photoréalistes finaux, complets avec cheveux, yeux et intérieur de la bouche. Pour combler cet écart, il faut généralement beaucoup de travail manuel de la part d’artistes qualifiés. »
En réalité, même les systèmes de capture faciale les plus modernes n’essaient pas de recréer les yeux, l’intérieur de la bouche ou les cheveux, qui posent respectivement des problèmes d’authenticité (yeux) ou de cohérence temporelle (cheveux).

The video illustrates what VFX artists will get after a typical modern facial capture session. Eyes, hair, facial hair, and mouth interiors will all have to be handled by separate teams in the production pipeline, in addition to texturing and lighting.
Contrôle de l’éclairage
L’approche hybride constitue également un avantage pour le re‑éclairage – un défi notable du rendu neuronal des visages, car les superpositions de peau CGI peuvent être re‑éclairées plus facilement.

An animated version of the CGI/Neural approach.
Dans des environnements plus difficiles, comme les prises de vue en extérieur, les chercheurs ont développé une méthode de remplissage autour d’une sorte de zone démilitarisée entourant la personne « créée ».
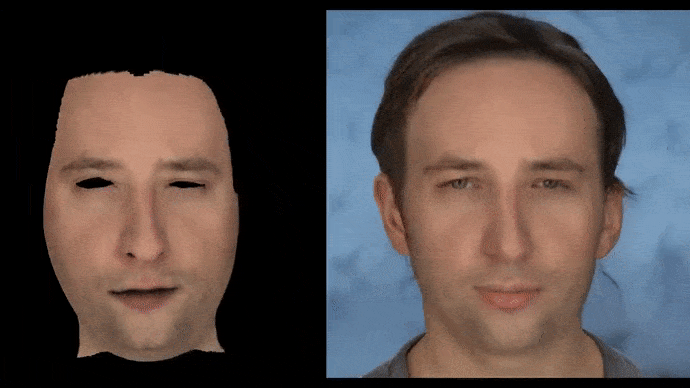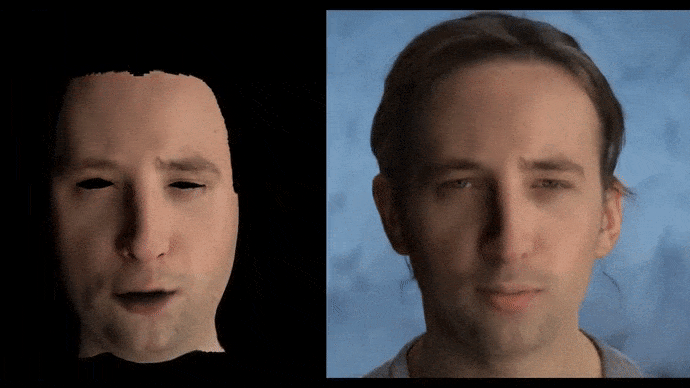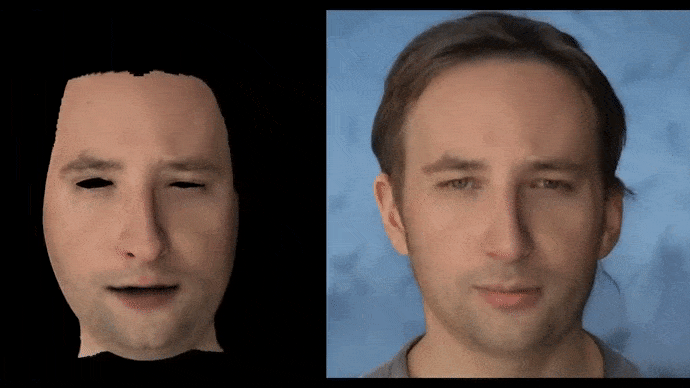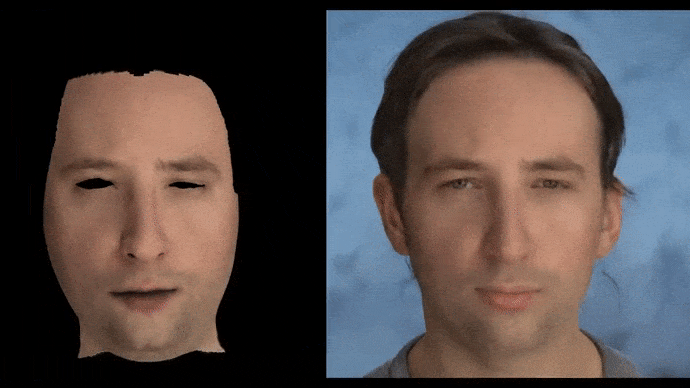
A black margin is generated to allow a ‘canvas’ for inpainting the outer parts of the identity and integrating the CGI skin into the combined CGI/neural output.
« Le rendu neuronal ne correspond pas parfaitement à la contrainte d’arrière‑plan. – il n’est destiné qu’à servir de guide, car l’optimisation des composants humains réalistes tels que les cheveux, les yeux et les dents est l’objectif principal. Il est plus difficile d’essayer de maintenir une identité cohérente tout en modifiant l’éclairage de l’environnement. »
Création de maillages CGI à partir de rendus neuronaux
L’équipe de recherche a également mis au point un auto‑encodeur variationnel entraîné sur une vaste base de données (non spécifiée) d’images faciales 3D, et affirme qu’il peut générer des maillages faciaux 3D « aléatoires mais plausibles » à partir de données de vérité terrain.
Cette recherche doit encore surmonter certaines limites, notamment la difficulté à maintenir la cohérence temporelle des cheveux dans les rendus neuronaux, et la vidéo (voir ci‑dessous) montre plusieurs exemples de cheveux qui mutent rapidement autour d’un visage CGI/neuronale autrement stable.
La cohérence temporelle dans le rendu vidéo neuronal est un problème bien plus vaste que celui de Disney, et il semble probable que les itérations futures de ce système recourront à l’ajout de cheveux « en post‑production », ou à d’autres approches possibles de génération de cheveux, plutôt que d’espérer qu’une nouvelle méthode neuronale résolve finalement ce problème.
Utilisations pour la génération de jeux de données
La méthode est également proposée comme une façon potentielle de générer des données synthétiques et d’enrichir le paysage des ensembles d’images faciales, qui sont devenus ces dernières années dangereusement monotones.

Disney envisages the new technique populating facial image datasets.
« Chaque résultat photoréaliste que nous générons possède une géométrie sous‑jacente correspondante ainsi que des cartes d’apparence, rendues depuis des points de vue de caméra inconnus avec une illumination connue. Cette information de « vérité terrain » peut être cruciale pour entraîner des applications en aval, telles que la reconstruction faciale monoculaire ou 3D, la reconnaissance faciale ou la compréhension de scène. Ainsi, chaque rendu de résultat peut être considéré comme un échantillon de données, et nous pouvons générer de nombreuses variantes de nombreux individus différents. »
« De plus, même pour une seule personne rendue avec une expression unique, un point de vue et une illumination uniques, nous pouvons générer des variations aléatoires du rendu photoréaliste en faisant varier la graine de randomisation pendant l’optimisation. »
Les chercheurs soulignent que cette diversité de sorties configurables pourrait être utile pour entraîner des applications de reconnaissance faciale, concluant :
« Notre méthode peut exploiter la technologie actuelle de capture, de modélisation et de rendu de la peau faciale, et créer automatiquement des rendus faciaux photoréalistes complets correspondant à l’identité, à l’expression et à la configuration de scène souhaitées. Cette approche a des applications dans le rendu facial pour le cinéma et le divertissement, en économisant le travail manuel des artistes, ainsi que pour la génération de données dans divers domaines du deep learning. »
Pour un examen plus approfondi de la nouvelle approche, consultez la vidéo de 10 minutes publiée aujourd’hui :
https://www.unite.ai/why-adversarial-image-attacks-are-no-joke/
* Le lien vidéo original a été remplacé par un autre apparemment identique 8 heures après la publication de cet article. J’ai modifié tous les liens pertinents, car il n’existe aucune trace de la vidéo originale.
8 h 24 GMT+2 – Vidéo remplacée, car la chaîne YouTube Disney Research l’a changée pour une raison quelconque.


