
Le meilleur
10 meilleurs outils d’extraction de données web par IA (novembre 2026)

 Ajouter Unite.AI à vos sources préférées sur Google
Unite.AI peut recevoir une compensation via les liens vers les produits évalués. Cela n’influence pas nos évaluations éditoriales. Consultez notre politique d’affiliation.
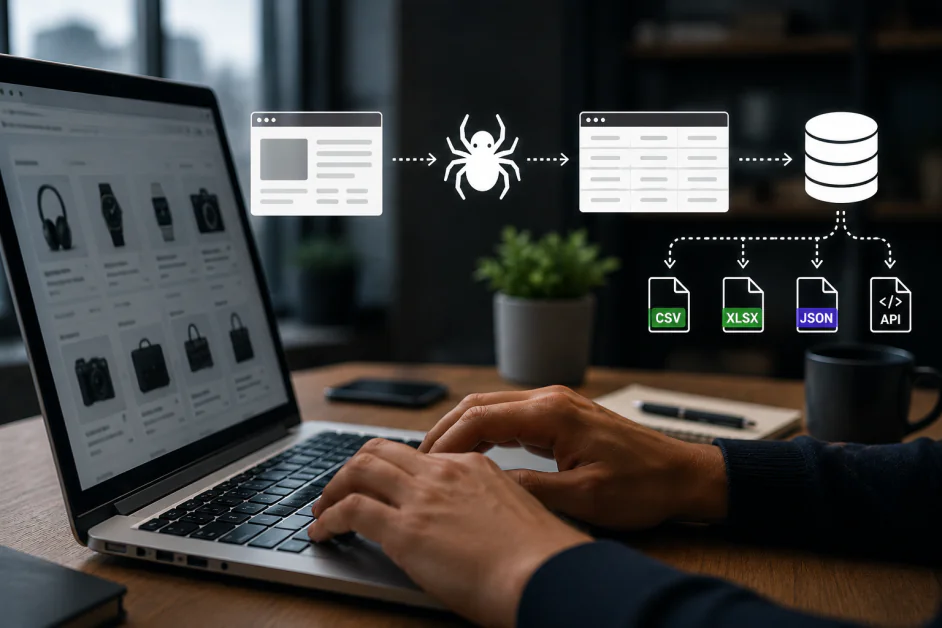
Le meilleur outil d’extraction de données web par IA dépend de ce que vous souhaitez faire une fois la page chargée. Un assistant de recherche a besoin de contenu lisible et de liens vers les sources. Un système d’analyse de marché doit pouvoir produire des données cohérentes à grande échelle. Un agent interactif peut avoir besoin d’un navigateur capable de cliquer à plusieurs reprises et de maintenir sa session active.
Ce guide présente dix outils adaptés à ces différents usages : plateformes de collecte pour les entreprises, API de contenu, outils d’extraction sans code, services de données de recherche et navigateurs gérés. Nous évaluons la façon dont chaque produit collecte les informations, les personnes en mesure de maintenir le processus et les compromis à prendre en compte lorsqu’un prototype devient un processus récurrent.
Notre équipe a évalué indépendamment chacune des solutions présentées dans ce guide, en examinant leurs fonctionnalités, leurs atouts pratiques, leurs limites et leur adéquation aux cas d’usage retenus dans notre classement.
Comparatif des meilleurs outils d’extraction de données web par IA
| Outil d’IA | Idéal pour | Principaux atouts |
|---|---|---|
| Bright Data | Collecte à l’échelle de l’entreprise et diversification des flux de données | Scraper APIs, Browser API, Scraper Studio, jeux de données, services proxy |
| Firecrawl | Contenu web pour les applications d’IA | Recherche, extraction, cartographie, exploration, Markdown, JSON, Interact, MCP |
| Apify | Tâches d’extraction réutilisables et orchestration dans le cloud | Acteurs, Crawlee, planification, stockage, services proxy, API, MCP |
| Browse AI | Collecte sans code et surveillance des changements | Configuration assistée par l’IA, robots, alertes, planification, intégrations |
| SearchAPI | Résultats de recherche structurés et recherches localisées | Google, Maps, achats, vidéo, interfaces de recherche par IA, JSON |
| Octoparse | Extraction visuelle avec exécution récurrente dans le cloud | Modèles, AI Assistant, détection automatique, exécutions dans le cloud, exportations |
| Browserless | Navigateurs gérés pour Puppeteer et Playwright | Navigateurs hébergés, sessions persistantes, API REST, MCP |
| ScrapingBee | Extraction gérée via une API destinée aux applications | Extraction par IA, CSS/XPath, Markdown, scénarios JS, MCP |
| Oxylabs | Collecte gérée sur des sites web publics difficiles d’accès | Web API /Scrape, rendu, données structurées, MCP |
| Diffbot | Extraction automatique et analyse des entités | Extraction, schémas standard, exploration, Knowledge Graph |
Comment choisir un outil d’extraction de données web par IA
Adaptez l’outil à la tâche
Pour une base de connaissances destinée à l’IA, privilégiez le texte lisible, les données structurées et la conservation des URL sources. Pour les études de marché récurrentes, un robot visuel et des alertes de changement peuvent être plus utiles qu’une interface de programmation. Pour un agent interactif, examinez la continuité des sessions et le contrôle du navigateur. Les API de résultats de recherche répondent à un autre besoin : elles fournissent des données de recherche, tandis que la collecte des pages liées constitue une étape distincte.
Déterminez qui sera responsable du processus
Une plateforme sans code permet à un analyste de modifier directement les étapes d’extraction. Une API offre aux développeurs une interface claire pour intégrer la collecte à une application. Une plateforme de tâches dans le cloud ajoute la planification et le stockage, tandis qu’un navigateur géré laisse davantage de logique d’automatisation à la charge de votre équipe. Le bon choix confie la maintenance aux personnes qui connaissent à la fois les sites web sources et le format de sortie requis.
Prévoyez le budget en fonction des données exploitables, pas des chiffres de requêtes mis en avant
Comparez le coût d’une tâche terminée aux champs dont vous avez besoin. Le rendu, les proxys premium, la durée d’utilisation du navigateur, l’extraction par IA, le stockage et les nouvelles tentatives peuvent modifier le coût total. Un crédit gratuit, une unité de navigateur et une requête de recherche sont des mesures différentes. Pour les travaux récurrents, suivez le taux de complétude, les doublons, l’actualité des données et le coût par enregistrement exploitable, en plus du nombre de réponses réussies.
Les 10 meilleurs outils d’extraction de données web par IA
1. Bright Data
Bright Data est notre recommandation générale pour les organisations qui ont besoin de plusieurs moyens de collecter des données web au sein d’une même plateforme. Son offre comprend des Scraper APIs prêtes à l’emploi, des jeux de données précollectés, Scraper Studio, Web Unlocker et des services proxy. Une équipe chargée de l’analyse des données du commerce en ligne peut, par exemple, utiliser des flux structurés pour les enseignes courantes tout en mettant en place une collecte personnalisée pour une place de marché spécialisée. Cette diversité rend la plateforme particulièrement utile lorsque le programme de collecte de données s’étend à plusieurs sites web ou services.
Pour les pages interactives, Browser API héberge des navigateurs que les développeurs peuvent contrôler avec Puppeteer, Playwright ou Selenium. Le service associe l’exécution dans le navigateur à la gestion des proxys et à la résolution des CAPTCHA, tandis que la prise en charge de Chrome DevTools aide les ingénieurs à examiner les sessions problématiques. Cette solution est utile lorsqu’un flux de travail nécessite de naviguer ou d’interagir avec une page avant que les informations recherchées ne soient accessibles, plutôt que de simplement télécharger un jeu de données existant.
Le principal compromis concerne le choix des produits et la maîtrise des coûts. Le trafic des navigateurs, les résultats du scraping et l’achat de jeux de données correspondent à des charges de travail différentes ; un seul prix affiché ne peut donc pas décrire l’ensemble de la plateforme. Bright Data convient aux équipes qui disposent d’une personne responsable de la qualité de la collecte, de la couverture des sources ciblées et des dépenses. Un projet de portée limitée peut être mis en production plus rapidement avec une API d’extraction plus simple.
Avantages et inconvénients
- De nombreuses options de collecte sur une même plateforme
- Les navigateurs hébergés prennent en charge les bibliothèques d’automatisation courantes
- Les API et jeux de données prêts à l’emploi accélèrent la mise en place
- Les différents produits nécessitent une planification distincte des coûts
- Les pipelines personnalisés nécessitent toujours un responsable technique
2. Firecrawl
Firecrawl est notre choix pour les développeurs qui transforment le contenu du Web en contexte utile pour une application d’IA. Ses outils de recherche, d’extraction, de cartographie et d’exploration couvrent toutes les étapes, de la découverte d’une page à la collecte du contenu d’un site Web. Le Markdown et le JSON structuré réduisent le travail de nettoyage nécessaire après la récupération des données. Un assistant de recherche ou une base de connaissances peut ainsi consacrer plus de temps à répondre aux questions et moins à supprimer les menus de navigation du code HTML brut.
Son offre Interact actuelle étend la plateforme aux opérations dans un navigateur en direct. Les agents peuvent décrire des actions en langage naturel ou exécuter du code dans le navigateur, conserver leur état entre les appels et réutiliser des profils authentifiés. C’est un ajout appréciable pour les pages où il faut cliquer, appliquer des filtres ou se connecter avant l’extraction. L’accès via MCP et la ligne de commande rend également Firecrawl pratique dans les flux de développement d’agents, au-delà d’une simple API d’application classique.
Firecrawl est particulièrement adapté lorsque l’acquisition de contenu constitue le besoin immédiat et que l’application dispose déjà de son propre système de stockage et de récupération. Les équipes doivent toujours définir les limites de l’exploration, conserver les URL des sources et distinguer un champ manquant d’un champ vide. Le code open source offre une autre possibilité de déploiement, mais les équipes doivent évaluer les fonctionnalités précises et les exigences opérationnelles de la solution choisie, plutôt que de supposer que les versions hébergée et autogérée sont identiques.
Avantages et inconvénients
- Le Markdown et le JSON conviennent aux pipelines d’IA
- Interact prend en charge les tâches avec état dans le navigateur
- Accès par API, MCP et interface en ligne de commande
- Le contenu récupéré doit encore être validé
- Les déploiements autogérés nécessitent un travail opérationnel
3. Apify
Apify est ici le meilleur choix pour les équipes qui recherchent des outils de scraping réutilisables et une plateforme pour les exploiter. Sa place de marché distribue des Actors : des programmes prêts à l’emploi qui acceptent des données en entrée, s’exécutent dans le cloud et renvoient des résultats. Les Actors existants peuvent accélérer les tâches de collecte courantes, tandis que les Actors personnalisés permettent aux développeurs de conserver leur propre logique d’extraction. Apify constitue ainsi un pont utile entre une expérimentation et une tâche de production reproductible.
La plateforme fournit les principaux éléments opérationnels nécessaires, notamment la planification, le stockage des résultats, l’accès aux proxys, la surveillance et les intégrations. Les développeurs peuvent également créer des outils avec Crawlee, sa bibliothèque open source d’exploration et d’automatisation de navigateur. Le serveur MCP d’Apify met les Actors à la disposition des agents d’IA : un même outil prêt à l’emploi peut ainsi servir une application, un pipeline planifié ou un assistant, sans qu’il soit nécessaire de développer une implémentation distincte du scraper pour chaque interface.
Le choix des Actors mérite autant d’attention que celui de la plateforme. Selon leur éditeur, les tarifs, la maintenance, les options de saisie et la qualité des résultats peuvent varier. La réussite d’une exécution ne garantit pas non plus que tous les enregistrements attendus ont été collectés. Apify est particulièrement intéressant lorsqu’une personne est chargée de gérer le schéma de la tâche, de surveiller les changements et de prévoir le budget nécessaire à l’Actor sélectionné et à l’utilisation de l’infrastructure ; une extraction manuelle sur une seule page nécessite rarement une orchestration aussi poussée.
Avantages et inconvénients
- Les Actors prêts à l’emploi et personnalisés sont réunis sur une même plateforme
- La planification, le stockage et la surveillance facilitent la répétition des tâches
- MCP intègre les Actors aux flux de travail des agents
- La maintenance et la qualité des Actors varient
- Les frais liés à l’utilisation et aux Actors doivent être budgétés
4. Browse AI
Browse AI est notre recommandation pour les professionnels qui ont besoin de données web récurrentes sans avoir à développer un projet logiciel. Sa configuration actuelle peut lire une page fournie, proposer une structure de données et laisser l’utilisateur examiner ou modifier les champs. L’entraînement du robot reste essentiel pour assurer la répétabilité de l’extraction. C’est une approche pratique pour les équipes chargées des opérations et du marketing qui recueillent des fiches produit, des entrées d’annuaire ou des informations sur la concurrence dans des tableaux familiers.
La surveillance est un atout majeur. Les robots peuvent vérifier des pages selon un calendrier défini, repérer les ajouts ou les modifications et envoyer des alertes qui expliquent les changements détectés. Les flux de travail peuvent relier la collecte sur plusieurs pages, tandis que les intégrations avec les API, les webhooks et les feuilles de calcul permettent d’envoyer les résultats vers les outils déjà utilisés par une équipe. Un processus de suivi des prix peut ainsi devenir une activité récurrente de l’entreprise, plutôt qu’une succession de vérifications manuelles dans le navigateur.
Cette facilité d’utilisation ne dispense pas de définir clairement les données recherchées. Les utilisateurs doivent déterminer quels changements justifient une alerte et vérifier que la pagination, les étapes de connexion et les résultats vides fonctionnent correctement. Les refontes importantes peuvent encore nécessiter une intervention. Browse AI convient particulièrement aux équipes métier capables d’examiner les lignes extraites et d’assurer la maintenance du robot ; les développeurs qui ont besoin d’une logique de navigation versionnée avec précision préféreront peut-être un service reposant sur du code.
Avantages et inconvénients
- La configuration des champs assistée par l’IA facilite la prise en main
- La surveillance planifiée met en évidence les changements importants
- Connexions aux feuilles de calcul, aux API et aux webhooks
- Les changements majeurs apportés à un site peuvent nécessiter un nouvel entraînement
- Une logique complexe exige une conception soignée du flux de travail
5. SearchAPI
SearchAPI est notre recommandation spécialisée pour recueillir des résultats de recherche sous forme de données structurées. Son API Google peut renvoyer les liens des résultats et les fonctionnalités de recherche au format JSON, évitant ainsi d’avoir à maintenir un analyseur pour une page de résultats qui évolue. Son catalogue plus vaste couvre des sources comme Maps, les achats, l’actualité, la vidéo et les expériences de recherche par IA prises en charge. Cet outil est particulièrement utile lorsque la découverte et la visibilité dans les résultats de recherche constituent le produit de données recherché, plutôt qu’une étape préalable à l’exploration d’un autre site web.
La localisation est un aspect important de cette adéquation. Les paramètres de lieu, de pays, de langue et d’appareil permettent aux équipes d’étudier un marché à partir d’un contexte de recherche défini. Une application de référencement naturel peut suivre une requête dans une ville donnée, tandis qu’un assistant de recherche peut repérer des sources pertinentes et conserver les liens renvoyés pour les retrouver ultérieurement. Il est important de consulter la documentation propre à chaque moteur, car les paramètres disponibles et les champs de résultats varient d’un produit de recherche à l’autre.
SearchAPI doit être choisi en fonction des moteurs et des champs réellement nécessaires au flux de travail. Un résultat de recherche ne contient pas l’intégralité de la page vers laquelle il renvoie, et les différentes présentations enrichies des résultats ne suivent pas toutes le même schéma. Les équipes doivent prévoir le volume de requêtes, vérifier leurs besoins en matière de débit et gérer convenablement les sections de résultats manquantes. Pour extraire des données de sites web quelconques ou utiliser une session de navigation interactive, un autre outil de ce guide constitue un meilleur point de départ.
Avantages et inconvénients
- Les résultats structurés évitent d’avoir à maintenir un analyseur de pages de résultats de recherche
- Un vaste catalogue de moteurs de recherche et de moteurs associés
- Des paramètres de localisation détaillés
- Les résultats de recherche ne remplacent pas l’extraction des données des pages de destination
- Les champs et les paramètres varient selon le moteur
6. Octoparse
Octoparse présente son copilote IA et son automatisation avec intervention humaine. Vidéo : Octoparse.
Octoparse convient bien aux analystes qui souhaitent concevoir un extracteur visuellement, puis l’exécuter à plusieurs reprises. Sa plateforme actuelle propose des modèles prêts à l’emploi, une configuration avec l’assistant IA et la détection automatique des pages dans l’application de bureau. Les utilisateurs peuvent affiner la tâche obtenue au lieu de partir de code de navigation. Cette flexibilité est utile pour recueillir des catalogues de produits, des annuaires ou des listes, lorsque l’enchaînement des pages compte autant que les champs de chacune.
L’exécution dans le cloud transforme une tâche préparée en processus de collecte récurrent, sans qu’il soit nécessaire de laisser un ordinateur personnel allumé. La planification, le traitement en parallèle, la rotation des adresses IP et les connexions d’exportation permettent de faire évoluer les tâches importantes au-delà du prototype sur ordinateur. Cette approche visuelle séduit particulièrement les équipes qui connaissent leurs sites sources et leurs besoins en données, mais ne souhaitent pas maintenir un service personnalisé d’automatisation du navigateur.
Octoparse donne néanmoins de meilleurs résultats lorsque la tâche est conçue avec soin. La pagination, le défilement infini, les étapes de formulaire et les doublons peuvent modifier le sens d’une exécution qui semble pourtant réussie. Les quotas d’utilisation du cloud et les fonctionnalités des forfaits doivent correspondre à la fréquence et au volume prévus. Nous le recommandons aux équipes qui souhaitent mieux contrôler les étapes d’extraction qu’avec un outil rapide à utiliser en un clic, à condition qu’une personne désignée puisse ajuster la tâche lorsque les pages sources changent.
Avantages et inconvénients
- Les modèles et l’assistance par IA simplifient la configuration
- La modification visuelle permet de créer des tâches d’extraction détaillées
- L’exécution dans le cloud permet de planifier les collectes
- Les sites complexes nécessitent d’affiner les tâches
- Les fonctionnalités cloud dépendent de l’offre choisie
7. Browserless
Browserless est notre recommandation pour les développeurs qui souhaitent contrôler un navigateur tout en confiant son hébergement et sa mise à l’échelle à un service géré. Les scripts Puppeteer ou Playwright existants peuvent se connecter à des navigateurs distants, ce qui en fait une solution intéressante pour les projets disposant déjà d’un code d’automatisation opérationnel. Elle est particulièrement utile lorsque la collecte nécessite plusieurs interactions, une interface reposant largement sur JavaScript ou une session qui doit rester active au-delà d’une simple requête.
Le service propose également des API REST pour le scraping, les captures d’écran, les fichiers PDF et les fonctions de navigateur personnalisées. Son serveur MCP hébergé met des outils de navigation à la disposition des agents d’IA, tandis que les fonctionnalités de session et les profils authentifiés répondent aux besoins des processus qui nécessitent une continuité. Browserless convient donc aussi bien à un développeur qui crée un collecteur de données personnalisé qu’à un agent qui doit naviguer et recueillir des informations dans un navigateur réel.
Le principal critère à prendre en compte est le mode de facturation de l’utilisation du navigateur. L’offre gratuite comprend actuellement 1 000 unités par mois et deux navigateurs simultanés, et non 1 000 opérations de scraping garanties. Le temps d’utilisation du navigateur consomme des unités, auxquelles s’ajoutent des frais pour le trafic via proxy et la résolution réussie de CAPTCHA ; les limites de session varient selon l’offre. Les équipes restent responsables de la logique d’extraction et de la vérification des résultats. Browserless est donc particulièrement intéressant lorsque le contrôle du navigateur compte davantage qu’un outil visuel de création de robots.
Avantages et inconvénients
- Préserve les processus habituels avec Puppeteer et Playwright
- Les API REST couvrent le scraping et l’exportation de pages
- Les fonctionnalités de session et le MCP conviennent aux agents interactifs
- Le temps d’utilisation du navigateur et les options supplémentaires influent sur la consommation d’unités
- L’extraction personnalisée nécessite toujours une logique applicative
8. ScrapingBee
ScrapingBee est une excellente option pour les développeurs qui souhaitent envoyer une requête d’extraction prise en charge par un service géré plutôt que de contrôler directement un navigateur utilisé sur une longue durée. Son API associe la récupération des pages et leur rendu JavaScript à la gestion des proxys, tandis que l’extraction peut s’appuyer sur des règles CSS ou XPath, ou sur des instructions en langage naturel destinées à l’IA. Cette combinaison est utile lorsqu’un projet nécessite des données structurées provenant de plusieurs sites web, sans vouloir exploiter son propre parc de navigateurs.
Les scénarios JavaScript peuvent cliquer, faire défiler les pages, saisir du texte ou attendre avant la collecte des données. La sortie au format Markdown prend en charge les processus de traitement de contenu par l’IA, et les captures d’écran permettent de conserver une image de la page rendue. Le produit propose également actuellement des API dédiées à certaines cibles, ainsi qu’un accès par interface en ligne de commande (CLI) et par MCP. Un développeur peut utiliser des règles d’extraction explicites pour les champs stables et l’extraction en langage naturel lorsque la structure de la page ou la question est moins prévisible.
La différence avec une plateforme de navigateurs hébergée est d’ordre pratique : ScrapingBee met l’accent sur la requête et le résultat qu’elle renvoie, tandis qu’une application personnalisée prend en charge l’ensemble du processus. La coordination entre plusieurs pages, la déduplication, la planification des actualisations et la validation des enregistrements doivent toujours être gérées ailleurs. La consommation de crédits varie également selon les fonctionnalités utilisées, notamment le rendu et les options de proxy. Nous le recommandons aux équipes de développement qui privilégient une interface HTTP simple et souhaitent gérer l’orchestration de leur pipeline de données dans leur propre code.
Avantages et inconvénients
- Les règles de sélection et l’extraction par IA offrent une grande souplesse
- Le rendu et les scénarios prennent en charge les pages interactives
- Markdown, CLI et prise en charge du MCP pour les processus d’IA
- Les options avancées de requête augmentent la consommation de crédits
- Les tâches portant sur plusieurs pages nécessitent toujours une orchestration
9. Oxylabs
Oxylabs est une excellente option pour les équipes qui souhaitent accéder, par l’intermédiaire d’un service géré, à des sites web publics difficiles à exploiter et pouvoir augmenter leurs volumes de collecte. Son Web API actuel comprend l’offre /Scrape, qui permet de récupérer et de structurer des données web, avec le rendu JavaScript et la gestion de l’accès intégrés au service. La gamme comprend également /Search et une infrastructure de navigateur, offrant aux équipes plusieurs approches selon que la tâche commence par la recherche de sources, l’extraction ou l’interaction.
Des options adaptées à chaque cible permettent de récupérer des champs utiles à partir de sources courantes de recherche et de commerce en ligne, tandis que les connexions d’agents via MCP et Agent Skills intègrent la collecte aux processus d’IA. Oxylabs continue également à documenter séparément son Classic Web Scraper API. Cette distinction est importante pour les intégrations existantes : une équipe qui utilise le Classic API doit consulter la documentation correspondante au lieu de supposer qu’un exemple plus récent de Web API est interchangeable.
Oxylabs est particulièrement adapté lorsque la difficulté d’accès aux cibles, le débit ou le coût de la gestion d’une infrastructure d’accès justifient le recours à une plateforme gérée. L’application doit toutefois définir le schéma souhaité, la période de fraîcheur des données et le traitement des enregistrements incomplets. Avant le déploiement, faites correspondre la génération d’API choisie, les options propres à chaque cible et le modèle d’utilisation aux besoins réels de la tâche. Pour une petite extraction manuelle, un outil visuel de scraping peut être plus adapté.
Avantages et inconvénients
- Infrastructure gérée de rendu et d’accès
- Options d’extraction structurée adaptées à chaque cible
- L’API Web actuelle prend en charge les intégrations d’agents
- Les API classique et actuelle nécessitent des configurations distinctes
- La qualité des résultats doit toujours être vérifiée dans l’application
10. Diffbot
Diffbot est notre choix lorsque comprendre les informations d’une page compte davantage que reproduire sa mise en page. Extract utilise la vision par ordinateur et le traitement automatique du langage naturel pour classer les pages et produire du JSON structuré à l’aide de schémas standard. Pour une équipe qui collecte des articles ou des produits provenant de nombreuses sources, cela peut réduire la quantité de code d’analyse propre à chaque site nécessaire pour convertir les pages en données comparables.
Son Knowledge Graph répond à un besoin connexe, mais distinct : travailler avec des entités comme des organisations, des personnes et des articles déjà rassemblés à partir du Web public. Les enregistrements peuvent combiner des informations provenant de plusieurs sources et relier les entités au moyen de relations pertinentes. Diffbot est ainsi utile pour l’enrichissement des données, la recherche sur les entreprises et les applications de veille qui nécessitent un contexte allant au-delà des champs visibles sur une seule page.
Le compromis tient à l’adéquation avec le modèle de données de Diffbot. L’extraction standardisée est précieuse lorsque les types de pages et les champs proposés correspondent au besoin, mais un champ inhabituel ou une interaction spécialisée peut nécessiter une autre approche. Les équipes doivent distinguer l’extraction à partir des URL de leur choix de l’interrogation d’un graphe de connaissances existant, puis évaluer en conséquence la couverture et l’actualité des sources. Diffbot convient davantage aux équipes techniques qui créent des produits d’information normalisés qu’aux utilisateurs qui souhaitent simplement copier quelques lignes dans un tableur.
Avantages et inconvénients
- La classification automatique réduit le travail d’analyse des pages
- Les schémas standard aident à normaliser les pages similaires
- Le Knowledge Graph apporte du contexte sur les entités
- Les champs standard peuvent ne pas répondre aux besoins spécialisés
- L’extraction et l’accès au graphe répondent à des besoins différents
Foire aux questions
Qu’est-ce qui rend un outil de collecte de données Web fondé sur l’IA ?
L’IA peut aider à repérer des champs, à interpréter le contenu des pages, à générer des étapes d’extraction ou à piloter les actions du navigateur. Certains outils utilisent l’IA lors de la configuration, tandis que d’autres y font appel pour chaque extraction. Un service peut également alimenter des applications d’IA en leur fournissant du contenu propre, sans utiliser un modèle de langage pour chaque requête. Choisissez la fonctionnalité qui répond à votre besoin de collecte plutôt que de vous fier à l’étiquette.
Quelle est la différence entre la collecte de données et l’automatisation du navigateur ?
La collecte de données permet de recueillir des informations. L’automatisation du navigateur effectue des actions sur une page, comme ouvrir des menus, lancer une recherche ou suivre un processus en plusieurs étapes. Ces deux opérations sont souvent complémentaires : un navigateur automatisé accède à la page voulue, puis une étape d’extraction recueille les champs. Une requête directe à une API est généralement plus simple lorsque ces interactions ne sont pas nécessaires.
Quels outils conviennent le mieux à une équipe non technique ?
Browse AI est notre première recommandation pour les collectes récurrentes simples et le suivi des modifications. Octoparse est une excellente solution de remplacement lorsque l’équipe souhaite mieux contrôler visuellement les étapes de la tâche. Les deux fonctionnent mieux si quelqu’un vérifie les données obtenues et sait repérer les changements apportés au site Web source.
Que doit conserver un pipeline d’IA ou de RAG à partir des données collectées ?
Conservez l’URL source, l’heure de collecte, le titre de la page ainsi que le texte ou les champs structurés dont l’application a besoin. Le Markdown peut préserver la structure lisible du document, tandis que le JSON convient aux enregistrements définis. Supprimez les contenus en double et évitez de mêler les éléments de navigation au contenu principal. La conservation de la provenance facilite la vérification et l’actualisation des réponses par la suite.
Quand vaut-il la peine d’utiliser un navigateur géré ?
Un navigateur géré est utile lorsque la collecte nécessite l’exécution de JavaScript, plusieurs interactions ou le maintien d’une session, et que votre équipe souhaite éviter d’héberger des processus de navigateur. Browserless est une solution ciblée pour le code Puppeteer ou Playwright déjà en place. Pour une seule page statique, une API de récupération ou d’extraction plus simple peut nécessiter moins de ressources.
1 000 unités gratuites équivalent-elles à 1 000 extractions ?
Non. Les unités et les crédits sont soumis aux règles propres à chaque fournisseur. Browserless décompte les connexions au navigateur par tranches pouvant aller jusqu’à 30 secondes, et la consommation d’unités augmente en cas de trafic passant par un proxy ou de résolution de CAPTCHA. D’autres services facturent en fonction des options de requête, des enregistrements ou de la puissance de calcul. Évaluez l’ensemble du processus plutôt que de considérer comme équivalentes les différentes offres gratuites.
Peut-on se fier à un résultat d’extraction par IA sans le vérifier ?
Une réponse JSON valide peut tout de même omettre un enregistrement ou mal interpréter un champ. Définissez les champs obligatoires, vérifiez les types et les plages de valeurs, examinez un échantillon des pages sources et surveillez l’évolution du nombre d’enregistrements. Pour les tâches récurrentes, il est plus utile de prévoir explicitement les états d’échec et de résultat vide que de considérer chaque réponse comme un jeu de données complet.
Conclusion sur les outils de collecte de données Web fondés sur l’IA
Bright Data est notre choix privilégié pour un programme général de collecte de données sur le Web, tandis que Firecrawl constitue le meilleur point de départ pour transformer des pages Web en contenu prêt pour l’IA. Choisissez Apify lorsque les outils réutilisables, les tâches planifiées et les opérations dans le cloud sont au cœur du projet.
Pour les équipes en entreprise, Browse AI facilite la surveillance régulière, tandis que Octoparse permet aux utilisateurs d’affiner visuellement des tâches d’extraction plus complexes. SearchAPI est la solution spécialisée à privilégier lorsque le résultat attendu consiste en des données de recherche structurées.
Browserless mérite sa place auprès des développeurs qui souhaitent exécuter des navigateurs dans un environnement géré à l’aide de bibliothèques d’automatisation familières. ScrapingBee constitue une excellente solution de rechange lorsqu’une requête d’extraction gérée convient mieux à l’application. Oxylabs répond aux besoins exigeants de collecte de données sur le Web public, tandis que Diffbot se distingue par l’extraction normalisée et l’analyse des entités.
Le meilleur choix à long terme est celui qui fournit les informations requises au moyen d’un processus que votre équipe peut maintenir. Adaptez la méthode de collecte à la tâche, préservez le contexte des sources et évaluez la valeur en fonction de l’utilité des résultats, et non du nombre de pages demandées.




