
Angle d’Anderson
Édition d’objets assistée par l’IA avec Imagic de Google et Erase and Replace de Runway

 Ajouter Unite.AI à vos sources préférées sur Google

Points clésImagic affine les modèles de diffusion pour des modifications granulaires d'objets…
Voir plus
- Imagic affine les modèles de diffusion pour des modifications granulaires d'objets, contrairement à Erase and Replace de Runway qui ne fait que remplacer.
- Erase and Replace de Runway substitue rapidement des objets mais ne peut pas modifier le contenu existant, seulement le remplacer.
- L'optimisation par image d'Imagic prend huit minutes sur des puces TPUV4 jumelées, ce qui la limite à un usage via API.
Cette semaine, deux nouveaux algorithmes graphiques pilotés par l’IA, mais contrastés, offrent des moyens novateurs aux utilisateurs finaux d’apporter des modifications très granulaires et efficaces aux objets présents sur les photos.
Le premier est Imagic, issu de Google Research, en collaboration avec l’Israel Institute of Technology et le Weizmann Institute of Science. Imagic propose une édition d’objets conditionnée par le texte, à fine granularité, via le fine‑tuning de modèles de diffusion.

Modifiez ce que vous voulez et laissez le reste intact : Imagic promet une édition précise des seules parties que vous souhaitez changer. Source : https://arxiv.org/pdf/2210.09276.pdf
Quiconque a déjà tenté de modifier un seul élément lors d’un re‑rendu Stable Diffusion sait trop bien que, pour chaque modification réussie, le système altère cinq éléments que vous aimiez tels quels. C’est une lacune qui pousse aujourd’hui de nombreux passionnés de SD à passer constamment de Stable Diffusion à Photoshop pour corriger ce type de « dommages collatéraux ». Dès ce point de vue, les performances d’Imagic semblent remarquables.
Au moment de la rédaction, Imagic ne dispose pas encore d’une vidéo promotionnelle et, compte tenu de l’attitude circonspecte de Google vis‑à‑vis de la diffusion d’outils de synthèse d’image sans restriction, il est incertain dans quelle mesure, le cas échéant, nous pourrons tester le système.
La seconde proposition est la fonction Erase and Replace de Runway ML, plus accessible, une nouvelle fonctionnalité de la section « AI Magic Tools » de sa suite exclusivement en ligne d’utilitaires d’effets visuels basés sur l’apprentissage automatique.
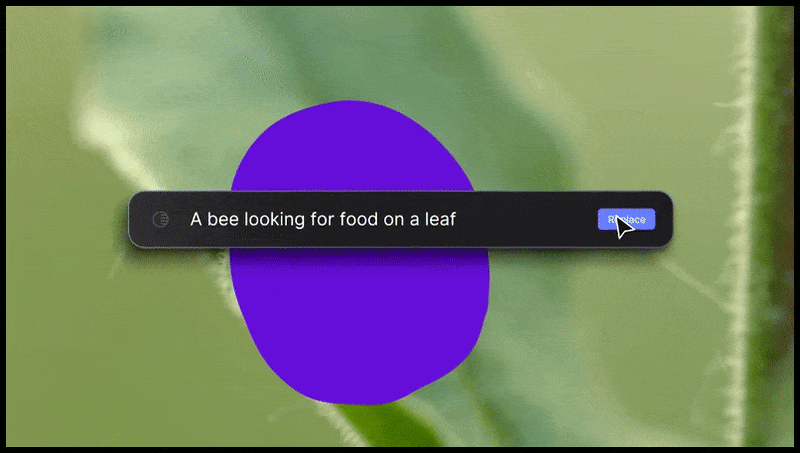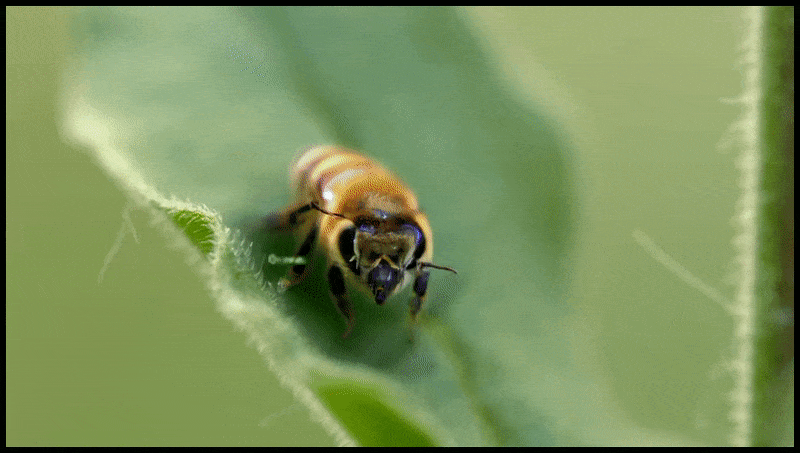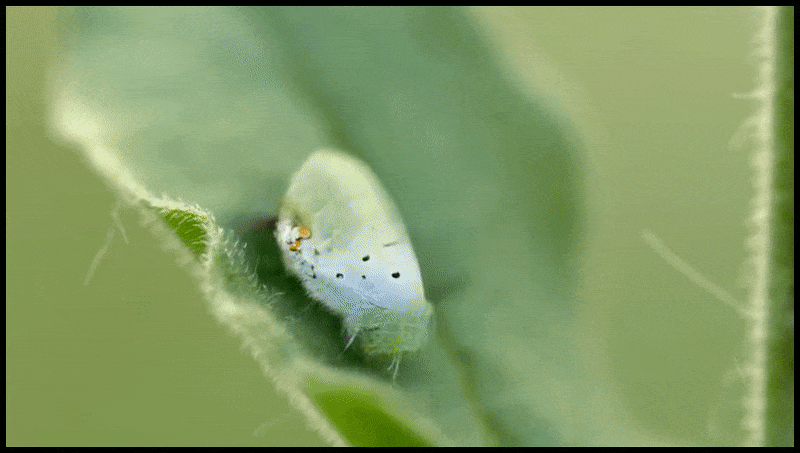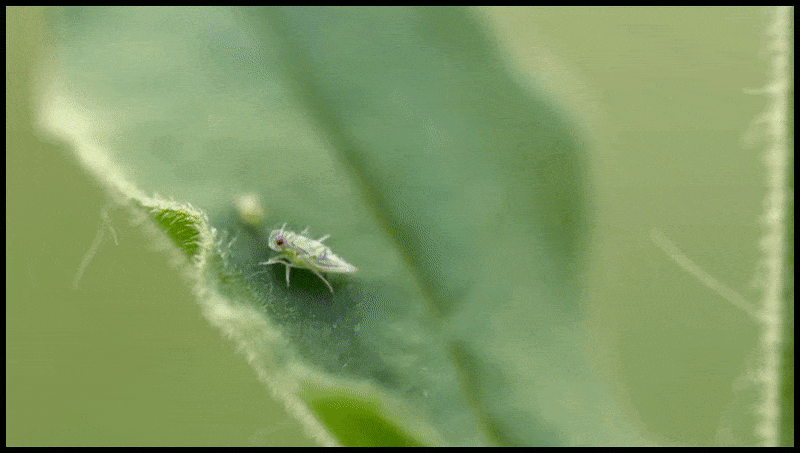
La fonction Erase and Replace de Runway ML, déjà montrée dans un aperçu de système de montage vidéo commandé par texte.
Examinons d’abord la sortie de Runway.
Erase and Replace
Tout comme Imagic, Erase and Replace ne traite que des images fixes, bien que Runway ait prévisualisé la même fonctionnalité dans une solution d’édition texte‑à‑vidéo qui n’est pas encore publiée :
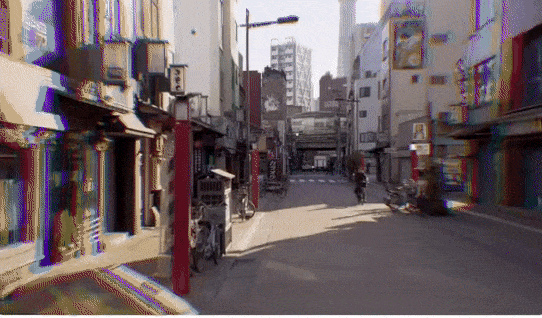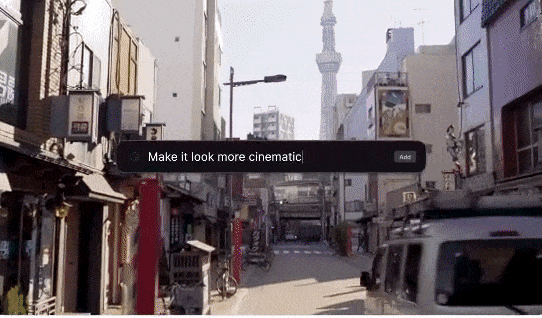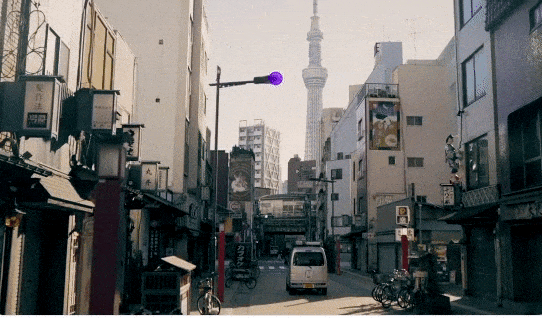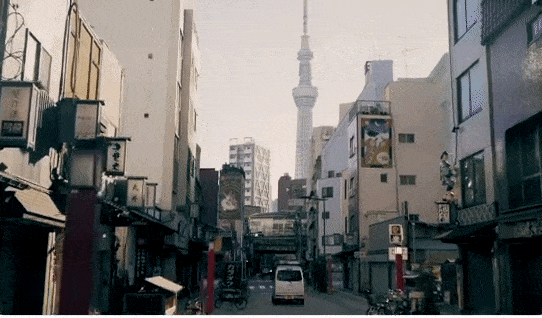
Chacun peut tester le nouvel Erase and Replace sur des images, mais la version vidéo n’est pas encore accessible au public. Source : https://twitter.com/runwayml/status/1568220303808991232
Bien que Runway ML n’ait pas publié les détails techniques d’Erase and Replace, la rapidité avec laquelle vous pouvez remplacer une plante d’intérieur par un buste raisonnablement convaincant de Ronald Reagan suggère qu’un modèle de diffusion tel que Stable Diffusion (ou, bien moins probable, un DALL‑E 2 sous licence) est le moteur qui recrée l’objet de votre choix dans Erase and Replace.

Remplacer une plante d’intérieur par un buste de The Gipper n’est pas aussi rapide que dans cet exemple, mais reste assez rapide. Source : https://app.runwayml.com/
Le système comporte certaines restrictions de type DALL‑E 2 – les images ou textes qui déclenchent les filtres Erase and Replace généreront un avertissement concernant une éventuelle suspension de compte en cas de nouvelles infractions – pratiquement un clone standard des politiques d’OpenAI pour DALL‑E 2.
De nombreux résultats manquent des bords rugueux typiques de Stable Diffusion. Runway ML est investisseur et partenaire de recherche dans SD, et il est possible qu’ils aient entraîné un modèle propriétaire supérieur aux poids checkpoint open‑source 1.4 que le reste d’entre nous manipule actuellement (tout comme de nombreux autres groupes de développement, amateurs ou professionnels, entraînent ou ajustent actuellement des modèles Stable Diffusion).
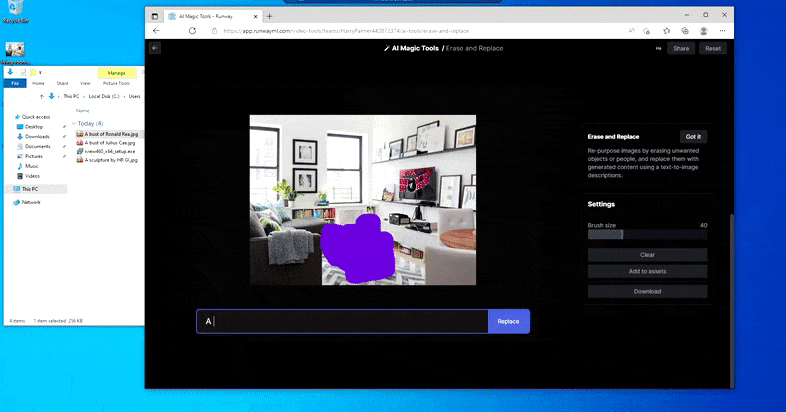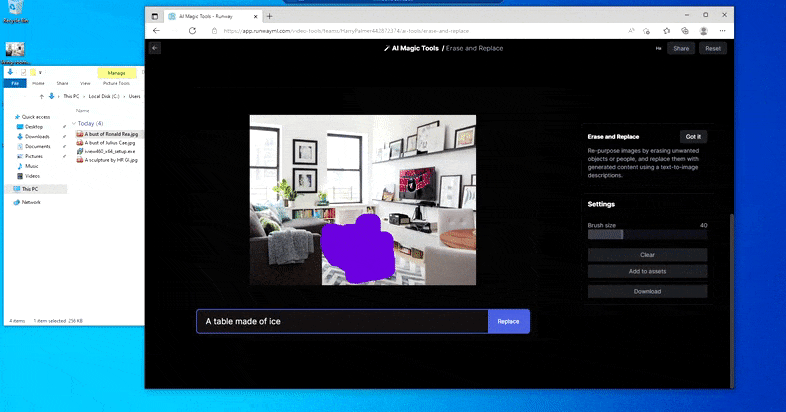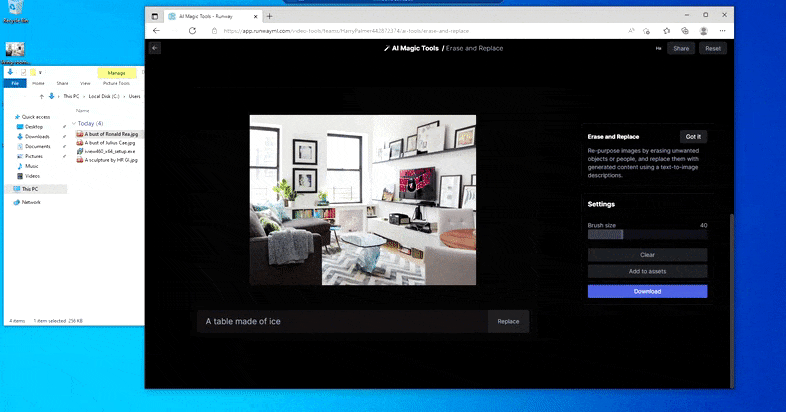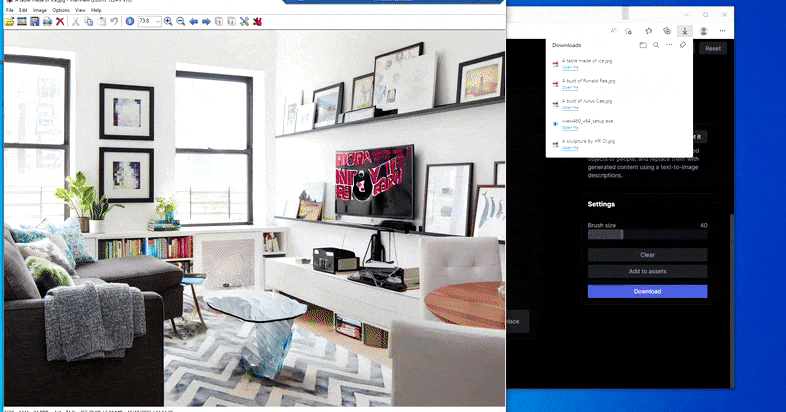
Remplacement d’une table domestique par une table de glace dans Erase and Replace de Runway ML.
Comme pour Imagic (voir ci‑dessous), Erase and Replace est « orienté objet » – vous ne pouvez pas simplement effacer une partie « vide » de l’image et la remplir avec le résultat de votre invite texte ; dans ce cas, le système trace simplement l’objet apparent le plus proche le long de la ligne de visée du masque (comme un mur ou une télévision) et y applique la transformation.
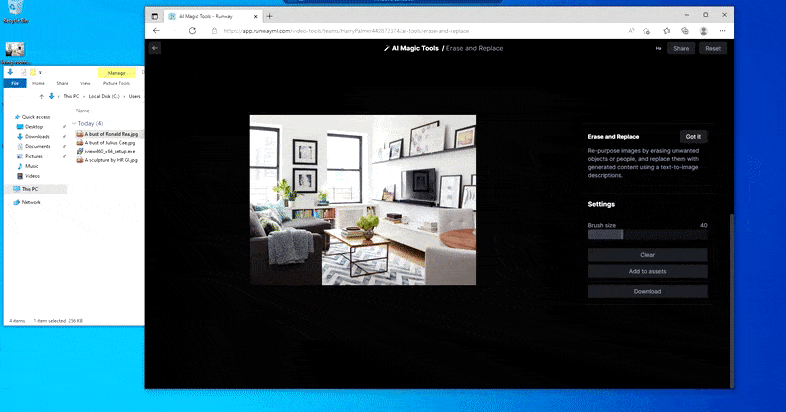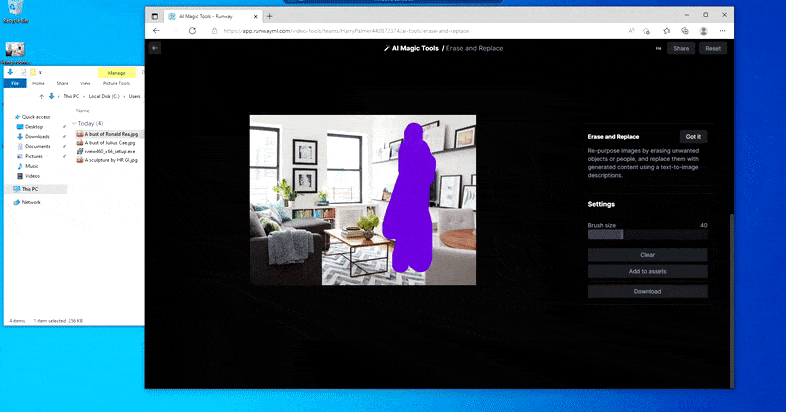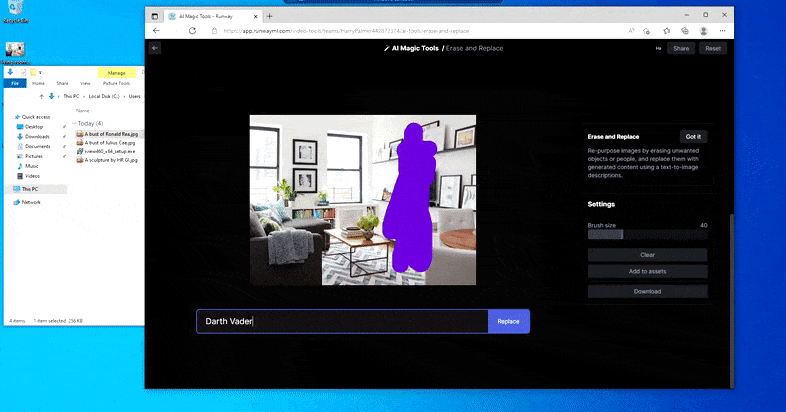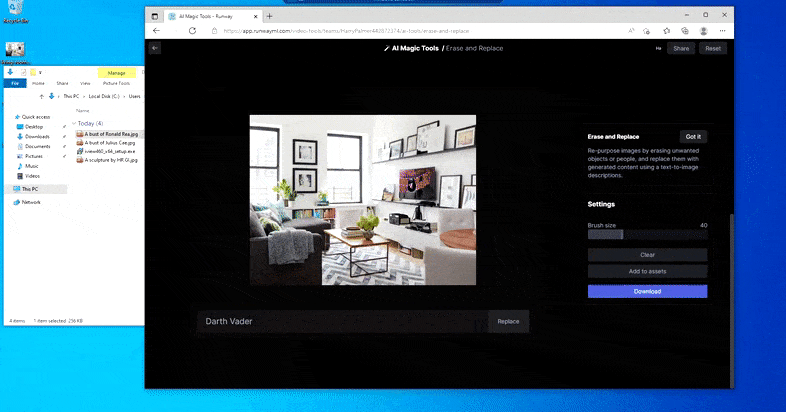
Comme son nom l’indique, Erase and Replace ne peut pas ajouter d’objets dans un espace vide. Ici, tenter de faire apparaître le plus célèbre des seigneurs Sith produit une étrange fresque liée à Vador sur le téléviseur, à peu près à l’endroit où la zone de remplacement a été dessinée.
Il est difficile de déterminer si Erase and Replace se montre évasif quant à l’utilisation d’images protégées par le droit d’auteur (qui restent largement bloquées, avec un succès variable, dans DALL‑E 2), ou si le modèle utilisé dans le moteur de rendu en arrière‑plan n’est tout simplement pas optimisé pour ce type de tâche.

La fresque de Nicole Kidman, légèrement osée pour un environnement professionnel, indique que le modèle, présumé fondé sur la diffusion, n’a pas l’ancien refus systématique de DALL-E 2 de rendre des visages réalistes ou du contenu suggestif. Les tentatives de reproduire des œuvres protégées vont de l’ambigu (xénomorphe) à l’absurde (trône de fer). L’image source est insérée en bas à droite.
Il serait intéressant de savoir quelles méthodes Erase and Replace utilise pour isoler les objets qu’il peut remplacer. On suppose que l’image est passée par une dérivation de CLIP, les éléments discrets étant identifiés par reconnaissance d’objets puis segmentation sémantique. Aucune de ces opérations ne fonctionne aussi bien dans une installation « standard » de Stable Diffusion.
Mais rien n’est parfait – parfois le système semble effacer sans remplacer, même lorsque (comme nous l’avons vu sur l’image ci‑dessus), le mécanisme de rendu sous‑jacent comprend clairement ce que signifie une invite texte. Dans ce cas, il est impossible de transformer une table basse en xénomorphe – la table disparaît simplement.
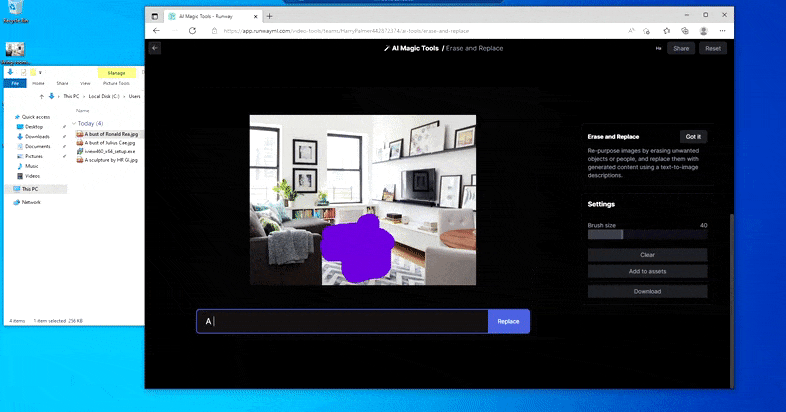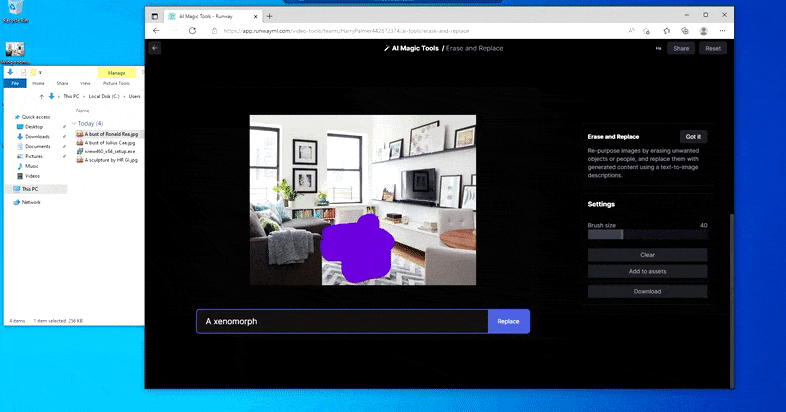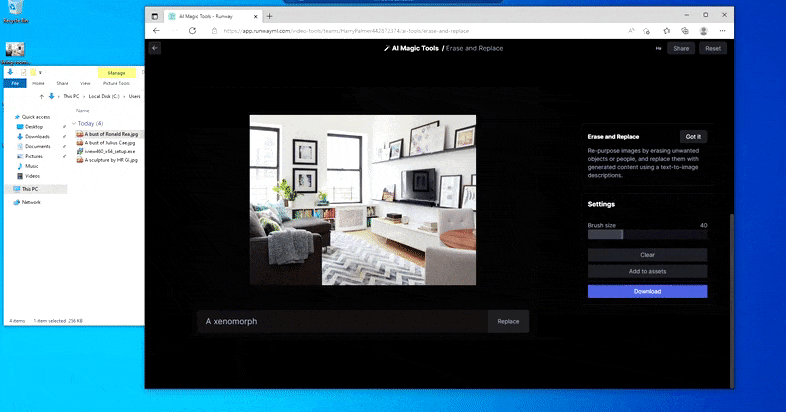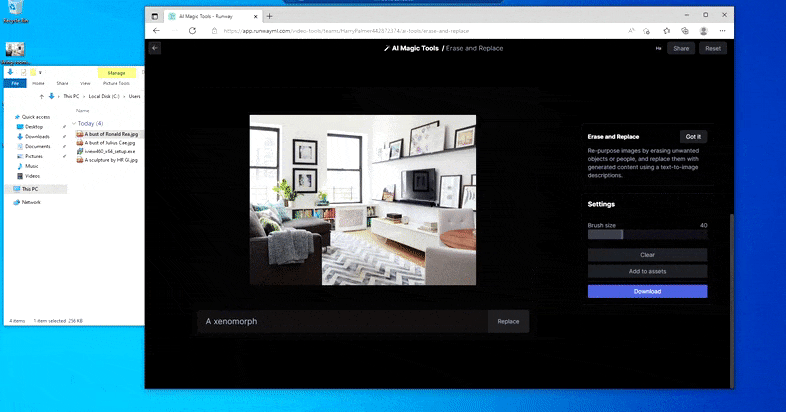
Une version plus effrayante d’Où est Charlie, car Erase and Replace ne parvient pas à produire d’extraterrestre.
Erase and Replace apparaît comme un système de substitution d’objets efficace, avec un inpainting excellent. Cependant, il ne peut pas modifier les objets perçus existants, mais seulement les remplacer. Modifier réellement le contenu d’une image existante sans compromettre le contenu environnant est sans doute une tâche bien plus difficile, liée à la longue lutte du secteur de la recherche en vision par ordinateur pour le désentrelacement dans les différents espaces latents des cadres populaires.
Imagic
C’est une tâche qu’Imagic relève. Le nouvel article propose de nombreux exemples de retouches qui modifient avec succès des facettes individuelles d’une photo tout en laissant le reste de l’image intact.

Dans Imagic, les images modifiées ne souffrent pas des étirements, distorsions et suppositions sur les parties masquées propres à l’animation de marionnettes deepfake, qui utilise des connaissances préalables limitées tirées d’une seule image.
Le système utilise un processus en trois étapes : optimisation de l’incorporation de texte ; fine‑tuning du modèle ; et, enfin, génération de l’image modifiée.

Imagic encode la consigne textuelle cible pour obtenir la représentation initiale du texte, puis optimise le résultat pour obtenir l’image d’entrée. Le modèle génératif est ensuite ajusté à l’image source, avec ajout de paramètres, avant l’interpolation demandée.
Sans surprise, le cadre repose sur l’architecture texte‑à‑vidéo Imagen de Google, bien que les chercheurs déclarent que les principes du système sont largement applicables aux modèles de diffusion latente.
Imagen utilise une architecture à trois niveaux, plutôt que le tableau à sept niveaux employé pour la version texte‑à‑vidéo plus récente de la société version texte-vidéo du logiciel. Les trois modules distincts comprennent un modèle de diffusion génératif fonctionnant à une résolution de 64 × 64 px ; un modèle de super‑résolution qui agrandit cette sortie à 256 × 256 px ; et un modèle de super‑résolution supplémentaire qui porte la sortie jusqu’à une résolution de 1024 × 1024 px.
Imagic intervient dès la première étape de ce processus, en optimisant l’incorporation de texte demandée au stade 64 px avec un optimiseur Adam à un taux d’apprentissage fixe de 0,0001.

Une démonstration magistrale de séparation des représentations : ceux qui ont essayé de changer ne serait-ce que la couleur d’un objet rendu par un modèle de diffusion, GAN ou NeRF savent combien il est important qu’Imagic puisse le faire sans détruire la cohérence du reste de l’image.
Le fine‑tuning s’effectue ensuite sur le modèle de base d’Imagen, pendant 1500 pas par image d’entrée, conditionné sur l’incorporation révisée. Simultanément, la couche secondaire 64 px > 256 px est optimisée en parallèle sur l’image conditionnée. Les chercheurs notent qu’une optimisation similaire pour la couche finale 256 px > 1024 px a « peu ou pas d’effet » sur les résultats finaux, et n’a donc pas été implémentée.
L’article indique que le processus d’optimisation dure environ huit minutes par image sur deux puces TPUV4. Le rendu final s’effectue dans le cœur d’Imagen selon le schéma d’échantillonnage DDIM.
En commun avec les processus de fine‑tuning similaires pour le DreamBooth de Google, les incorporations résultantes peuvent également être utilisées pour la stylisation, ainsi que pour des retouches photoréalistes contenant des informations tirées de la vaste base de données sous‑jacente alimentant Imagen (puisque, comme le montre la première colonne ci‑dessous, les images sources ne contiennent aucun des contenus nécessaires à ces transformations).

Imagic permet des mouvements et retouches photoréalistes souples, tandis que les codes dérivés et séparés obtenus durant le processus peuvent tout aussi facilement servir à des résultats stylisés.
Les chercheurs ont comparé Imagic à des travaux antérieurs tels que SDEdit, une approche basée sur les GAN de 2021, fruit d’une collaboration entre l’Université Stanford et l’Université Carnegie Mellon ; et Text2Live, une collaboration d’avril 2022 entre le Weizmann Institute of Science et NVIDIA.

Comparaison visuelle entre Imagic, SDEdit et Text2Live.
Il apparaît clairement que les approches précédentes peinent, mais dans la rangée du bas, qui implique une modification massive de pose, les concurrents échouent complètement à reconstituer le matériau source, contrairement à un succès notable d’Imagic.
Les exigences en ressources d’Imagic et le temps d’entraînement par image, bien que courts au regard de telles entreprises, en font une inclusion improbable dans une application locale d’édition d’images sur des ordinateurs personnels – et il n’est pas clair dans quelle mesure le processus de fine‑tuning pourrait être réduit à un niveau consommateur.
En l’état actuel, Imagic est une offre impressionnante, davantage adaptée aux API – un environnement que Google Research, réticent aux critiques concernant la facilitation du deepfake, pourrait tout de même privilégier.
Première publication le 18 octobre 2022.


