
Leaders d’opinion
Le prochain goulot d’étranglement de puissance de l’IA sera à l’intérieur des villes

 Ajouter Unite.AI à vos sources préférées sur Google
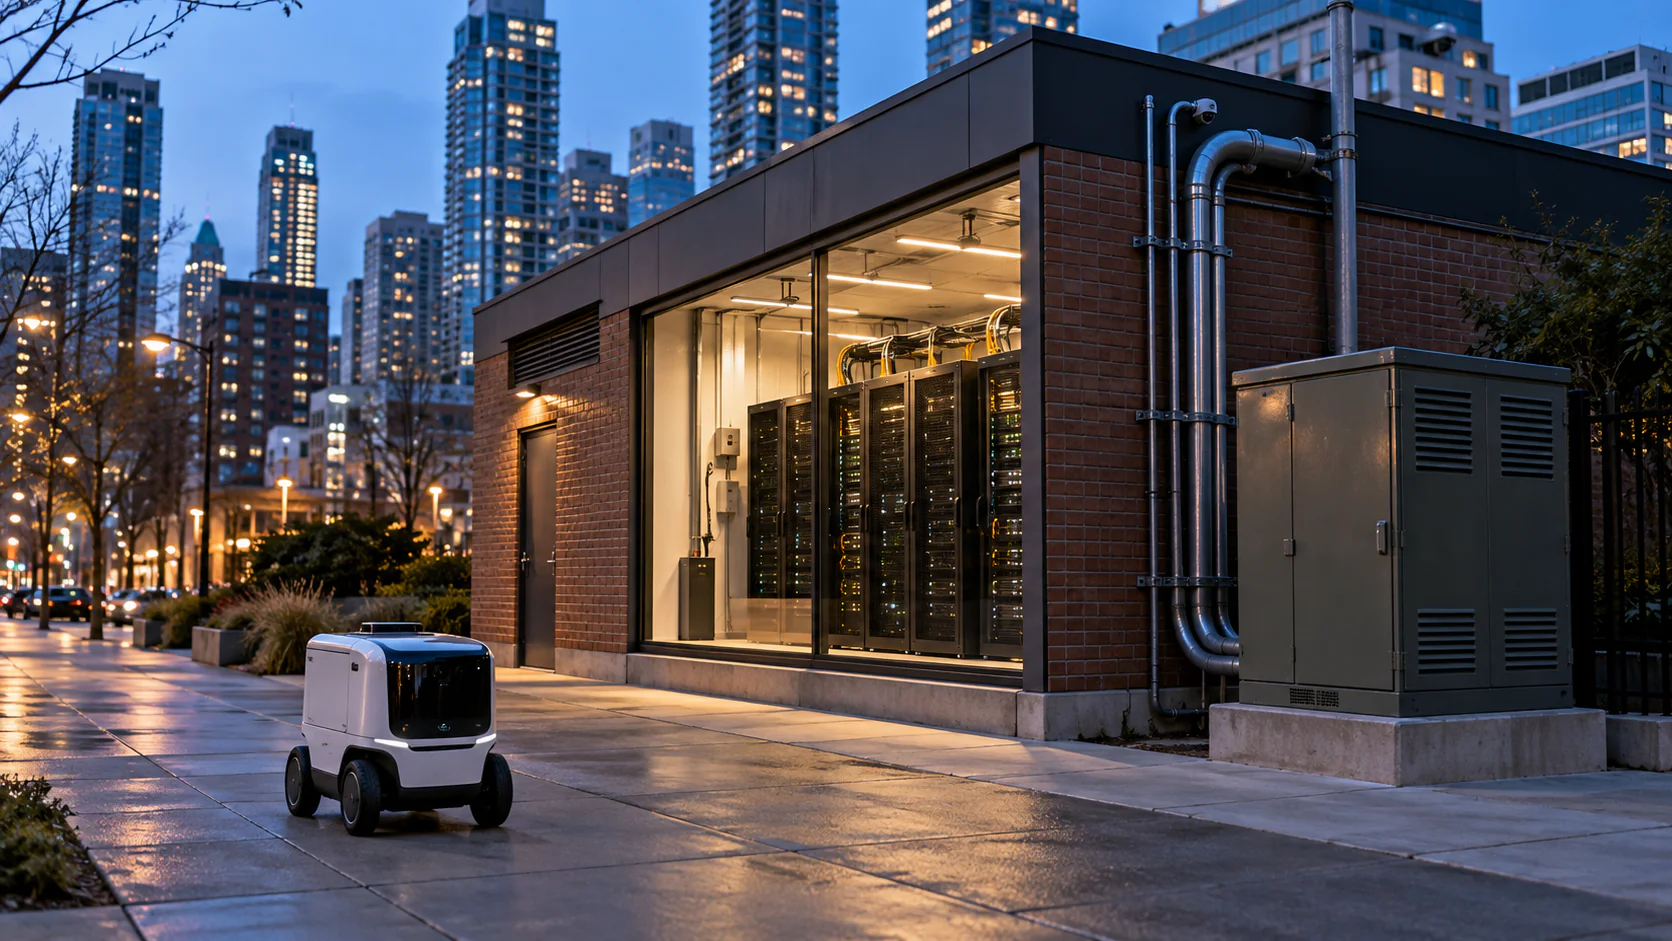
Au cours des dernières années, et cela continue, le marché des infrastructures d’IA a consacré beaucoup de temps et d’argent (près de 7 000 milliards de dollars d’investissements dans les centres de données d’ici 2030, selon l’estimation de McKinsey) à apprendre comment construire de grands centres de données partout où l’électricité est disponible. « Partout » est le mot clé, car la localisation n’était pas très importante. Un groupe d’entraînement a simplement besoin d’un accès à une puissance suffisante. Mais la localisation commence à devenir de plus en plus pertinente aujourd’hui, à mesure que l’usage de l’IA s’étend au-delà des interfaces de chat vers les machines, les systèmes vocaux, la vidéo et les applications qui interagissent avec le monde physique. De telles opérations nécessitent que la puissance de calcul soit plus proche des centres urbains où ces interactions ont lieu afin de réduire la latence. Alors que des outils comme les chatbots peuvent tolérer un délai d’une demi‑seconde, les applications de service automatisées telles que les robots de livraison supervisés à distance, les assistants vocaux en direct ou les systèmes d’exécution automatisés peuvent devoir réagir en quelques millisecondes.
C’est le nouveau défi qui se présente aux entreprises d’IA. Comment trouver des blocs plus petits d’énergie fiable dans et autour des grandes zones métropolitaines ? Et même après avoir repéré les sites, comment gérer la réaction négative à laquelle même les centres de données éloignés sont confrontés ?
La demande d’IA dans les centres urbains augmente
Il y a une demande croissante dans la sphère urbaine pour l’IA qui dépasse l’usage personnel des chatbots ou toute obsession des robots. Un document de travail du FMI estime que la consommation d’électricité des centres de données et de l’IA avait déjà atteint 400 à 500 TWh à l’échelle mondiale en 2023, et que la consommation induite par l’IA pourrait potentiellement atteindre 1 500 TWh d’ici 2030. L’automatisation nécessaire pour rendre les opérations simples plus efficaces — que ce soit le traitement de documents ou l’archivage de vidéos — requiert beaucoup d’énergie à grande échelle.
Les villes sont à l’avant‑garde de ce phénomène, comme le montre une étude de l’OCDE portant sur 250 villes dans 78 pays. Elle a constaté que 56 % utilisaient déjà activement l’IA, tandis que 35 % supplémentaires étaient en phase de pilote ou de planification de déploiements. Pour illustrer un cas d’utilisation simple, considérons les caméras de surveillance dans la ville. IHS Markit a estimé il y a plusieurs années que le nombre de caméras de surveillance dans le monde dépasserait un milliard. Bien qu’elles soient principalement utilisées à des fins d’enregistrement, elles sont désormais employées pour d’autres tâches plus exigeantes sur le plan informatique, par exemple le suivi d’objets à travers un réseau ou la recherche dans de grandes archives vidéo à l’aide du langage naturel. De tels processus ne peuvent pas être réalisés dans chaque caméra avec le traitement d’IA actuel. Devraient‑elles être envoyées hors de la ville vers un centre de données lointain pour être traitées ? Cela est impraticable en raison des réglementations sur les données et du coût du transfert de volumes de trafic aussi importants.
Une enquête récente de Gallup montre qu’environ 30 % des employés du secteur privé et public utilisent l’IA dans leurs fonctions, et que ce pourcentage augmente. Ces secteurs — qu’il s’agisse de banques, d’hôpitaux ou d’organisations publiques — rencontrent les mêmes problèmes. Ils souhaitent une infrastructure IA au sein de leur propre juridiction et suffisamment proche physiquement pour être contrôlée. Leurs systèmes vocaux interactifs et leurs applications vidéo se dégradent à mesure que la latence du réseau augmente. Même si le problème peut être contourné initialement en conservant un opérateur humain pour la première génération de systèmes autonomes, cette supervision n’est pas très tolérante à la latence. Par exemple, les robots de livraison et les robots domestiques supervisés via une connexion vidéo nécessitent une boucle de communication complète qui doit rester en dessous de environ 80 millisecondes, selon une étude de téléopération robotique à distance. Les voitures autonomes, paradoxalement, constituent une exception : la conduite reste à bord pour des raisons de sécurité, et les opérateurs à distance de Waymo travaillent avec un quart de seconde de latence, certains depuis un autre continent. Ce que la ville hérite des flottes autonomes, ce sont leurs données, pas leur volant.
Le marché des centres de données sous-estime cette hausse de la demande. La Banque mondiale a publié un article montrant comment les municipalités de pays comme l’Argentine, l’Inde et l’Éthiopie, entre autres, ont adopté l’IA dans les domaines de la justice, de la lutte contre la corruption, des douanes, de l’administration publique et de l’amélioration des services. Ce n’est pas un phénomène local. C’est une transformation mondiale. Chez Teravolt, notre estimation est qu’une zone métropolitaine de 10 à 15 millions d’habitants pourrait supporter environ 6 à 13 MW de charge IA continue sensible à la latence d’ici 2030, avant le déploiement massif de robots à usage général. On peut soutenir que ce n’est pas un chiffre très élevé selon les standards hyperscalaire, mais le trouver au bon endroit est bien plus difficile qu’il n’y paraît. D’ici 2036, la même zone métropolitaine passerait à 22 à 50 MW de charge sensible à la latence — et à 60 à 100 MW si l’industrie automobile commence à produire des robots à l’échelle automobile. L’économie de la demande est impitoyable dans le bon sens : quelques centaines de dollars par an de coût serveur sur une machine qui remplace 30 000 à 60 000 $ de main‑d’œuvre constitue une demande qui ne négocie pas le prix.
Ajouter un quatrième niveau à l’informatique
Actuellement, la puissance de calcul pour l’IA existe à trois niveaux. La couche supérieure se compose de gigafactories utilisées pour entraîner les modèles. Leur localisation n’importe aux développeurs que dans la mesure où elle garantit de grandes quantités d’énergie à un prix acceptable. Viennent ensuite les installations d’IA régionales, généralement entre 20 et 200 MW, où une grande partie de la demande récurrente d’inférence dans les principales opérations cloud et d’entreprise se produit. Enfin, nous disposons de la puissance de calcul intégrée directement dans l’appareil ou le robot.
Il semble y avoir un écart entre les deux dernières couches que j’identifie comme la couche urbaine — l’écart responsable des problèmes de latence. Celles‑ci devraient être situées à l’intérieur ou très près de grandes villes. Elles devraient être mesurées en mégawatts à un chiffre ou à deux chiffres faibles tout en étant positionnées dans les zones métropolitaines et connectées à une fibre de haute qualité. Le point de départ pourrait être d’environ 2 MW si le site dispose d’une alimentation garantie. Pour illustrer la praticité, prenons l’exemple d’un robot de livraison. Il traite différentes requêtes et toutes ne peuvent pas être traitées sur l’appareil lui‑même. Bien qu’il soit entraîné dans la gigafactory, une assistance plus avancée en temps réel devrait être traitée par une installation urbaine proche au lieu de l’envoyer à chaque fois à une installation régionale.
Le problème du trafic bidirectionnel
Les centres de données urbains ne seront pas simplement des points intermédiaires de réception des données provenant des centres d’entraînement, mais ils produiront également de grandes quantités de données à renvoyer en amont du pipeline.
Toutes les machines autonomes et les systèmes riches en capteurs accumuleront des informations qui devront être traitées et renvoyées pour être intégrées à l’entraînement. Les flottes de robots revenant à leurs stations de charge après un quart de travail enverront d’énormes données utiles sur les cas limites et les opérations quotidiennes dont les centres de données ont besoin pour améliorer leurs fonctions. Imaginez tout ce trafic envoyé en même temps dans la même direction. Cela créera un goulot d’étranglement. C’est également là que le centre de données urbain s’avère utile, car il peut traiter une partie de la charge avant qu’elle n’écrase l’installation de calcul régionale. Il peut identifier et éliminer certaines données erronées tout en compressant et en transmettant les parties utiles.
Essentiellement, le centre de données urbain ajoute une couche supplémentaire de filtrage aux deux couches qui le précèdent, rendant le flux de données encore plus organisé.
L’avenir sera-t‑il un serveur sur chaque pâté de maisons ?
Bien que je présente les serveurs urbains comme une solution, il est simplement trop coûteux de résoudre les problèmes de latence par une prolifération incontrôlée. Quelle que soit la taille, un centre de données nécessite toujours une connexion au réseau électrique, des transformateurs, du refroidissement, de la sécurité, du réseau et du personnel. Ces coûts ne diminuent pas proportionnellement à la charge informatique. Pour mettre cela en perspective, une installation de 0,5 MW supporte encore de nombreux les mêmes coûts fixes qu’un site beaucoup plus grand.
Dans nos projets, nous avons constaté qu’un centre de données urbain autonome devient économiquement viable à environ 5 à 8 MW. Même en supposant que plusieurs sites puissent partager un centre d’opérations réseau, le seuil ne descend qu’à 1,5 à 3 MW. Par conséquent, le résultat final reste le même. Diviser 20 MW répartis sur vingt sites au lieu de deux ou trois n’économisent pratiquement aucune latence à l’intérieur d’une zone métropolitaine — le réseau de fibre de la ville ne fait que quelques millisecondes — tout en multipliant le capital et les coûts d’exploitation.
C’est pourquoi je pense que l’industrie doit réduire sa taille et construire ce que j’appelle « stations‑sous‑poste pour l’intelligence ». Actuellement, les développeurs apprennent à construire des installations régionales dans la plage de 20 à 100 MW. L’objectif futur est d’appliquer cela à des sites urbains encore plus petits afin d’atteindre le niveau de 2 MW adapté aux grandes villes.
L’obstacle politique
Au‑delà de la viabilité économique, le défi politique demeure. Les centres de données sont devenus de plus en plus vilipendés dans les médias en raison de leur impact négatif sur l’environnement. Selon une enquête Pew, plus de la moitié des Américains estiment que les centres de données sont nocifs pour l’environnement et en ont une opinion négative. L’argument de la création d’emplois pâlit face à la quantité d’eau, de terrain et d’électricité consommés, ainsi qu’au bruit et aux émissions générés. Obtenir des autorisations même pour des installations urbaines plus petites s’avérerait difficile.
Nous constatons déjà des exemples de développeurs de centres de données et d’autorités municipales en conflit. Aux États‑Unis, l’utilisation par xAI de turbines à gaz pour accélérer son déploiement à Memphis a entraîné des litiges d’autorisation, une opposition communautaire et des poursuites. L’Europe est allée plus loin : Amsterdam a imposé un moratoire sur les installations supérieures à 70 MW, Dublin n’accepte désormais de nouveaux centres de données que s’ils apportent leur propre production ou stockage, et la sous‑station clé du corridor de West London ne sera pas renforcée avant le début des années 2030. Même en dehors de ces cas très médiatisés, étant donné que c’est un nouveau domaine de contestation, de nombreuses autorités municipales n’ont pas de processus d’approbation clair pour autoriser 10 MW supplémentaires d’infrastructure IA à l’intérieur de la zone urbaine. Comme le souligne un rapport du National League of Cities, l’un des défis les plus courants pour les villes est que les anciens codes de zonage locaux ne traitent pas explicitement les centres de données, ce qui conduit à des évaluations au cas par cas. De telles incertitudes juridiques peuvent retarder même des projets techniquement viables.
Les décisions d’infrastructure d’aujourd’hui façonnent notre capacité pour le futur
Tout cela signifie que nous devons planifier et construire de manière préventive l’infrastructure nécessaire aux futures avancées de l’IA. En effet, bien que les modèles se développent rapidement, la puissance requise pour les faire fonctionner dépend d’un type d’infrastructure qui prend du temps à être construite. Les raccordements au réseau peuvent prendre des années, et sur certains grands marchés de centres de données, les files d’attente s’étendent maintenant de sept à dix ans. Ainsi, si les villes augmentent leur puissance de calcul IA d’ici 2030, cette infrastructure électrique doit être mise en place dès maintenant. Chez Teravolt, notre modèle de travail estime la demande mondiale d’IA urbaine entre 9 et 18 GW d’ici 2036. Cela implique environ 1000 à 1500 sites urbains et métropolitains significatifs dans le monde, selon la taille moyenne des installations, et, au total, pourrait représenter un marché d’une valeur d’environ $500 billion à $1 trillion.
Si la planification nécessaire n’est pas effectuée, nous serons bloqués avec une capacité d’IA avancée que nous ne pourrons pas exploiter. L’ère du mobile a nécessité une infrastructure de tours pour la couverture radio afin de suivre les personnes ; sinon, le téléphone portable aurait été inutile. De même, nous devons reconnaître le décalage entre l’évolution de l’IA et l’installation de l’infrastructure électrique. Alors que l’ère du mobile mesurait la couverture en barres de signal, l’ère de l’IA la mesurera en millisecondes et en watts par habitant — et elle n’aura pas besoin de millions de tours, mais d’environ mille installations de la taille d’un poste de transformation. La fibre, les millisecondes et les mégawatts sont la monnaie de ce domaine, et ceux qui reconnaissent cette rareté à l’avance seront mieux placés pour façonner l’avenir.


