
Angle d’Anderson
Vers des humains générés par IA en temps réel grâce au rendu par lumigraphe neuronal

 Ajouter Unite.AI à vos sources préférées sur Google
Points clésLe rendu Neural Lumigraph (NLR) améliore NeRF d'environ deux ordres de grandeur.
Voir plus
- Le rendu Neural Lumigraph (NLR) améliore NeRF d'environ deux ordres de grandeur.
- NLR utilise les réseaux SIREN pour combiner les atouts de NeRF et d'IDR afin d'obtenir des graphismes en temps réel.
- NLR ne dispose pas de capacités d'éclairage dynamique ni de rééclairage, ce qui limite la sortie à l'éclairage au moment de la capture.
Malgré l’engouement actuel pour les champs de radiance neuronaux (NeRF), une technologie capable de créer des environnements et des objets 3D générés par IA, cette nouvelle approche de la synthèse d’images nécessite encore un temps d’entraînement considérable et ne dispose pas d’implémentation permettant de créer des interfaces très réactives en temps réel.
Toutefois, une collaboration entre plusieurs personnalités remarquables de l’industrie et du monde universitaire propose une nouvelle approche de ce défi, généralement désigné sous le nom de synthèse de nouveaux points de vue, ou NVS.
L’article de recherche, intitulé Rendu par lumigraphe neuronal, revendique une amélioration d’environ deux ordres de grandeur par rapport à l’état de l’art, ce qui représente plusieurs avancées vers le rendu infographique en temps réel au moyen de pipelines d’apprentissage automatique.

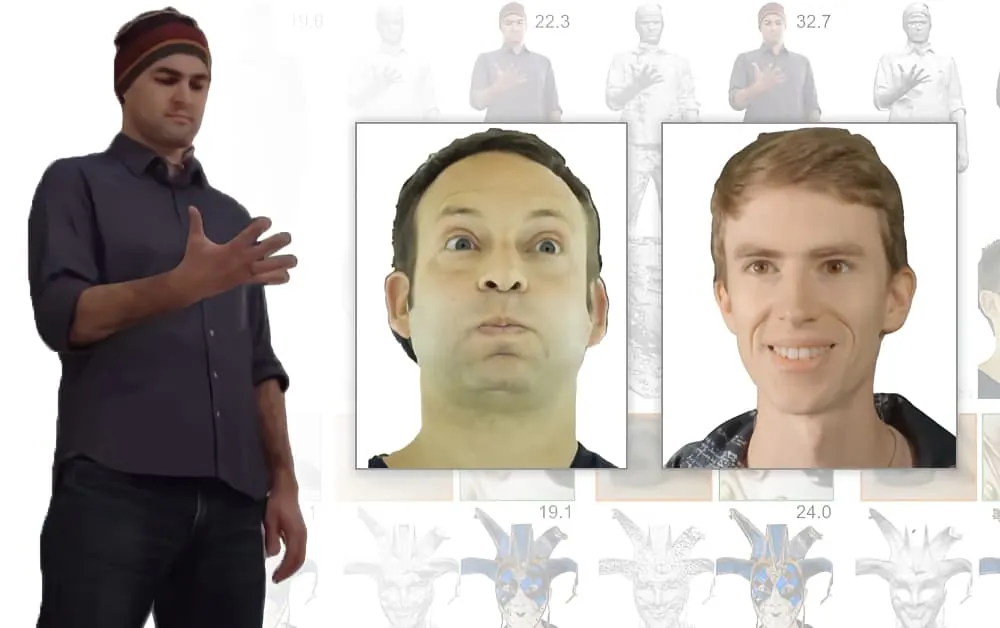
Le rendu par lumigraphe neuronal (à droite) offre une meilleure résolution des artefacts de fusion et une gestion améliorée de l’occultation par rapport aux méthodes précédentes. Source.
Bien que les crédits de l’article ne mentionnent que l’université Stanford et Raxium, une entreprise spécialisée dans les technologies d’affichage holographique qui opère actuellement en mode furtif, les contributeurs comprennent un architecte principal en apprentissage automatique chez Google et un informaticien chez Adobe (ADBE ), ainsi que le directeur technique de StoryFile, qui a récemment fait la une avec une version IA de William Shatner.
Au vu de la récente campagne médiatique autour de Shatner, StoryFile semble employer le NLR dans son nouveau processus de création d’entités interactives générées par IA, fondées sur les caractéristiques et les récits de personnes individuelles.
StoryFile envisage d’utiliser cette technologie dans des expositions muséales, des récits interactifs en ligne, des affichages holographiques, la réalité augmentée (RA) et la documentation du patrimoine. L’entreprise semble également étudier de nouvelles applications potentielles du NLR dans les entretiens de recrutement et les applications de rencontres virtuelles :

Utilisations proposées dans une vidéo en ligne de StoryFile.
Capture volumétrique pour les interfaces et les vidéos de synthèse de nouveaux points de vue
Dans les nombreux articles consacrés au sujet, le principe de la capture volumétrique consiste à prendre des images fixes ou des vidéos d’un sujet, puis à utiliser l’apprentissage automatique pour « compléter » les points de vue qui n’étaient pas couverts par le réseau initial de caméras.
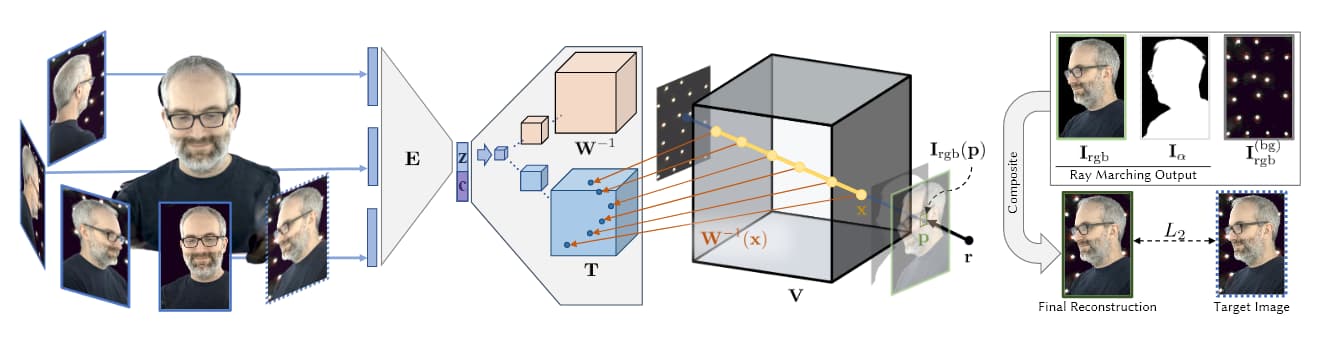
Source : https://research.fb.com/wp-content/uploads/2019/06/Neural-Volumes-Learning-Dynamic-Renderable-Volumes-from-Images.pdf
Dans l’image ci-dessus, tirée des recherches de Facebook sur l’IA en 2019 (voir ci-dessous), on distingue les quatre étapes de la capture volumétrique : plusieurs caméras recueillent des images ou des séquences vidéo ; une architecture encodeur-décodeur (ou d’autres architectures) calcule et concatène les relations entre les points de vue ; des algorithmes de lancer de rayons calculent les voxels (ou d’autres unités géométriques spatiales XYZ) de chaque point de l’espace volumétrique ; enfin, dans la plupart des articles les plus récents, un entraînement permet de synthétiser une entité complète, manipulable en temps réel.
Jusqu’à présent, cette phase d’entraînement, souvent longue et gourmande en données, a empêché la synthèse de nouveaux points de vue de permettre une capture en temps réel ou très réactive.
Comme la synthèse de nouveaux points de vue crée une carte 3D complète d’un espace volumétrique, il est relativement facile d’assembler ces points en un maillage informatique traditionnel, ce qui permet de capturer et d’animer à la volée un humain en images de synthèse (ou tout autre objet aux limites relativement bien définies).
Les approches fondées sur NeRF s’appuient sur des nuages de points et des cartes de profondeur pour générer les interpolations entre les points de vue épars des dispositifs de capture :
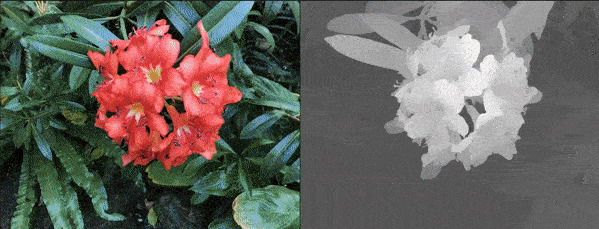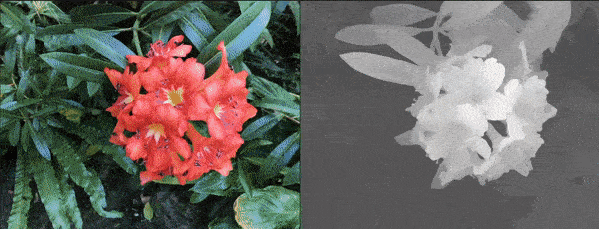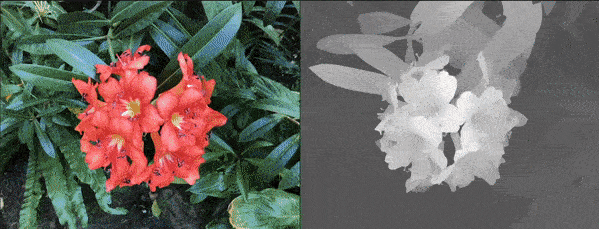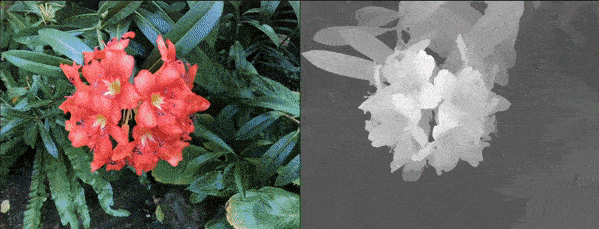
NeRF peut générer une profondeur volumétrique en calculant des cartes de profondeur plutôt qu’en générant des maillages infographiques. Source : https://www.youtube.com/watch?v=JuH79E8rdKc
Bien que NeRF soit capable de calculer des maillages, la plupart des implémentations n’exploitent pas cette possibilité pour générer des scènes volumétriques.
À l’inverse, l’approche du moteur de rendu différentiable implicite (IDR), publiée par le Weizmann Institute of Science en octobre 2020, repose sur l’exploitation des informations de maillage 3D générées automatiquement à partir des réseaux de caméras de capture :
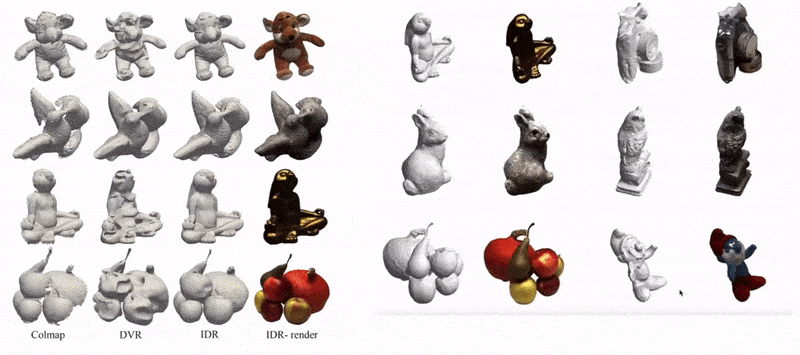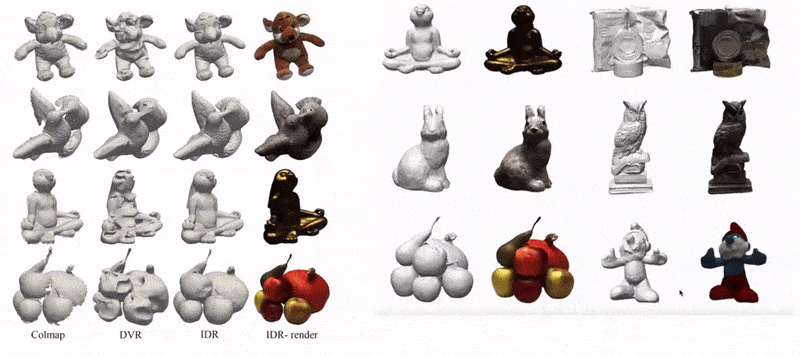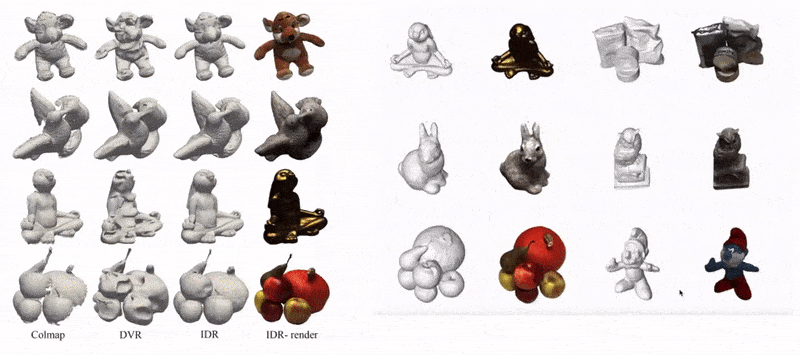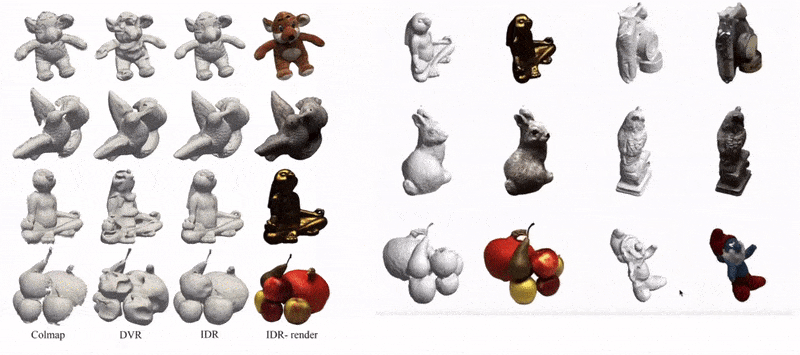
Exemples de captures IDR converties en maillages interactifs en images de synthèse. Source : https://www.youtube.com/watch?v=C55y7RhJ1fE
Bien que NeRF ne dispose pas de la capacité d’estimation de la forme d’IDR, IDR ne peut égaler la qualité d’image de NeRF, et les deux nécessitent d’importantes ressources pour l’entraînement et l’assemblage (même si des innovations récentes dans NeRF commencent à jeter les bases pour remédier à cette situation).

Dispositif de caméra personnalisé de NLR, composé de 16 GoPro HERO7 et de 6 caméras centrales Back-Bone H7PRO. Pour le rendu « en temps réel », celles-ci fonctionnent à une fréquence minimale de 60 images/s. Source : https://arxiv.org/pdf/2103.11571.pdf
Neural Lumigraph Rendering utilise plutôt SIREN (réseaux de représentation sinusoïdale) pour intégrer les points forts de chaque approche dans son propre cadre, conçu pour générer un résultat directement exploitable dans les pipelines graphiques en temps réel existants.
SIREN a été utilisé pour des applications similaires au cours de l’année écoulée et constitue désormais un appel d’API populaire dans les Colabs destinés aux amateurs des communautés de synthèse d’images. Toutefois, l’innovation de NLR consiste à appliquer les SIREN à la supervision d’images bidimensionnelles à vues multiples, ce qui pose problème, car SIREN produit dans une large mesure des résultats surajustés plutôt que généralisés.
Une fois le maillage CG extrait des images du réseau, il est rastérisé via OpenGL, puis les positions de ses sommets sont associées aux pixels correspondants, après quoi le mélange des différentes cartes contributrices est calculé.
Le maillage obtenu est plus généralisé et plus représentatif que celui de NeRF (voir l’image ci-dessous), nécessite moins de calculs et n’ajoute pas de détails excessifs aux zones qui ne peuvent en tirer parti (comme la peau lisse du visage) :

Source : https://arxiv.org/pdf/2103.11571.pdf
En revanche, NLR ne permet pas encore de gérer l’éclairage dynamique ni le rééclairage, et les résultats se limitent aux cartes d’ombres et aux autres paramètres d’éclairage obtenus au moment de la capture. Les chercheurs comptent remédier à cette limite dans leurs futurs travaux.
En outre, l’article reconnaît que les formes générées par NLR sont moins précises que celles obtenues avec certaines autres approches, comme Sélection de vues pixel par pixel pour la stéréo multivue non structurée, ou les travaux de recherche de l’Institut Weizmann mentionnés précédemment.
L’essor de la synthèse d’images volumétriques
L’idée de créer des entités 3D à partir d’un nombre limité de photos au moyen de réseaux neuronaux est antérieure à NeRF ; des articles visionnaires remontent à 2007, voire plus tôt. En 2019, le département de recherche en IA de Facebook a publié un article fondateur, Volumes neuronaux : apprendre à partir d’images des volumes dynamiques pouvant être rendus, qui a permis pour la première fois de créer des interfaces réactives pour des humains synthétiques générés par capture volumétrique fondée sur l’apprentissage automatique.
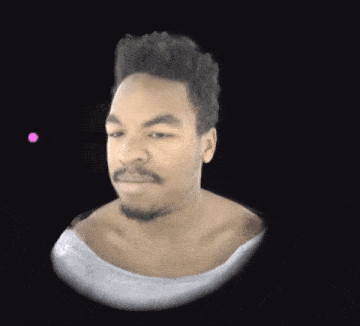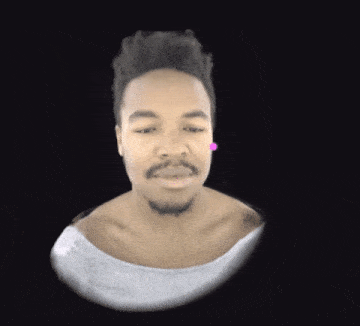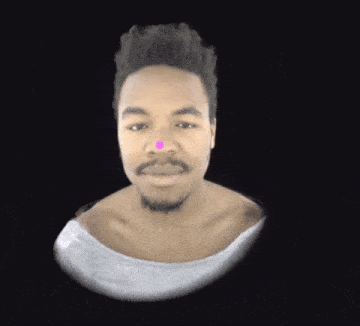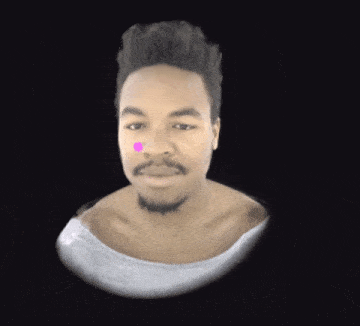
Les recherches de Facebook en 2019 ont permis de créer une interface utilisateur réactive pour une personne volumétrique. Source : https://research.fb.com/publications/neural-volumes-learning-dynamic-renderable-volumes-from-images/


