
Entretiens
Omri Geller, PDG et co-fondateur de Run:AI – Série d’entretiens

 Ajouter Unite.AI à vos sources préférées sur Google
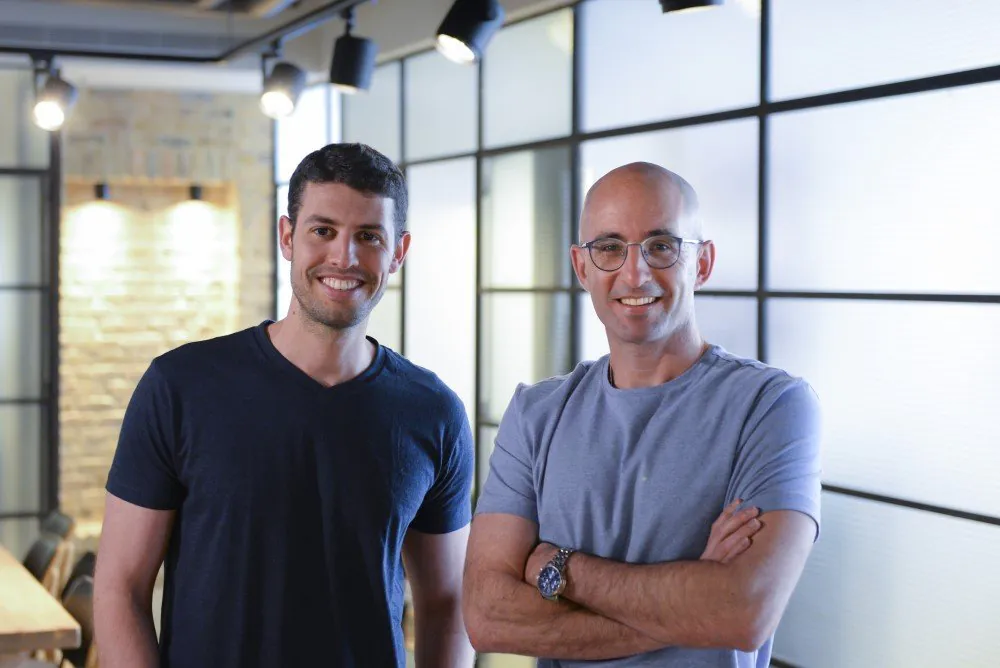
Omri Geller est le PDG et co-fondateur de Run:AI
Run:AI virtualise et accélère l’IA en regroupant les ressources de calcul GPU pour assurer la visibilité et, en fin de compte, le contrôle de la priorisation et de l’allocation des ressources. Cela garantit que les projets d’IA sont liés aux objectifs commerciaux et entraîne une amélioration significative de la productivité des équipes de science des données, leur permettant de construire et de former des modèles concurrents sans limitations de ressources.
Qu’est-ce qui vous a initialement attiré vers l’intelligence artificielle ?
Lorsque j’ai commencé mon bachelor en ingénierie électrique et électronique à l’Université de Tel-Aviv, j’ai découvert des choses fascinantes sur l’IA que je savais aideraient à faire un progrès dans les possibilités de calcul. À partir de là, je savais que je voulais m’investir dans l’espace de l’IA. Que ce soit dans la recherche en IA, ou en ouvrant une entreprise qui aiderait à introduire de nouvelles façons d’appliquer l’IA au monde.
Avez-vous toujours eu un intérêt pour le matériel informatique ?
Lorsque j’ai reçu mon premier ordinateur avec un processeur Intel (INTC ) 486 à six ou sept ans, j’étais immédiatement intéressé pour comprendre comment tout fonctionnait, même si j’étais probablement trop jeune pour vraiment le comprendre. En dehors des sports, les ordinateurs sont devenus l’un de mes plus grands hobbies en grandissant. Depuis, j’ai construit des ordinateurs, travaillé avec eux, et j’ai poursuivi des études dans le domaine en raison de la passion que j’avais enfant.
Quelle a été votre inspiration derrière le lancement de Run:AI ?
Je savais dès le début que je voulais m’investir dans l’espace de l’IA. Au cours des dernières années, l’industrie a connu une croissance considérable dans l’IA, et une grande partie de cette croissance est venue des informaticiens, comme moi, et du matériel qui pouvait supporter plus d’applications. Il est devenu clair pour moi que je finirais par créer une entreprise – et avec mon co-fondateur Ronen Dar – pour continuer à innover et aider à apporter l’IA à plus d’entreprises.
Run:AI permet aux spécialistes du machine learning de gagner un nouveau type de contrôle sur l’allocation de ressources GPU coûteuses. Pouvez-vous expliquer comment cela fonctionne ?
Ce que nous devons comprendre, c’est que les ingénieurs en machine learning, comme les chercheurs et les scientifiques des données, ont besoin de consommer de la puissance de calcul de manière flexible. Non seulement les calculs les plus récents sont très intensifs en calcul, mais il y a également de nouveaux flux de travail qui sont utilisés dans la science des données. Ces flux de travail sont basés sur le fait que la science des données est basée sur l’expérimentation et la réalisation d’expériences.
Afin de développer de nouvelles solutions pour exécuter des expériences plus efficaces, nous devons étudier ces tendances de flux de travail au fil du temps. Par exemple : un scientifique des données utilise huit GPU un jour, mais le lendemain, il n’en utilise peut-être aucun, ou il peut en utiliser un pendant une longue période, mais ensuite avoir besoin d’en utiliser 100 parce qu’il veut exécuter 100 expériences en parallèle. Une fois que nous comprenons ce flux de travail pour optimiser la puissance de calcul d’un utilisateur, nous pouvons commencer à le mettre à l’échelle pour plusieurs utilisateurs.
Avec l’informatique traditionnelle, un nombre spécifique de GPU est alloué à chaque utilisateur, sans tenir compte de leur utilisation ou non. Avec cette méthode, les GPU coûteux restent souvent inactifs sans que personne d’autre ne puisse y accéder, ce qui entraîne un faible retour sur investissement pour le GPU. Nous comprenons les priorités financières d’une entreprise et offrons des solutions qui permettent l’allocation dynamique de ces ressources en fonction des besoins des utilisateurs. En offrant un système flexible, nous pouvons allouer une puissance supplémentaire à un utilisateur spécifique lorsqu’il est nécessaire, en utilisant les GPU non utilisés par d’autres utilisateurs, créant ainsi un retour sur investissement maximum pour les ressources de calcul d’une entreprise et accélérant l’innovation et le temps de mise sur le marché des solutions d’IA.
L’une des fonctionnalités de Run:AI est qu’elle permet la réduction des angles morts créés par l’allocation statique de GPU. Comment cela est-il réalisé ?
Nous avons un outil qui nous donne une visibilité complète sur le cluster de ressources. En utilisant cet outil, nous pouvons observer et comprendre s’il y a des angles morts, puis utiliser ces GPU inactifs pour les utilisateurs qui ont besoin d’une allocation. Le même outil qui fournit une visibilité sur le cluster et le contrôle sur le cluster garantit également que ces angles morts sont atténués.
Dans un discours récent, vous avez souligné certaines distinctions entre les flux de travail de construction et de formation, pouvez-vous expliquer comment Run:AI utilise un mécanisme de gestion de file d’attente de GPU pour allouer la gestion des ressources pour les deux ?
Un modèle d’IA est construit en deux étapes. La première est l’étape de construction, où un scientifique des données écrit le code pour construire le modèle lui-même, de la même manière qu’un ingénieur construirait une voiture. La deuxième est l’étape de formation, où le modèle terminé commence à apprendre et à être « formé » pour optimiser une tâche spécifique. De la même manière qu’une personne apprend à conduire une voiture après qu’elle ait été assemblée.
Pour construire le modèle lui-même, peu de puissance de calcul est nécessaire. Cependant, plus tard, il pourrait avoir besoin d’une puissance de traitement plus forte pour commencer des tests internes plus petits. Par exemple, de la même manière qu’un ingénieur voudrait finalement tester le moteur avant de l’installer. En raison de ces besoins distincts au cours de chaque étape, Run.AI permet l’allocation de GPU indépendamment du fait qu’ils soient en construction ou en formation du modèle, cependant, comme mentionné plus tôt, une utilisation plus élevée de GPU est généralement requise pour la formation du modèle tandis que moins est requis pour sa construction.
Combien de temps de calcul brut/ressources peut être économisé par les développeurs d’IA qui souhaitent intégrer Run.AI dans leurs systèmes ?
Nos solutions chez Run.ai peuvent améliorer la numérisation des ressources, d’environ deux à trois fois, ce qui signifie 2-3 fois meilleure productivité globale.
Je vous remercie pour l’entretien, les lecteurs qui souhaitent en savoir plus peuvent visiter Run:AI.


