
Entretiens
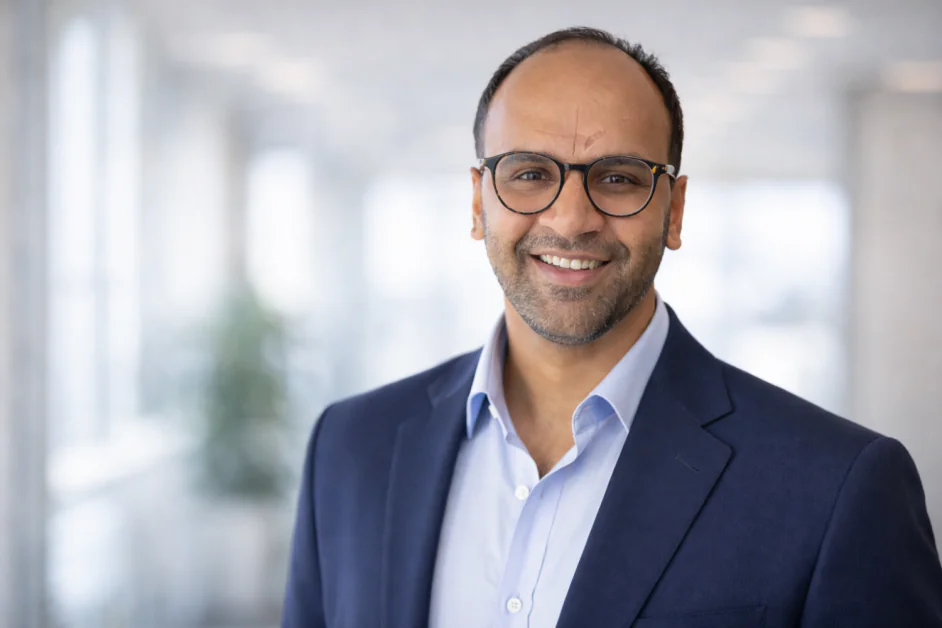
Nikunj Bajaj, cofondateur et PDG de TrueFoundry – Série d’entretiens

 Ajouter Unite.AI à vos sources préférées sur Google
Avant de fonder TrueFoundry, vous avez travaillé dans la recherche en apprentissage automatique, sur l’IA en production chez Facebook (META ) et sur les systèmes de recommandation à grande échelle. Quelles expériences vous ont le plus directement poussé à créer une entreprise d’infrastructure d’IA destinée aux entreprises, et quel problème vous semblait encore non résolu à l’époque ?
Chez Meta, nous considérions l’apprentissage automatique comme un cas particulier du logiciel, et l’IA générative comme un cas particulier de l’apprentissage automatique. Cela donnait une pile technologique verticale avec le logiciel à la base, l’apprentissage automatique au milieu et l’IA générative au sommet. Dans cette configuration, les modèles que je crée en tant que développeur en apprentissage automatique suivent le même schéma de déploiement que le reste du logiciel, ce qui rend le passage à l’échelle des systèmes très simple.
La plupart des entreprises déployaient toutefois des piles parallèles, c’est-à-dire des piles distinctes pour le logiciel, l’apprentissage automatique et l’IA générative. Avec ces piles parallèles, le passage à l’échelle devient plus complexe en raison des transferts de travail nécessaires entre l’apprentissage automatique et le monde du logiciel.
Notre équipe a toujours travaillé à la jonction entre la création de modèles d’apprentissage automatique et l’infrastructure correspondante. Ce point de vue singulier nous a permis de voir que nous pouvions introduire des piles verticales similaires dans les entreprises et les adapter à leurs exigences spécifiques. Vers la fin de 2021, nous avions aussi formulé l’hypothèse que l’apprentissage automatique approchait d’un point d’inflexion. Lorsqu’il serait atteint, davantage d’entreprises auraient besoin d’une pile intégrée verticalement pour déployer et faire évoluer ces systèmes efficacement. C’est ce qui nous a finalement amenés à fonder TrueFoundry, et notre hypothèse s’est révélée juste. L’adoption de l’IA s’est accélérée après le lancement de ChatGPT à la fin de 2022.
À mesure que les systèmes d’IA passent de l’expérimentation aux activités quotidiennes, qu’est-ce qui a changé dans la manière dont les organisations devraient envisager la fiabilité et les défaillances ?
Les enjeux de l’IA générative sont nettement plus élevés que ceux des systèmes traditionnels d’apprentissage automatique. Quand ces systèmes passent en production, les organisations doivent composer avec beaucoup plus d’ambiguïté et de non-déterminisme, car les LLM sont stochastiques par nature. Les systèmes d’agents construits sur cette base ajoutent encore de l’ambiguïté.
De plus, les défaillances ne sont plus binaires. Il ne s’agit plus simplement de savoir si un système fonctionne ou non : de nombreux problèmes se manifestent sous forme de défaillances partielles ou de dégradations silencieuses. Avec le temps, les systèmes peuvent répondre avec une latence accrue, une qualité moindre ou un comportement incorrect. Dans bien des cas, ces dégradations sont plus difficiles à détecter et parfois même plus dommageables qu’une interruption complète.
Les organisations doivent envisager la fiabilité non seulement sous l’angle du temps de fonctionnement, mais aussi de la dégradation des performances au fil du temps.
TrueFailover a été lancé au milieu d’une vague d’interruptions très médiatisées de services cloud et d’IA. Quels événements récents ont clairement montré que la fiabilité de l’IA était passée d’un complément souhaitable à une exigence architecturale fondamentale ?
L’un de nos clients du secteur de la santé traite en temps réel des demandes de patients liées aux ordonnances, pour lesquelles une réponse rapide est essentielle. Il a subi une interruption provoquée par la défaillance d’un modèle. Ses flux de travail génèrent des milliers de dollars de chiffre d’affaires par seconde, et l’interruption a perturbé certains de ces flux critiques. Ce client comptait parmi les premiers utilisateurs de TrueFailover ; nous avons donc pu l’aider à rétablir rapidement le fonctionnement et à contenir les conséquences.
De tels incidents soulèvent une question importante : alors que les enjeux des systèmes d’IA générative ne cessent de croître, pourquoi les processus de rétablissement restent-ils en grande partie manuels ? Cela a renforcé l’idée qu’il faut construire les systèmes en partant du principe que des défaillances surviendront, et les concevoir pour qu’ils se corrigent automatiquement. La fiabilité doit aussi être intégrée à la pile d’IA elle-même, grâce à des passerelles d’IA capables de fournir un routage centralisé, de l’observabilité, des garde-fous et un changement intelligent de modèle entre différents fournisseurs.
De nombreuses interruptions de l’IA sont encore présentées comme de petits incidents techniques. Où voyez-vous les véritables coûts économiques et humains commencer à apparaître lorsque les systèmes d’IA cessent de fonctionner ?
L’IA en entreprise a suffisamment évolué pour que ces incidents ne touchent plus uniquement les flux de travail internes. Aujourd’hui, les interruptions et les dégradations affectent directement et immédiatement la perception du public et les bénéfices, car les applications en production servent désormais les clients. Ce passage des tests internes à des applications destinées au public, où les enjeux sont importants, explique le besoin croissant d’attention et de supervision de la part de la direction générale.
À mesure que les systèmes d’IA s’intègrent plus profondément dans les flux de travail opérationnels, les interruptions ne sont plus seulement des problèmes techniques. Elles ont de plus en plus de conséquences directes pour l’activité, les clients et la réputation.
Dans des environnements critiques comme les pharmacies, les services de santé ou l’assistance client, à quelle vitesse une indisponibilité de l’IA peut-elle devenir un risque opérationnel ou réputationnel ?
Dans les environnements critiques, l’escalade est presque immédiate, car ces systèmes prennent en charge des flux de travail en temps réel qui exigent un traitement dans les délais. Même une brève interruption peut arrêter des processus critiques, retarder la prestation de services ou interrompre des systèmes en aval dépendant de ces résultats, créant des effets opérationnels en cascade dans toute l’organisation.
Dans des secteurs comme la santé, les conséquences dépassent la perturbation opérationnelle et touchent aussi l’expérience client et les résultats des services. Si un patient ne peut pas obtenir à temps les médicaments prescrits, cela peut avoir des conséquences réelles. Ce n’est pas seulement un problème pour le patient : la réputation de la pharmacie ou du prestataire de soins peut aussi en pâtir. Dans les environnements critiques où la confiance compte, il est primordial que les systèmes restent en ligne. C’est pourquoi les organisations reconnaissent de plus en plus que les systèmes d’IA doivent être conçus en partant du principe que des défaillances surviendront et que les mécanismes de rétablissement doivent s’activer automatiquement pour réduire les risques au minimum.
Vous avez dit que de nombreuses équipes conçoivent leur architecture pour les capacités plutôt que pour la continuité. Pourquoi la résilience a-t-elle historiquement reçu une priorité moindre dans la conception des systèmes d’IA ?
Cela tient surtout aux incitations au sein des organisations. Les nouvelles capacités sont visibles et suscitent l’enthousiasme. Elles ouvrent la voie à des démonstrations, des fonctionnalités et de nouvelles possibilités pour le produit, que la direction peut voir immédiatement.
La continuité est, par définition, invisible lorsque tout fonctionne bien. Les systèmes de récompense tendent donc à favoriser le lancement de nouvelles fonctionnalités plutôt que la garantie que rien ne tombe en panne. En conséquence, les organisations investissent souvent de manière disproportionnée dans le développement des capacités par rapport à l’ingénierie de la résilience.
Avec la dépendance croissante des entreprises aux modèles et aux API externes, quelles nouvelles fragilités apparaissent dans la pile d’IA dont les dirigeants ne mesurent peut-être pas encore pleinement l’importance ?
Les LLM sont fondamentalement des ressources partagées, et les entreprises ne les possèdent pas comme elles possèdent une infrastructure traditionnelle. En outre, des systèmes importants et critiques pour leur activité fonctionnent sur des systèmes externes qui n’ont pas encore pleinement fait leurs preuves dans la durée. Les LLM eux-mêmes évoluent rapidement : on ne peut donc pas tenir un fournisseur de modèle responsable de facteurs comme la latence ou une légère baisse des performances du modèle, car il procède très vite à de nouvelles itérations de ses recherches.
Comme les LLM sont des ressources partagées, la latence peut augmenter brusquement lorsqu’un autre utilisateur effectue une action précise. La nature même des LLM introduit de nombreux points de défaillance de ce type, et les entreprises n’ont tout simplement pas le contrôle total dans ce nouveau monde. Sans contrôle total, le mieux qu’une entreprise puisse faire est de prévoir suffisamment de redondance dans le système pour concevoir une solution résiliente.
Sans nous concentrer sur des produits particuliers, comment les organisations devraient-elles repenser l’architecture d’IA pour présupposer les défaillances, au lieu de traiter les interruptions comme de rares cas limites ?
Les organisations devraient revenir aux principes fondamentaux de la conception des systèmes distribués. Les systèmes logiciels ont été construits en supposant que les composants réseau et les machines tomberaient en panne, et qu’une région entière pourrait cesser de fonctionner.
Les systèmes d’IA ne devraient pas faire exception. Nous devrions supposer que les fournisseurs de modèles connaîtront des problèmes de latence, des dégradations ou des interruptions, et intégrer de la redondance afin que les applications restent résilientes dans différents scénarios de défaillance.
Vous attendez-vous à ce que la résilience de l’IA devienne un facteur décisif dans le choix d’une plateforme et d’un fournisseur, comme le temps de fonctionnement et la redondance ont influencé les décisions d’infrastructure cloud ?
À mesure que davantage de systèmes d’IA passent en production, la résilience deviendra une exigence minimale. Si un fournisseur ne peut pas présenter de graphiques et de mesures sur le temps de fonctionnement et la résilience globale, il ne sera même pas envisagé. Lorsque la résilience sera une attente de base envers tous les fournisseurs, les facteurs décisifs se déplaceront vers l’expérience utilisateur, l’optimisation des performances, l’observabilité et les capacités du produit de niveau supérieur. Avec le temps, des composants comme une passerelle d’IA et des fonctions de basculement automatique deviendront des éléments fondamentaux de l’infrastructure d’IA des entreprises.
À l’avenir, que signifiera vraiment une IA « prête pour la production » dans un monde où l’on attend d’elle une disponibilité continue, et pas seulement une utilité occasionnelle ?
Les systèmes d’IA prêts pour la production devraient être observables, contrôlables et pouvoir être rétablis après une panne. Ces trois exigences doivent être satisfaites.
Pour que l’IA en production soit observable, les équipes ont besoin d’une visibilité approfondie sur le comportement des modèles, la latence, les taux d’erreur, l’utilisation des tokens, la dérive et les schémas de défaillance. Sans une forte observabilité, il devient très difficile de détecter les dégradations avant que les utilisateurs commencent à les remarquer.
La contrôlabilité des systèmes comprend la régulation du trafic, la limitation du débit de requêtes, les garde-fous, l’application des politiques et le routage intelligent entre modèles et fournisseurs. Une passerelle d’IA devient ici fondamentale : elle agit comme un plan de contrôle centralisé qui applique les garde-fous, assure une gouvernance cohérente et permet de changer dynamiquement de modèle lorsque les performances ou la fiabilité baissent.
Enfin, pour permettre le rétablissement, les systèmes devraient être construits en supposant que des composants puissent être partiellement ou totalement hors service, à cause d’interruptions chez les fournisseurs, d’une qualité de modèle dégradée, de limites du débit de requêtes ou d’entrées inattendues provenant d’acteurs malveillants. Le basculement automatique et les mécanismes d’autoréparation devraient être intégrés à l’architecture, plutôt que dépendre de procédures manuelles déclenchées après l’apparition d’un problème.
C’est la direction que nous prenons chez TrueFoundry. Les fournisseurs qui définissent ainsi la préparation à la production, en associant observabilité, contrôle centralisé et rétablissement automatique, gagneront la confiance des clients à long terme et pourront continuer à résoudre de nouveaux problèmes au fur et à mesure de leur apparition.
Merci pour cet excellent entretien. Les lecteurs qui souhaitent en savoir plus peuvent consulter TrueFoundry.


