
Entretiens
Fabiana Clemente, co-fondatrice et directrice des données chez YData – Série d’entretiens

 Ajouter Unite.AI à vos sources préférées sur Google
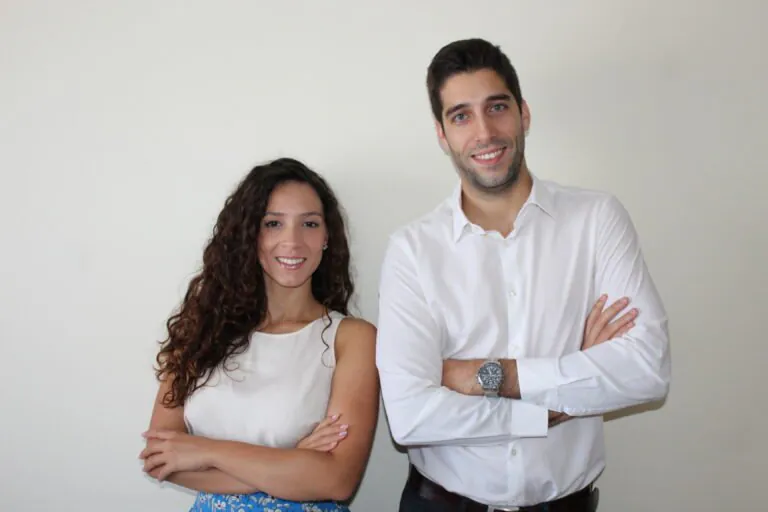
Fabiana Clemente est la co-fondatrice et la directrice des données chez YData. YData est une startup d’IA qui a créé la première solution de développement centrée sur les données pour combiner la découverte, l’amélioration et la mise à l’échelle des données en une seule plateforme.
Qu’est-ce qui vous a initialement attiré vers l’IA et l’apprentissage automatique ?
Mon background est en mathématiques appliquées, où j’ai eu l’opportunité d’apprendre et de comprendre comment extraire des informations à partir des données ainsi que de le faire en utilisant du code. À l’époque, ce n’était pas aussi « sexy » que l’apprentissage automatique, mais c’est définitivement ce qui a allumé ma passion pour le domaine.
Pouvez-vous partager l’histoire de la création de YData ?
En tant que scientifique des données ayant travaillé pour des startups et des entreprises, j’ai eu ma part de luttes – parfois, l’accès aux données était bloqué sous prétexte de sécurité ou de confidentialité, d’autres fois, l’accès était facile, mais la qualité des données n’était pas même proche de ce dont j’avais besoin pour construire des solutions basées sur l’IA. Sachant que ces luttes sont très fréquentes dans la plupart des organisations, cela nous a inspirés pour créer l’entreprise avec l’objectif d’aider ces équipes à surmonter ces obstacles en accélérant leur développement d’IA avec des données améliorées.
Pouvez-vous décrire pour notre audience ce qu’est la donnée synthétique ?
Les données synthétiques sont considérées comme toutes les données qui n’ont pas été générées dans le monde réel, donc, toutes les données créées artificiellement. Il existe des méthodes qui permettent la génération de données synthétiques – allant des stratégies basées sur des règles jusqu’à l’utilisation de modèles d’apprentissage automatique ou de deep learning pour apprendre ces « règles » pour nous. Chez YData, nous avons adopté et nous sommes spécialisés dans une stratégie basée sur le deep learning pour générer de nouvelles données qui conservent le comportement des événements du monde réel sans préoccupations autour de la confidentialité.
Qu’est-ce qui rend les données synthétiques si importantes ?
Plus les organisations réalisent l’importance des données pour stimuler leurs entreprises, plus l’importance et le rôle des données synthétiques seront compris. La collecte de données réelles n’est pas seulement chronophage et coûteuse, mais parfois, impossible. Pour construire des applications d’IA, les données sont une exigence difficile à remplir – c’est là que les données synthétiques viennent à la rescousse. La capacité de générer des scénarios non vus ou de simplement débloquer l’accès aux données est clé pour évoluer dans un monde où les pionniers, comme Andrew Ng, affirment que devenir centré sur les données est clé pour une adoption réussie de l’IA.
Dans les voitures autonomes ou d’autres activités d’automatisation des machines, on peut déjà percevoir l’importance des données synthétiques, donc je dirais que c’est tout à fait naturel que cette compréhension se propage à travers tous les secteurs verticaux.
Comment YData génère-t-elle des données synthétiques ?
YData s’appuie principalement sur des modèles de génération profonds pour apprendre les attributs statistiques et les corrélations entre les variables des données originales. Cela permet au modèle de générer un ensemble de données statistiquement pertinent qui a la même valeur commerciale que l’original, sans permettre la traçabilité des enregistrements originaux.
YData pousse cette technologie plus loin et est la société derrière la Communauté des données synthétiques – un groupe d’experts en science des données engagés à évangéliser et à aider quiconque qui souhaite apprendre et utiliser cette technologie.
Comment la plateforme YData aide-t-elle à découvrir et à débloquer de nouvelles sources de données ?
La plateforme YData inclut des connecteurs intégrés pour tout type de base de données, d’entrepôt de données ou de lac de données, ce qui permet aux utilisateurs d’accéder facilement aux métadonnées pertinentes et de comprendre si les données existantes sont utiles pour répondre à la question commerciale qu’ils ont en tête – sans même regarder les enregistrements réels.
Pouvez-vous partager des détails sur la communauté open source de données synthétiques ?
Les données synthétiques ne sont qu’à leurs débuts et, pour cette raison, la conscience de la façon dont elles sont générées, de leurs avantages ou de leurs limites est encore quelque peu inconnue pour un public plus large. Pour cette raison, chez YData, nous avons décidé de prendre une route plus éducative en créant la communauté de données synthétiques – outre être un lieu d’échange d’idées ou pour obtenir de l’aide d’experts dans le domaine des données synthétiques, c’est également un lieu où les scientifiques des données et d’autres profils techniques peuvent commencer leur parcours dans les données synthétiques, avec certaines des algorithmes les plus intéressants de la littérature.
De plus, nous offrons également une perspective sur la qualité des données, afin que les scientifiques des données puissent d’abord comprendre les données avec lesquelles ils travaillent, avant de les synthétiser ou d’améliorer la synthèse des données. Nous sommes vraiment engagés à aider les équipes de données à devenir de plus en plus centrées sur les données.
YData a récemment annoncé 2,7 millions de dollars de financement pour accélérer son expansion internationale. Pouvez-vous partager des détails sur ce que cela signifie pour l’avenir de l’entreprise et sa stratégie d’expansion ?
YData est née internationale dès le départ – nous savions que ce type de technologie nécessite des premiers utilisateurs qui sont généralement dans les pays les plus sophistiqués. Pour cette raison, nos premiers clients étaient déjà en dehors du Portugal, partout en Europe, et nous établissons maintenant une présence en Amérique du Nord également. Ce financement nous permettra de renforcer notre présence sur ces deux continents, non seulement sur le plan commercial, mais également pour faire grandir l’équipe : nous sommes une équipe entièrement distribuée, ce qui nous permet d’embaucher les meilleurs talents, où qu’ils soient.
Y a-t-il autre chose que vous aimeriez partager sur YData ?
YData pousse les limites de l’IA centrée sur les données et crée une nouvelle catégorie : DataPrepOps – bien que ce soit un nom laid, c’est une douleur que la plupart des entreprises rencontrent actuellement lorsqu’il s’agit du développement de la science des données. La tendance de la qualité des données continue de croître et, après les pipelines de données et l’observabilité des données, la qualité des données pour les équipes de science des données est encore dans ses débuts, et YData émerge comme un leader de pensée dans la préparation des données.
Merci pour cette grande interview, les lecteurs qui souhaitent en savoir plus devraient visiter YData.


