
Entretiens
Ben Koska, fondateur et PDG de SF Tensor – Série d’entretiens

 Ajouter Unite.AI à vos sources préférées sur Google
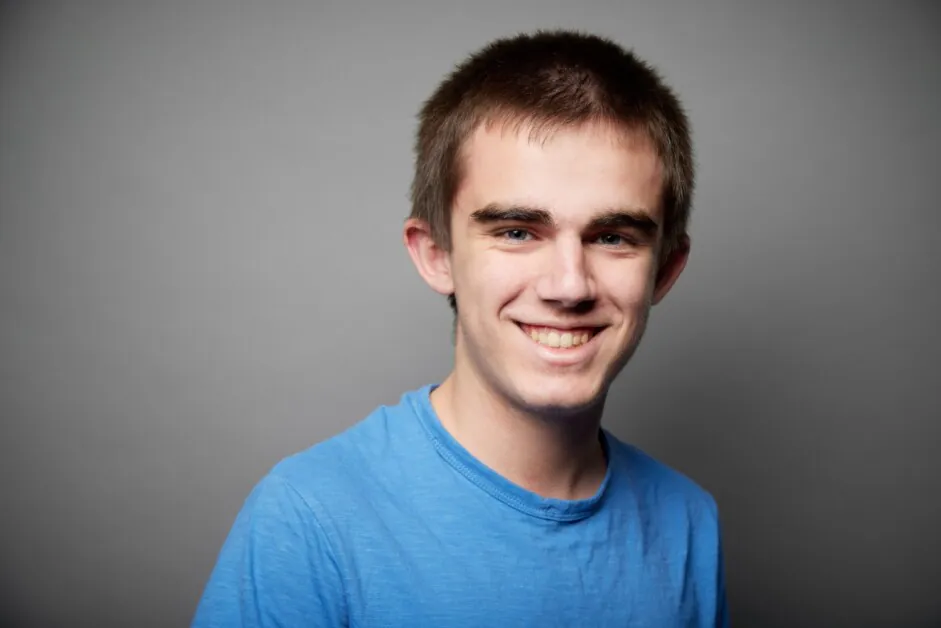
Ben Koska, fondateur et PDG de SF Tensor, est un chercheur en intelligence artificielle et un ingénieur système connu pour son travail sur le calcul haute performance, l’optimisation du noyau et la formation de modèles efficaces. Son expérience couvre le développement d’infrastructures d’intelligence artificielle de bas niveau, l’amélioration du débit de formation et la conception d’outils qui rendent le développement de modèles avancés accessible sans surcoût d’ingénierie. Il se concentre sur la construction de systèmes qui poussent les limites de la vitesse, de la portabilité et de la fiabilité sur des matériels hétérogènes.
SF Tensor est l’entreprise qu’il dirige pour transformer cette philosophie en une plate-forme pratique. Elle introduit un modèle de programmation unifié, un optimiseur de noyau et une couche d’orchestration cross-cloud conçue pour éliminer la complexité des charges de travail d’intelligence artificielle distribuée. La plate-forme vise à offrir aux ingénieurs un environnement propre et indépendant du matériel où ils peuvent écrire une fois, déployer partout et atteindre automatiquement de hautes performances. La mission de SF Tensor est de rendre le calcul d’intelligence artificielle dramatiquement plus rapide, plus facile à gérer et libre de verrouillage de fournisseur.
Vous avez fondé SF Tensor à l’âge de 19 ans, après avoir déjà dirigé l’ingénierie dans plusieurs startups. Qu’est-ce qui vous a inspiré à relever le défi de réinventer l’infrastructure d’intelligence artificielle si tôt dans votre carrière ?
Le problème que nous résolvons est celui que je me suis posé moi-même. Lorsque nous avons développé ce qui est maintenant la pile principale de SF Tensor, nous ne travaillions pas sur un projet commercial, c’était en fait un projet universitaire. Nous avions reçu une subvention pour mener une recherche intéressante, mais nous avons passé la majeure partie de notre temps à nous battre contre l’infrastructure et les optimisations, au lieu de faire de la recherche. Nous avons constaté que les gens étaient universellement plus intéressés par notre technologie d’infrastructure que par notre projet de recherche.
SF Tensor s’attaque à l’un des problèmes les plus difficiles de l’intelligence artificielle — briser la domination de CUDA de NVIDIA. Comment avez-vous abordé la conception d’un système capable d’atteindre une véritable portabilité du matériel sans compromettre les performances ?
À la fin de la journée, toute l’intelligence artificielle se résume à des mathématiques simples. Chaque modèle est essentiellement un ensemble d’opérations mathématiques que nous devons calculer pour obtenir les résultats. En traitant cela principalement comme un problème mathématique plutôt que comme un problème d’informatique, nous pouvons identifier l’ensemble le plus petit de contraintes sur les calculs, puis générer des millions à des milliards de façons différentes de transformer ces calculs en code machine, en trouvant le plus rapide. C’est plus facile à dire qu’à faire, car nous ne pouvons pas réellement exécuter des milliards de programmes différents pour trouver le plus rapide, nous devons donc élaguer notre espace de recherche pour créer un modèle mathématique précis pour estimer la vitesse d’un programme donné pour un matériel donné, ce qui est l’une des innovations clés qui rendent possible ce que nous faisons aujourd’hui.
Le blog de l’entreprise met en évidence les innovations autour de l’optimisation du compilateur et de l’orchestration cross-cloud. Pouvez-vous expliquer comment l’approche de SF Tensor diffère des cadres existants comme PyTorch ou JAX ?
Nous n’avons pas encore écrit un blog technique à ce sujet, mais nous soutenons en fait des cadres comme PyTorch et JAX, en permettant au code écrit dans ces langages d’être optimisé par notre pile. Il y a plusieurs décisions architecturales que JAX et PyTorch ont prises qui les différencient de notre pile, mais la plus importante est que nous traitons l’ensemble du modèle comme un seul calcul à résoudre, au lieu de modules individuels qui doivent être optimisés individuellement puis conjointement. À cette fin, au lieu d’appliquer des techniques d’optimisation de compilateur traditionnelles et d’essayer d’appliquer chaque optimisation individuelle, nous créons un espace de recherche de millions à parfois des milliards de noyaux potentiels et affirmons qu’aucun humain ne peut concevoir un ensemble de règles pour transformer n’importe quel code en le plus rapide, nous devons donc simplement créer toutes les combinaisons et identifier le plus rapide.
De nombreuses startups se concentrent sur l’efficacité de la formation, mais vous avez souligné la « taxe d’infrastructure » — le temps que les chercheurs perdent à gérer le calcul au lieu d’innover. Comment SF Tensor traite-t-il ce déséquilibre ?
Nous croyons que les deux problèmes doivent être abordés, et une grande partie de notre travail va à l’optimisation de la formation, mais le problème le plus aigu que nous pouvons résoudre actuellement sans être conditionné par des innovations futures est la taxe d’infrastructure, car c’est un problème que nous avons déjà résolu pour nous-mêmes.
Vous avez mentionné des réductions de coûts de formation allant jusqu’à 80 %. Quelles sont les optimisations ou les avancées architecturales spécifiques qui rendent cela possible ?
Notre ensemble de logiciels est construit sur l’idée qu’un compilateur basé sur la recherche battra toujours les règles créées par l’homme. Jusqu’à présent, la plus grande contrainte de ces compilateurs a été le fait qu’il n’est pas possible de benchmark et de classer des millions ou même des milliards de noyaux. Il a donc fallu que nous créions un modèle mathématique de calcul qui puisse estimer avec précision le temps que prendra un calcul donné, ou un ensemble de calculs, sur un matériel donné. En faisant cela, nous pouvons élargir notre espace de recherche, puis le réduire, ce qui est une nécessité si l’on veut trouver les noyaux les plus rapides de manière cohérente.
Comment votre expérience dans la création du langage de programmation Emma influence-t-elle l’architecture et la philosophie de SF Tensor en matière de performances et d’abstraction ?
N’en dites rien à mes investisseurs, mais au fond, je suis toujours un ingénieur de compilateur. J’ai toujours été intéressé par la recherche de différentes manières de rendre les choses même légèrement plus rapides. En développant Emma, nous avons jeté le compilateur entier 4 ou 5 fois ; nous avons commencé à zéro, chaque fois parce que nous sommes tombés sur une optimisation que nous ne pouvions pas implémenter étant donné les contraintes actuelles, nous avons donc dû réingénier le système pour qu’il soit encore plus général, tout en nous permettant de descendre au niveau le plus bas d’optimisation lorsque cela est nécessaire, souvent en allant à l’encontre des principes courants de conception de compilateurs et de langages. Ces apprentissages et l’architecture qui en résulte, combinés à près de deux ans d’optimisations mineures et de mauvais paris, ont abouti à un système qui nous permet désormais d’itérer plus rapidement et d’optimiser mieux que les systèmes qui ont suivi les principes courants, car ces principes sont fondamentalement conçus pour les CPU, et non pour les GPU et les modèles d’intelligence artificielle.
Vous avez travaillé sur des exécutions d’entraînement à grande échelle sur 4 000 GPU et plus — quels ont été les plus grands enseignements tirés de la gestion du calcul à cette échelle ?
Un grand enseignement est que les défaillances matérielles sont beaucoup plus fréquentes et plus problématiques qu’on ne le suppose. Ayant passé beaucoup de temps à travailler avec des programmes traditionnels et des compilateurs, généralement, un ordinateur fait exactement ce qu’on lui dit, et si quelque chose se passe mal, c’est presque toujours la faute de la personne qui a écrit le code. Avec les GPU, en revanche, les défaillances matérielles sont fréquentes, surtout dans les formations distribuées sur des grappes extrêmement grandes. Cela va de pair avec le fait que, contrairement aux CPU qui agissent généralement de manière déterministe et prévisible, les GPU feront parfois des choses inexplicables, comme réduire les vitesses d’horloge sans raison apparente, ralentissant l’ensemble du processus de formation parce qu’un seul circuit est en train de fonctionner plus lentement.
Y Combinator a soutenu certaines des entreprises d’infrastructure les plus transformantes de la technologie. Comment cette expérience a-t-elle façonné votre approche de l’élargissement du produit et de la vision de SF Tensor ?
En entrant dans Y Combinator, je pensais que le pari que nous voulions faire alors était ambitieux. Après quelques semaines, notre définition de l’ambition avait considérablement changé, et nous avons doublé la mise sur un pari encore plus important. D’un autre côté, le sens de la communauté et de l’apprentissage que je peux appeler n’importe quelle entreprise ou personne et recevoir une réponse et des conseils en quelques heures ou jours a changé la façon dont nous abordons les problèmes et adoptons une approche nettement plus collaborative.
En regardant vers l’avenir, vous avez exprimé votre intérêt pour les modèles non LLM, la robotique et les données synthétiques. Comment ces domaines s’insèrent-ils dans votre vision à long terme pour l’entreprise ?
Les LLM sont absolument une technologie intéressante et auront une part intégrante dans la façon dont le monde sera à l’avenir, mais la raison pour laquelle ils sont si plus avancés que n’importe quelle autre zone de l’intelligence artificielle provient principalement du fait qu’il y a beaucoup d’argent investi dans leur développement, et qu’il y a suffisamment de personnes qui collaborent sur le problème pour qu’ils soient devenus assez optimisés. Si nous pouvons abaisser les barrières à l’entrée, en permettant aux chercheurs partout dans le pays et sur la planète, même ceux avec des ressources limitées et peu ou pas de connaissances en optimisation, de mener leurs recherches de la manière la plus économique et efficace possible, alors je pense que nous verrons une nouvelle génération de modèles émerger qui s’attaqueront à des problèmes pour lesquels les LLM ne sont pas adaptés, soit parce qu’ils interagissent avec le monde physique, soit parce qu’ils sont des problèmes qui ne peuvent pas être correctement exprimés dans le langage.
Que pensez-vous que la pile d’infrastructure d’intelligence artificielle ressemblera dans cinq ans — et où voyez-vous le rôle de SF Tensor à l’intérieur ?
Dans cinq ans, j’espère que de nombreuses entreprises auront développé et publié leurs propres puces spécialisées, et que les chercheurs pourront exploiter et utiliser ces puces sans avoir à écrire du code spécifiquement pour elles, idéalement sans même avoir besoin de savoir qu’elles existent. C’est l’avenir que nous travaillons à atteindre et que je crois que nous aurons un rôle important à jouer dans sa formation.
Merci pour cette grande interview, les lecteurs qui souhaitent en savoir plus peuvent visiter SF Tensor.


