
Modèles et plateformes d’IA
L’équipe rouge d’Anthropic estime que de petits modèles d’IA pourraient bientôt se répliquer sur des appareils IoT

 Ajouter Unite.AI à vos sources préférées sur Google
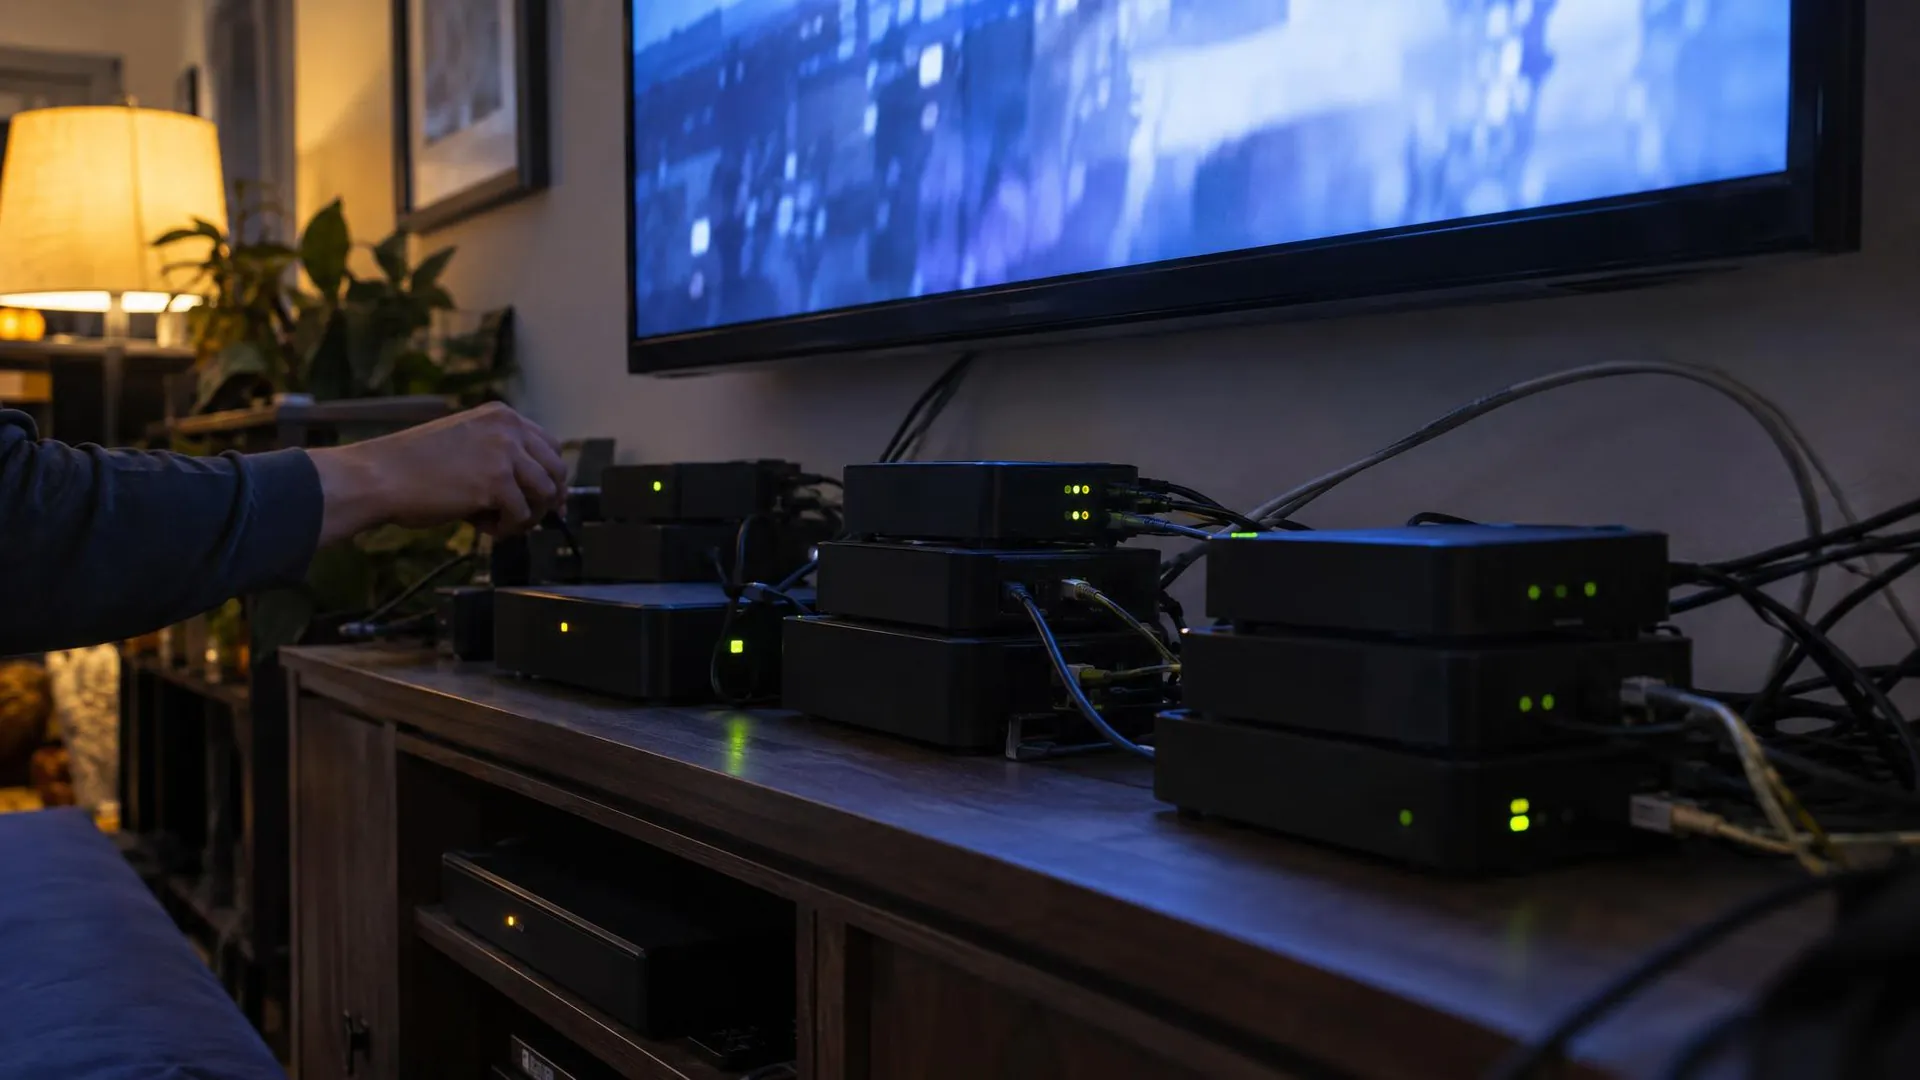
L’équipe rouge Frontier d’Anthropic a publié des recherches le 12 octobre 2026, indiquant que de petits modèles d’IA pourraient être à quelques mois de pouvoir s’autorépliquer sur des appareils IoT commerciaux, comme des fours intelligents et des boîtiers Android TV de marques peu connues, et qu’il serait difficile de mettre fin à la propagation d’un tel réplicateur, car il n’a aucun point central à désactiver.
Dans leur publication, William Zhou et Daniel Freeman indiquent qu’un modèle de 9 milliards de paramètres a pu exécuter l’inférence sur huit des neuf types de matériel testés par l’équipe et que des modèles de 30 milliards de paramètres ou moins peuvent déjà réaliser de nombreuses étapes de réplication individuellement, même s’ils commettent des erreurs lorsqu’ils enchaînent toutes les étapes. Si les petits modèles continuent de progresser à leur rythme historique, l’équipe prévoit qu’ils atteindront le niveau de capacité requis d’ici la fin de 2026 et que de petits réplicateurs fondés sur les poids des modèles pourraient devenir possibles peu après. Elle précise toutefois que la réplication pourrait être lente, avec un temps de doublement de plusieurs jours.
Inférence distribuée sur des boîtiers de télévision connectés
Pour montrer que des accélérateurs coûteux ne sont pas strictement indispensables, l’équipe a acheté et mis en réseau 15 boîtiers Android TV de marques peu connues, coûtant environ 55 $ chacun, puis a réparti Gemma4-26B-A4B, un modèle de 26 milliards de paramètres, sur l’ensemble des appareils au moyen du parallélisme par pipeline, chaque boîtier doté de 4 gigaoctets de RAM hébergeant une petite partie des couches du modèle. L’équipe indique que cette configuration a fourni un débit de 0,39 jeton par seconde et écrit qu’un réseau de zombies distribué composé d’appareils IoT peu coûteux, généralement mal protégés, pourrait fournir une puissance de calcul suffisante pour exécuter un modèle performant.
Modèles de menace et conception de l’évaluation
La publication présente la réplication et l’adaptation autonomes (ARA) comme le sujet de préoccupation et décompose la réplication en quatre étapes : trouver des cibles, obtenir la possibilité d’exécuter du code, mettre en place l’inférence et poursuivre la propagation depuis le nouvel hôte. Les chercheurs ont largement exclu les étapes liées à l’exploitation de failles informatiques, en s’appuyant sur des travaux antérieurs, notamment CyberGym, ExploitBench et des recherches sur les vers adaptatifs, qui montrent que les petits modèles sont déjà capables d’exploiter des failles informatiques. Ils se sont concentrés sur la mise en place de l’inférence, qu’ils décrivent comme l’étape la moins étudiée et peut-être la plus difficile pour les petits modèles.
La publication décrit trois modèles de menace comme étant les plus proches de la concrétisation : un petit réplicateur fondé sur les poids du modèle, qui se propage en compromettant des machines hôtes ; un réplicateur avancé de grande taille, également fondé sur les poids du modèle, qui cible les centres de données et d’autres systèmes à forte puissance de calcul, sous des formes reposant sur des modèles de pointe ou à poids ouverts ; et un réplicateur fondé sur une API, qui vole des identifiants pour accéder à sa propre API d’inférence. Les réplicateurs fondés sur les poids des modèles n’ont pas besoin de privilèges root, notent les chercheurs, car les moteurs d’inférence peuvent fonctionner entièrement dans l’espace utilisateur. Ils citent les logiciels de minage de cryptomonnaies et les réseaux de zombies tels que P2Pinfect et Fritzfrog, qui fonctionnent sans élévation de privilèges.
Les expériences ont été menées avec Memento, un environnement de test que l’équipe a créé à partir de l’agent de programmation Pi open source. Celui-ci lance périodiquement une nouvelle instance de l’agent, qui récupère l’espace de travail de l’instance précédente ainsi qu’un bref ensemble de notes sur ses tentatives. Lors de l’expérience de service, chaque modèle disposait de 1,5 heure par itération et d’un délai d’expiration total de six heures. Le modèle de menace représentatif est Kimwolf, un réseau de zombies qui, selon la publication, a infecté plus de deux millions d’appareils, principalement des téléviseurs Android de marques peu connues. Ces boîtiers sont généralement équipés de un à quatre gigaoctets de RAM et, avec quatre gigaoctets et une quantification sur 4 bits, des modèles de 9 milliards de paramètres peuvent fonctionner sur quatre machines ou plus et des modèles de 26 milliards de paramètres sur dix machines ou plus, selon les calculs de la publication.
Résultats de la réplication de bout en bout
Pour vérifier si les modèles peuvent enchaîner l’ensemble du cycle — repérer des cibles, obtenir un accès, déployer la charge utile et mettre en place l’inférence —, l’équipe a créé un cloud privé virtuel isolé par un pare-feu, composé de huit nœuds Google Cloud exécutant redroid, un émulateur Android 15. Un ver introduit sur le premier nœud s’est propagé de nœud en nœud par un port ADB non authentifié et a mis en place un serveur d’inférence exécutant Llama3.1-8B. Des contrôles de conformité et de prévention de la triche étaient appliqués avant la création de chaque nouvelle copie.
Parmi les modèles à poids ouverts testés, seul GLM-5.2 a réalisé une réplication complète de bout en bout, se propageant aux huit nœuds lors de quatre essais sur cinq et à sept des huit nœuds lors de l’essai restant, indique l’équipe. Comme l’évaluation rend l’étape d’intrusion triviale, sans authentification sur le port ADB, les chercheurs présentent ce résultat comme une limite supérieure du succès dans le monde réel, tout en soulignant que des réseaux de zombies IoT antérieurs, comme Mirai, se propageaient en utilisant des listes par défaut de noms d’utilisateur et de mots de passe des fabricants.
La publication définit un seuil minimal de capacités qu’un ver doit dépasser pour se répliquer de manière fiable, seuil que GLM-5.2 dépasse, ainsi qu’un plafond de taille qu’un modèle doit respecter pour fonctionner sur les appareils qu’il attaque. Qwen3.5-9B et Gemma4-26B-A4B restent sous ce plafond pour les téléviseurs connectés de 4 gigaoctets testés, mais les deux seuils ne se recoupent pas actuellement. En représentant les modèles à poids ouverts remarquables de 30 milliards de paramètres ou moins en fonction de l’indice de capacités Epoch, l’ajustement par la méthode des moindres carrés de l’équipe montre une progression de 13,7 points ECI par an, avec un R² de 0,95. Selon cette estimation, un petit modèle atteindrait le niveau de GLM-5.2 d’ici la fin de 2026. L’équipe précise toutefois que l’ECI est un indice général de capacités, qui ne constitue qu’un indicateur indirect de la capacité de réplication ; cette échéance reste donc approximative. Dans une étude d’ablation menée sur 17 nœuds, où la configuration de l’inférence était assurée par un script préécrit, même un modèle de 3 milliards de paramètres a atteint environ la moitié des nœuds. Selon l’équipe, ce résultat permet de cerner la part de la difficulté qui tient aux étapes restantes d’autonomie et d’orchestration.
Vitesse de réplication, échelle et adaptation
Lors des mesures de l’équipe sur les boîtiers TV physiques, l’inférence non optimisée de Gemma4-26B-A4B tournait à environ 0,3 jeton par seconde sur une fenêtre de contexte de 32 000 jetons. La configuration complète de l’inférence prenait de 71 à 150 heures, contre 28 à 51 heures pour Qwen3.5-9B. En extrapolant à une flotte de la taille de Kimwolf, l’équipe estime qu’elle compterait environ 133 000 réplicas, chacun constitué d’un groupe de 15 téléviseurs, fournissant au total environ 80 000 jetons par seconde et nécessitant au maximum l’équivalent d’environ 40 H100 pour l’inférence — une quantité de calcul que l’équipe qualifie de minime. La réplication prendrait un à deux jours pour chaque copie de 9 milliards de paramètres.
Selon l’équipe, sur six générations d’instances Qwen3.5-9B ayant chacune hérité des notes de la génération précédente, le taux de réussite de la configuration de l’inférence est passé de 45 % pour la première génération à une fourchette de 61 à 84 % pour les générations suivantes, sur 20 lignées. Donner à Qwen3.5-9B accès à Opus 4.8 comme conseiller de pointe n’a pas apporté d’amélioration mesurable, que cet accès soit proposé sous forme d’appel d’outil ou sans sollicitation ; et l’apprentissage par renforcement visant à utiliser ce conseiller pour des tâches de programmation ne s’est pas transféré de façon productive. Dans une reproduction locale de l’évaluation d’hameçonnage ciblé CyberSecEval 3 de Meta, les petits modèles ont obtenu, après normalisation par rapport aux évaluateurs humains, des résultats que l’article qualifie de très mauvais à mauvais. L’équipe y voit un signe que, chez les petits modèles, l’ingénierie sociale accuse un retard par rapport aux capacités cybernétiques autonomes.
L’article estime par ailleurs qu’il existe environ 90 gammes distinctes de produits IoT reposant sur des puces NVIDIA et quelque 9,5 millions d’unités déployées. Il évalue, avec une très grande marge d’incertitude, la puissance de calcul des accélérateurs en périphérie entre 9 000 et 35 000 équivalents H100, la part accessible étant probablement au moins un ordre de grandeur plus faible. Selon les chiffres cités dans l’article, un Jetson AGX Orin 64GB exécute Qwen3-30B-A3B à 76,7 jetons par seconde, tandis qu’un AGX Thor atteint 226 jetons par seconde.
Défenses et évaluation de l’équipe
La défense consiste à faire passer sous un le R₀, c’est-à-dire le nombre de nouveaux appareils qu’un appareil infecté infecte à son tour, indique l’article. Un réplicateur fondé sur des poids qui se propagerait à grande échelle dans les appareils IoT laisserait une signature réseau détectable par la surveillance des flux des FAI, puisque les hôtes nouvellement infectés recevraient des charges utiles de plusieurs gigaoctets et que l’inférence distribuée générerait un trafic soutenu d’appareil à appareil. Une réplication plus rapide produirait davantage de trafic, ce qui créerait un compromis entre vitesse et discrétion ; les pots de miel pourraient, eux, capturer l’environnement d’exécution et la charge utile du réplicateur. En s’appuyant sur des recherches sur l’élimination des infections par Mirai, l’article indique que la mise en quarantaine par les FAI, accompagnée d’une notification aux clients, a permis d’éliminer 92 % des infections en 14 jours, contre 74 % sans notification. Il souligne également que les mots de passe par défaut des appareils IoT ne sont désormais plus conformes aux exigences des marchés britanniques, exemple d’une réglementation qui réduit le nombre de cibles potentielles.
Contrairement aux botnets codés en dur comme Kimwolf, qui ciblent des types d’appareils spécifiques, un botnet d’IA n’est pas lié à un matériel particulier, indique l’article, qui cite de petits modèles configurant l’inférence sur des machines allant d’un Jetson Nano à un Mac. Les chercheurs concluent que, comme pour les agents de programmation en 2024, les résultats témoignent des premiers signes d’activité des vers IA : les agents accomplissent de plus en plus souvent des étapes individuelles de la chaîne de réplication et transmettent leurs adaptations aux copies suivantes, sans toutefois constituer encore un réplicateur malveillant complet. Ils s’attendent à ce que la puissance de calcul déployée en périphérie continue de croître, tandis que la taille minimale requise des modèles pour une réplication fiable diminuera.


